「電力1Wあたりの性能」とは? AIインフラの比べ方が変わった理由
要点
- 大規模なAIデータセンターは、置けるGPUの台数より先に「使える電力の上限」で規模が決まるため、比べる物差しが「1Wあたりの性能」に移っている。
- 推論なら「1秒あたりに出せるトークン数を、使った電力で割った値」で測り、電力の上限が固定なら、この値がそのまま売上の上限を決める。
- NVIDIAのMaxLPSは、ラックごとに確保したまま使われない電力や冷却の余分を減らし、同じ電力でより多くのGPUを動かそうとする設計と運用の考え方である。
基礎から
まず「何が足りないのか」から
AIの計算には、GPUという計算用の部品をたくさん並べた設備が使われます。NVIDIAはこうした設備を「AIファクトリー」と呼んでいます。工場が原料を製品に変えるように、電力を「トークン」(AIが読み書きする文字の単位)に変える工場、というたとえです。
少し前まで、設備の規模を決めていたのは「GPUを何台買えるか」でした。GPUは高価で、品薄でもあったからです。ところがいまは、もう一つの上限が先に効いてきています。電力です。
大きなデータセンターを建てるには、電力会社から受け取れる電力の枠(何メガワットまで、という契約や送電の上限)が必要です。この枠は、お金を積んでもすぐには増やせません。送電線や変電設備を新しく作るには年単位の時間がかかるからです。元記事は、こうした「土地・受電できる電力・建物と設備の器」をまとめてサイトの上限と捉え、その上限の中でどれだけAIの出力を出せるかが勝負だ、という立場をとっています。
家庭で言えば、ブレーカーの容量がすでに決まっている家を想像してください。家電をいくら買っても、同時に使える電力はブレーカーで決まります。だとすれば、比べるべきは「家電の値段」より「同じ電力で、どれだけの仕事をしてくれるか」です。AIインフラで起きているのは、これと同じ話です。
受け取った電力は、全部が計算に使われるわけではない
もう一つ大事なのは、受電した電力のすべてがGPUの計算に回るわけではない、という点です。冷却装置、電源の変換で生じる損失、ネットワーク機器、ストレージ、照明などにも電力は使われます。
元記事は代表的な例として、100メガワットの施設のうち、計算そのものに使われるのは約60%にとどまるという内訳を示しています。残りは施設側の負担、ラック内での損失、運用上のムダに消えるという見立てです(ただし、元記事自身が「代表的な一例」と断っている数字です)。
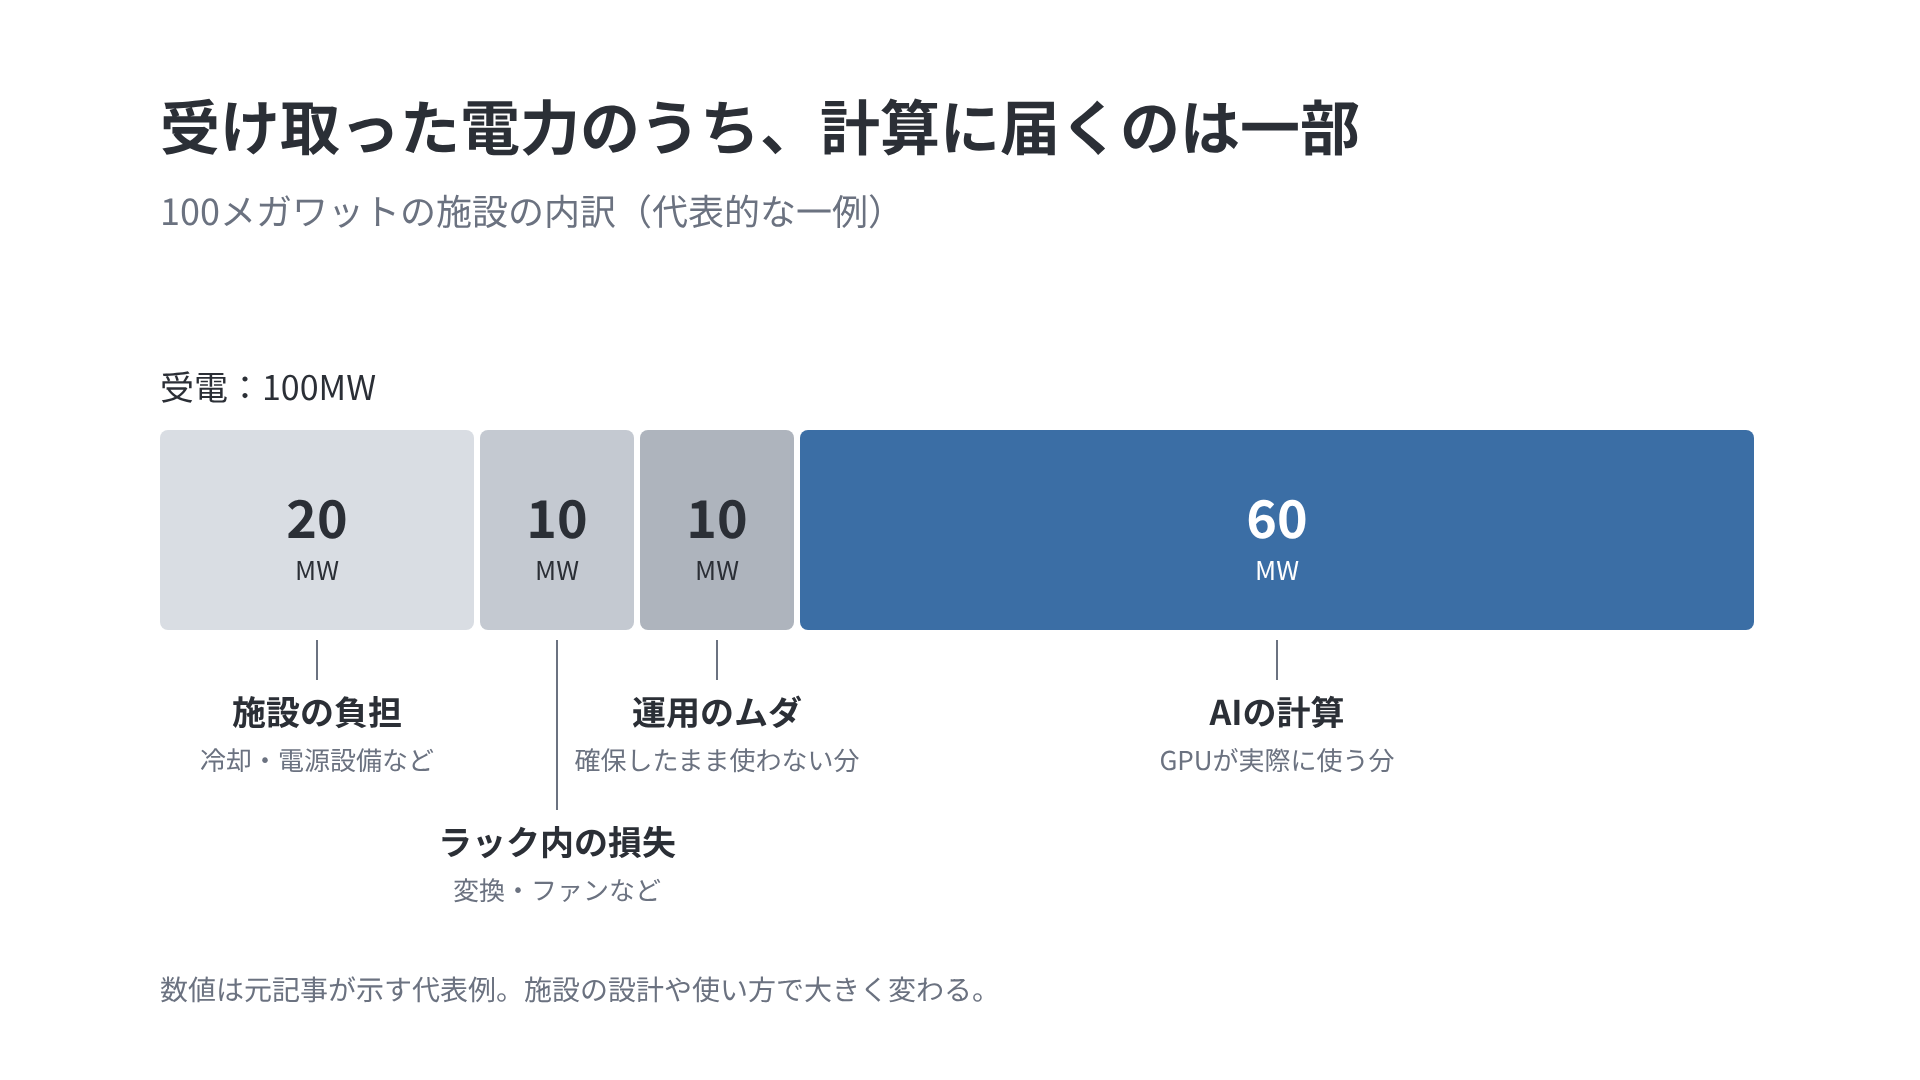
データセンターの世界には、この「余計な分」を表す指標として PUE(Power Usage Effectiveness、電力使用効率)があります。施設全体で使った電力を、IT機器が使った電力で割った値で、国際規格 ISO/IEC 30134-2 で定義されています。1.0に近いほど、冷却などの付帯設備に使う電力が少ないことを意味します。たとえばPUEが1.5なら、IT機器が1使うごとに、付帯設備がさらに0.5使っている計算です。
「1Wあたりの性能」は何で測るのか
ここで本題の「1Wあたりの性能(performance per watt)」です。「性能」の中身は、何に使うかで変わります。
- 学習(AIモデルを作る作業)なら、一定の電力でどれだけ計算を進められるか。
- 推論(できたモデルに質問して答えを出させる作業)なら、1秒あたりに出せるトークン数を、使った電力で割った値。元記事も、推論ではこの「トークン毎秒毎ワット」で効果を測れるとしています。
ポイントは、GPU単体のカタログ値ではなく、実際のアプリケーションを動かしたときの値で測ることです。同じGPUでも、設定や処理の組み方しだいで、同じ電力から出てくるトークンの量は大きく変わります。
なぜ経営の数字に直結するのか
ここまでくると、経営の数字とのつながりが見えてきます。
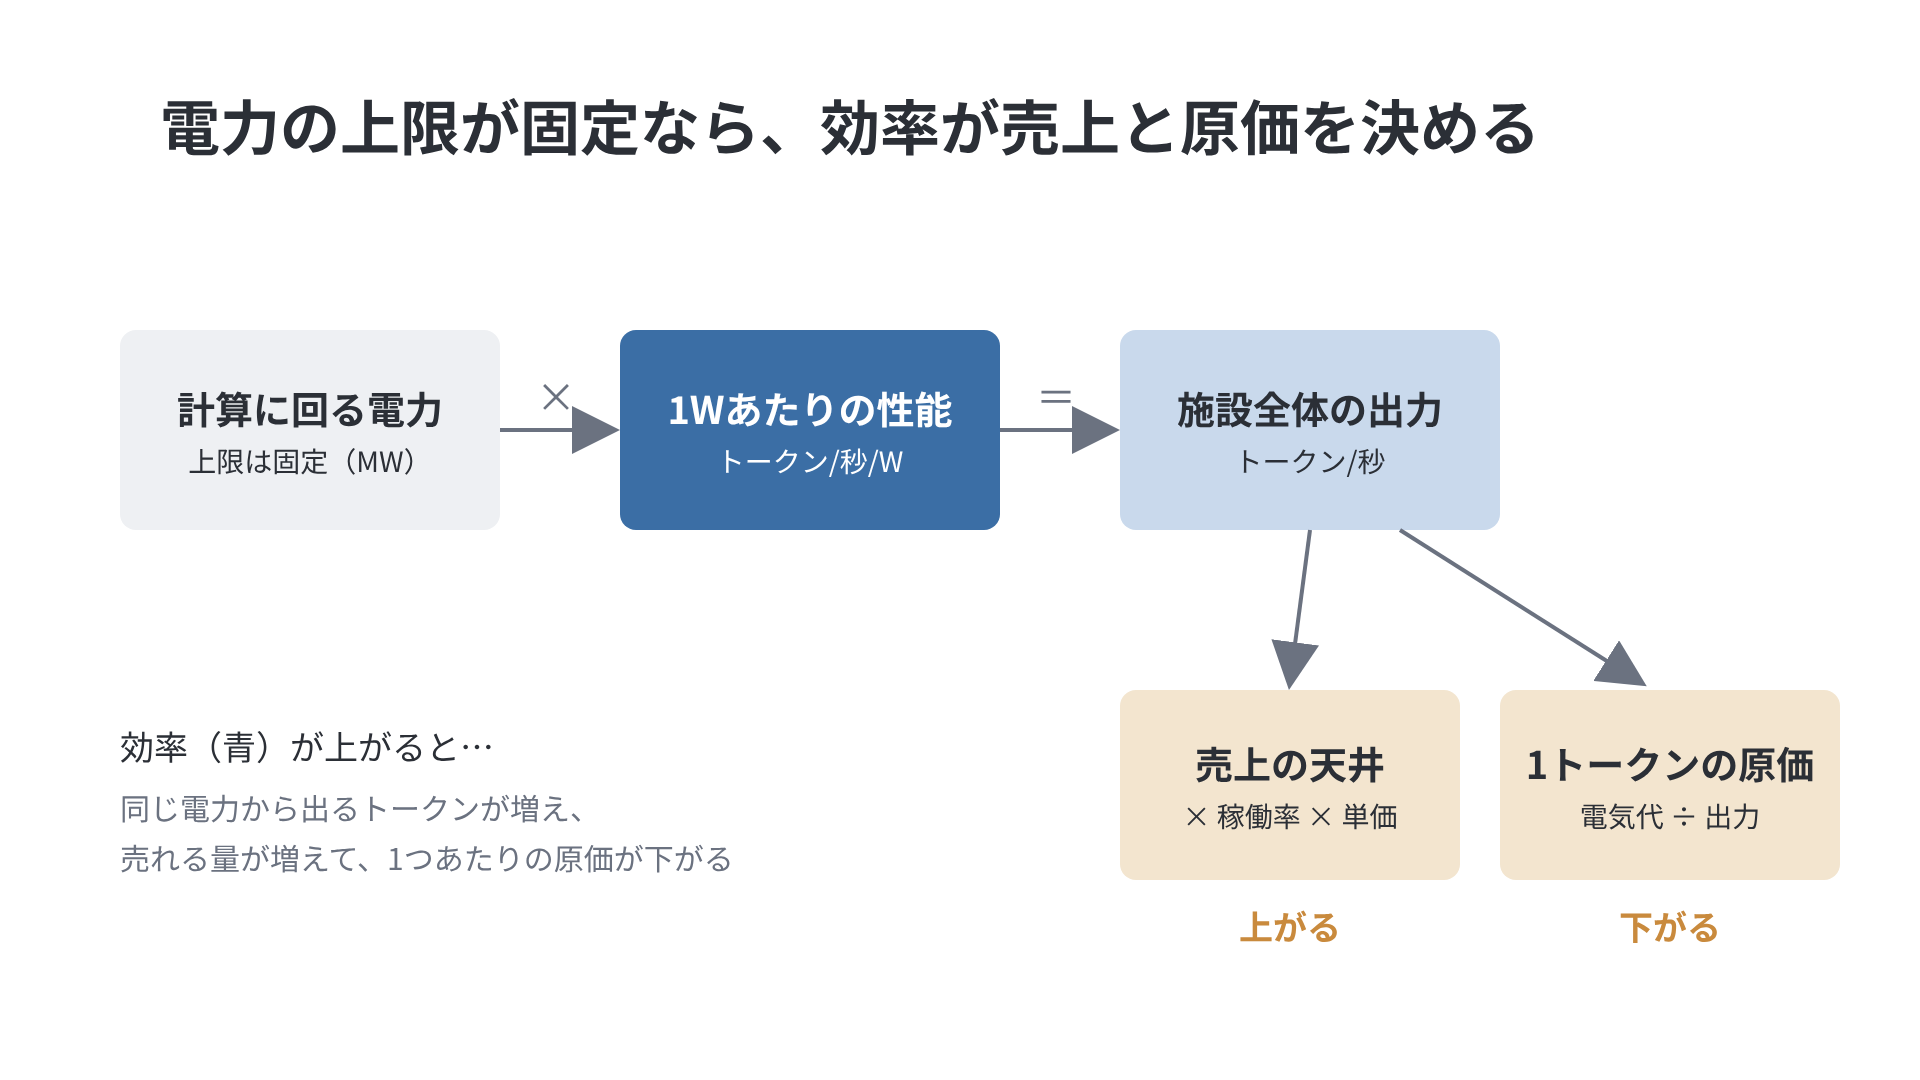
電力の枠が固定されているなら、その施設が1秒間に出せるトークンの上限は、ざっくり次の掛け算で決まります。
計算に回せる電力 × 1Wあたりのトークン生成速度 = 施設全体のトークン生成速度
そして推論を売る事業では、トークンを売ることが売上です。
施設全体のトークン生成速度 × 稼働率 × トークンの単価 = 売上
つまり、電力の上限が動かせないとき、1Wあたりの性能が上がることは、そのまま売上の上限が上がることを意味します。逆に、電気代は使った電力量に比例してかかるので、同じ電力でトークンを多く出せれば、トークン1つあたりの原価も下がります。売上の天井が上がり、原価が下がる。両方に効くので「経営の数字に直結する」と言われるわけです。
NVIDIAは別の技術ブログでも、性能あたりの電力効率を「電力が、収益を生む知能に変わる速さ」と位置づけ、AIインフラの決定的な指標だと述べています。メーカーの主張なので割り引いて読む必要はありますが、考え方の骨格は上の掛け算と同じです。
元記事が紹介する「MaxLPS」とは
元記事は、この1Wあたりの性能を施設全体で引き上げるための枠組みとして、NVIDIAの DSX MaxLPS を紹介しています。公式ドキュメントによれば、MaxLPSは施設の設計、電力を配り直すソフトウェア、GPU側の省電力の工夫を組み合わせ、決まった電力予算の中で1Wあたりの性能を最大にするための設計と運用の考え方です。中身は大きく3つに分けられます。
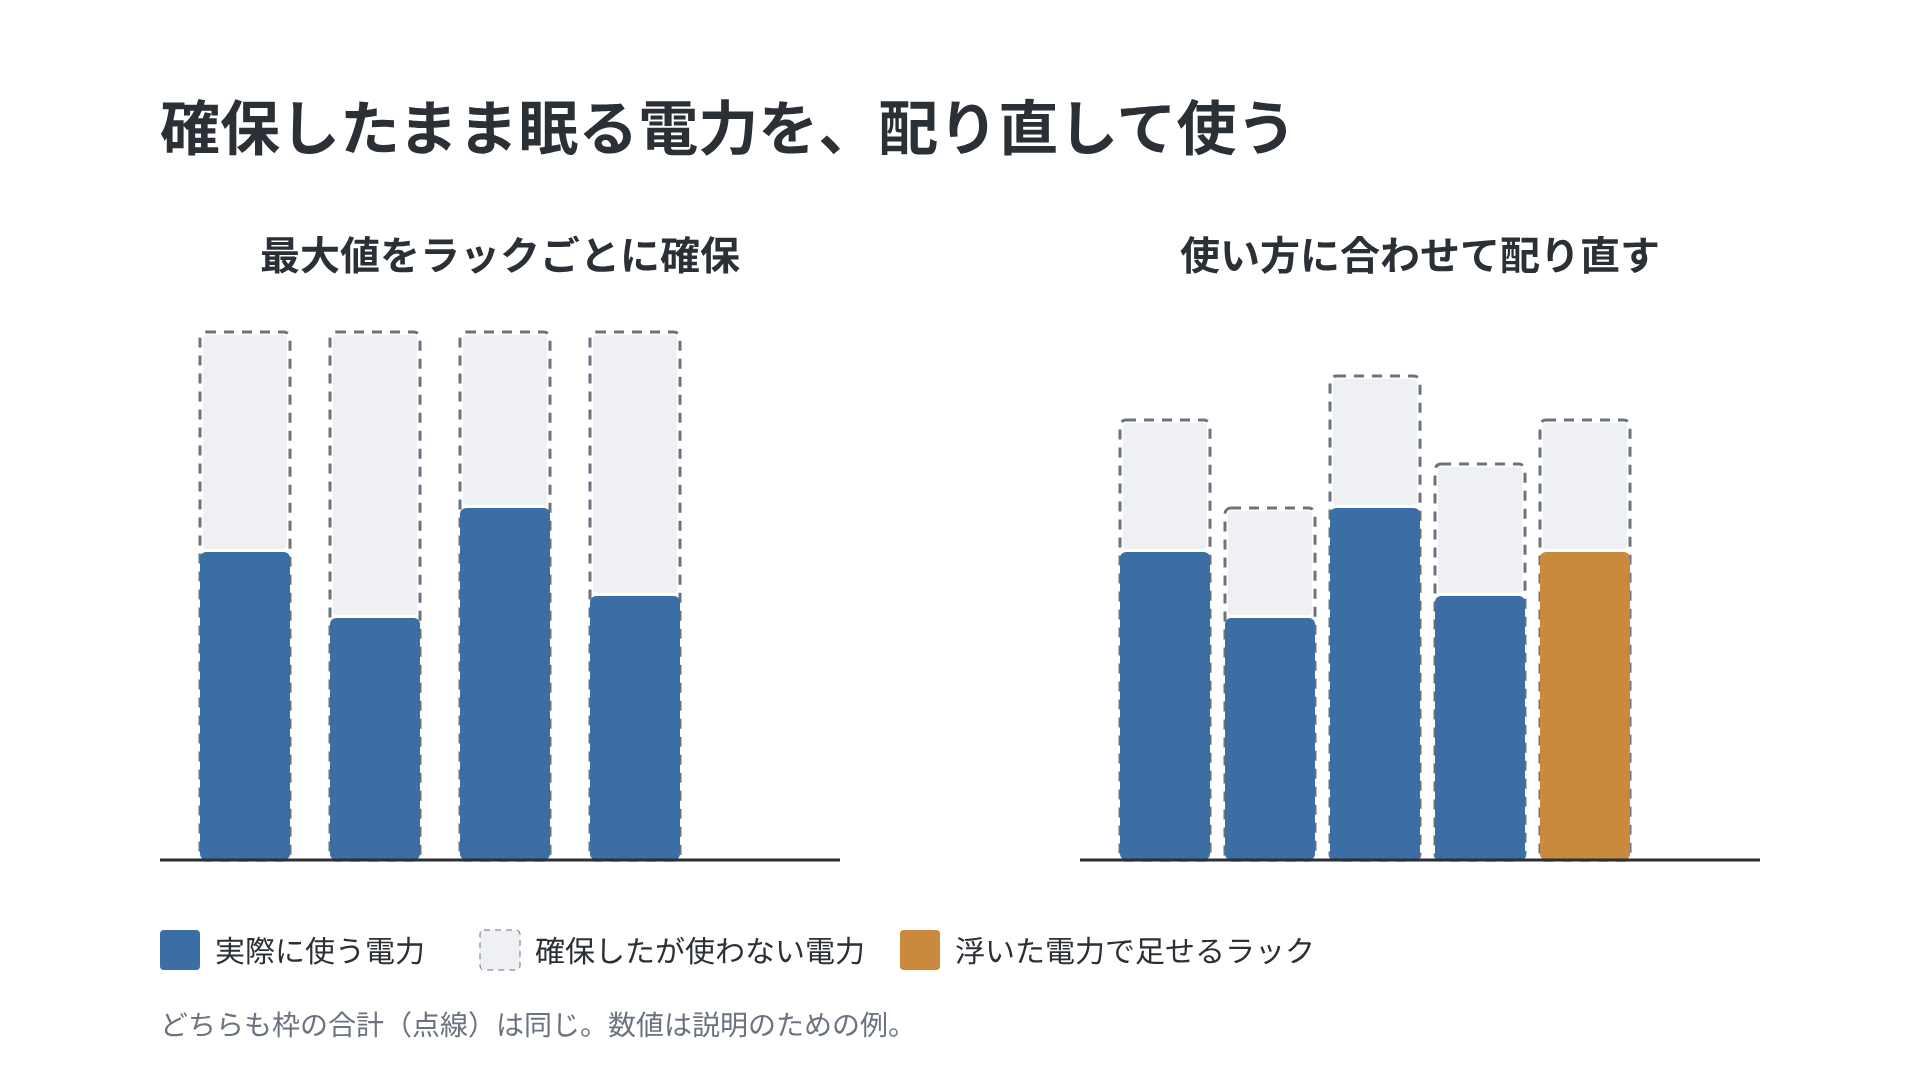
1. 余っている電力を、必要なところに回す。 従来は、ラック(GPUサーバーを収めた棚)ごとに「最大でこれだけ使うかもしれない」という電力をあらかじめ確保していました。しかし実際には、全ラックが同時に最大まで使うことはまれです。確保したのに使われない電力は、ほかに回せないまま眠ってしまいます。元記事はこれを「座礁した(stranded)電力」と呼んでいます。
MaxLPSの中心にある Dynamic Power Software(DPS)は、GPUやラックごとの消費電力を継続的に監視し、余っている分を、電力を必要としているGPUへ配り直します。施設全体の上限は守ったまま、眠っていた電力を起こして使う、という発想です。元記事の例では、こうして浮いた電力でラックをもう1台追加できる様子が示されています。
2. 仕事の種類に合わせて、GPUの設定を変える。 推論か学習か、メモリの読み書きが多い処理か計算が多い処理かによって、最適な電力や動作周波数の設定は違います。MaxLPSでは、こうした仕事の種類ごとに検証済みの設定(プロファイル)を用意し、まとめて適用します。元記事によれば、代表的な推論処理での検証(GB200 NVL72 と Vera Rubin NVL72)では、ラックあたりに確保する電力を2〜3割下げながら同等のスループットを保ち、同じ電力で置けるラックの数を3〜4割増やせたとしています。
3. 冷却に使う電力を減らす。 次世代のラックは、45℃の温水で冷やす前提で設計されています。冷却水の温度が高くてよいなら、外気で冷やせる時間が増え、電力を多く使う冷凍機(チラー)に頼る場面が減ります。冷却のために確保していた電力の一部を、計算に回せるようになるというわけです。
確かめたこと
元記事の主な主張を、元記事の本文・図の説明と照らし合わせました。確かめられたものは ✓、読むときに注意が要るものは ÷(obelos の印)を付けています。
| 主張 | 確かめた結果 | |
|---|---|---|
| ✓ | 100MWの施設のうち、AIの計算に回るのは約60MW(施設側20、ラック内の損失10、運用のムダ10) | 元記事の図1と一致。ただし元記事自身が「代表的な一例(illustrative)」としている |
| ✓ | 推論の効率は「トークン毎秒毎ワット」で測れる | 元記事の記述と一致 |
| ✓ | 固定的な割り当てでは170kWが眠り、540kWの枠の中でラックを1台増やせる | 元記事の図3の説明と一致 |
| ✓ | 確保電力を2〜3割下げても処理量を保ち、ラック数を3〜4割増やせた | GB200 NVL72で125kW→90kW(ラック39%増)、Vera Rubin NVL72で136kW→101kW(同35%増)。1Wあたりの性能はそれぞれ約1.5倍、約1.3〜1.4倍 |
| ✓ | 次世代ラックは45℃の温水で冷やす前提 | 元記事の記述と一致 |
| ÷ | 同じ電力で置けるGPUを「最大40%」増やせる | 実測ではなく、Vera Rubin NVL72についてのNVIDIAの見込み(projects) |
| ÷ | 電力を配り直すソフトウェア(DPS) | 元記事の時点では Developer Preview(試験提供)。すぐに本番で使える段階ではない |
| ÷ | 検証に使ったラックの機種 | 本文は「Vera Rubin NVL72とGB200 NVL72」、図4の説明は「GB200 NVL72とGB300 NVL72」で食い違っている |
| ÷ | 推論でのスループット向上は「試験が進行中」 | 公式ドキュメントにある記述として紹介したもので、ここでは再確認できていない |
全体として、仕組みの説明と検証の数字は元記事の中で筋が通っています。一方で、いちばん目を引く「最大40%」は見込みの数字で、中心となるソフトウェアもまだ試験提供の段階です。メーカーが自社の仕組みを紹介する記事として、数字は「条件がそろえば、ここまで届く可能性がある」と読むのが妥当です。
用語
- AIファクトリー:AIの計算に使うGPUを大量に並べた施設を、NVIDIAは「電力をトークンに変える工場」に見立ててこう呼ぶ。
- トークン:AIが文章を読み書きするときの最小単位。日本語ではおおむね1〜数文字。
- 推論/学習:推論は、できあがったAIに質問して答えを出させること。学習は、AIモデルを作ること。
- ラック:GPUサーバーを収める棚。電力や冷却は、ラック単位で割り当てることが多い。
- 座礁した電力(stranded power):確保してあるのに使われず、ほかにも回せないまま眠っている電力。
- PUE:施設全体の電力を、IT機器が使った電力で割った値。1.0に近いほど、冷却などに使う電力が少ない。
- スループット/レイテンシ:スループットは、一定時間に処理できる量。レイテンシは、1つの依頼に答えが返るまでの時間。
次に調べること
- PUEの国際規格(ISO/IEC 30134-2)が、何を「IT機器の電力」に含めるのか。冷却の仕方が変わると、PUEと1Wあたりの性能はどう連動するのか。
- 推論で電力を絞ったとき、レイテンシ(応答の速さ)とトークン毎ワットがどのような関係になるのか。公開されている測定結果を探す。
- 電力会社から受け取れる電力の枠は、実際にどのような手続きと期間で決まるのか。AI向けデータセンターの建設で、受電がどれほど足かせになっているのか。
参考
- Maximizing AI Factory Performance per Watt with NVIDIA DSX MaxLPS(NVIDIA Technical Blog)
- MaxLPS Overview(NVIDIA 公式ドキュメント)
- NVIDIA Dynamic Power Software ドキュメント(NVIDIA 公式ドキュメント)
- Scaling Token Factory Revenue and AI Efficiency by Maximizing Performance per Watt(NVIDIA Technical Blog)
- ISO/IEC 30134-2 Ed.2.0 概要(PUEの定義を定める国際規格)