NVIDIA CMXとは?KVキャッシュ専用の共有ストレージ階層「G3.5」の仕組みを解説
結論:NVIDIA CMXは、LLMのKVキャッシュだけを置くための共有ストレージで、ローカルSSD(G3)と共有ストレージ(G4)の間に「G3.5」という新しい階層を作ります。GPUポッド内のどのノードからもKVキャッシュを読み出せるため、処理するノードが変わっても再計算せずに済みます。
ポイントは次の3つです。
- 背景:エージェントの文脈は長く、セッションは長時間続き、途中で処理ノードが変わることもある。ローカルSSDに置いたKVキャッシュは、他のノードから読めない
- 仕組み:イーサネット接続のフラッシュストレージをKVキャッシュ専用に使い、BlueField-4(DPU)がI/Oを処理する。Dynamoがdecodeの前にKVキャッシュをGPU側へプリステージする
- 効果:NVIDIAは、長い文脈の推論で、従来のストレージより処理量と電力効率がいずれも最大5倍としている
この記事は「GPUメモリを無駄なく使う5つの方法」の5本目です。
前提:KVキャッシュの階層(G1〜G4)
NVIDIAは、KVキャッシュの置き場所を次の4階層で整理しています。
| 階層 | 置き場所 | 特徴 |
|---|---|---|
| G1 | GPUメモリ(HBM) | 生成中のKVキャッシュ。最も高速だが容量が小さい |
| G2 | CPUメモリ(システムRAM) | HBMと下位階層の間でKVキャッシュを中継・バッファする |
| G3 | ローカルSSD | 短期間に再利用するKVキャッシュ。ノードに固定され、管理とスケールが難しい |
| G4 | 共有のファイル・オブジェクトストレージ | 永続化すべきデータ。アクセスはミリ秒単位で、推論用途には最も非効率 |
NVIDIAによると、KVキャッシュがGPUから遠い階層に置かれるほど、1トークンあたりの遅延とエネルギーが増えます。
G3とG4の間には大きな差があります。
- G3:速いが、そのノードからしか使えない
- G4:どのノードからも使えるが、遅延が大きい
「どのノードからも使えて、しかも速い」階層がありませんでした。
KVキャッシュの置き場所が足りなくなった理由
NVIDIAは、次の3つの変化を挙げています。
- 文脈が長くなった:エージェントの文脈は数百万トークン規模に伸び、モデルは数兆パラメータに近づいている。KVキャッシュの量は文脈の長さに比例して増える
- 再計算の負担が増えた:履歴の再計算に必要な計算量は、文脈が長くなるほどKVキャッシュの量以上に急速に増える。そのため再利用が欠かせない
- セッションが長く続くようになった:エージェントは、複数のターン、ツール呼び出し、セッションにまたがって文脈を保持する必要がある
さらに、長いセッションの途中で処理ノードが変わることがあります。
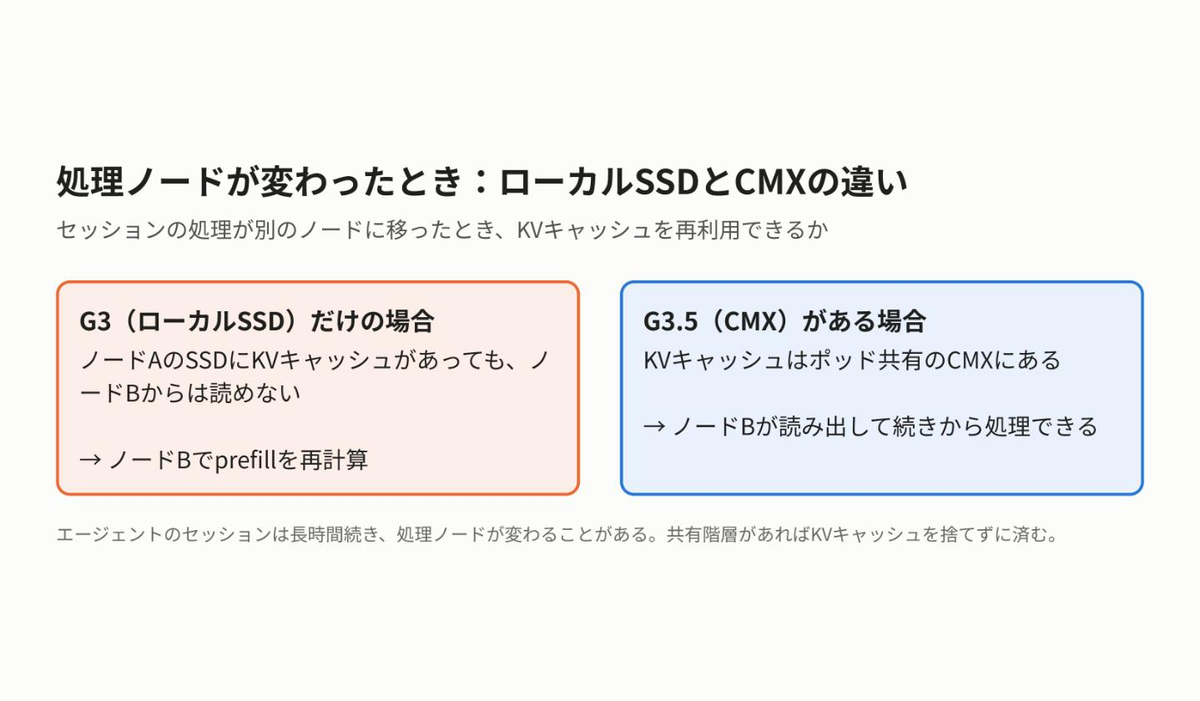
KVキャッシュがノードAのローカルSSDにしかない場合、ノードBでは読み出せず、prefillで再計算することになります。
CMX:G3とG4の間に共有階層を追加する
NVIDIAが用意したのがCMX(Context Memory eXtension、旧称ICMS:Inference Context Memory Storage)です。2026年1月のCESで発表されました。
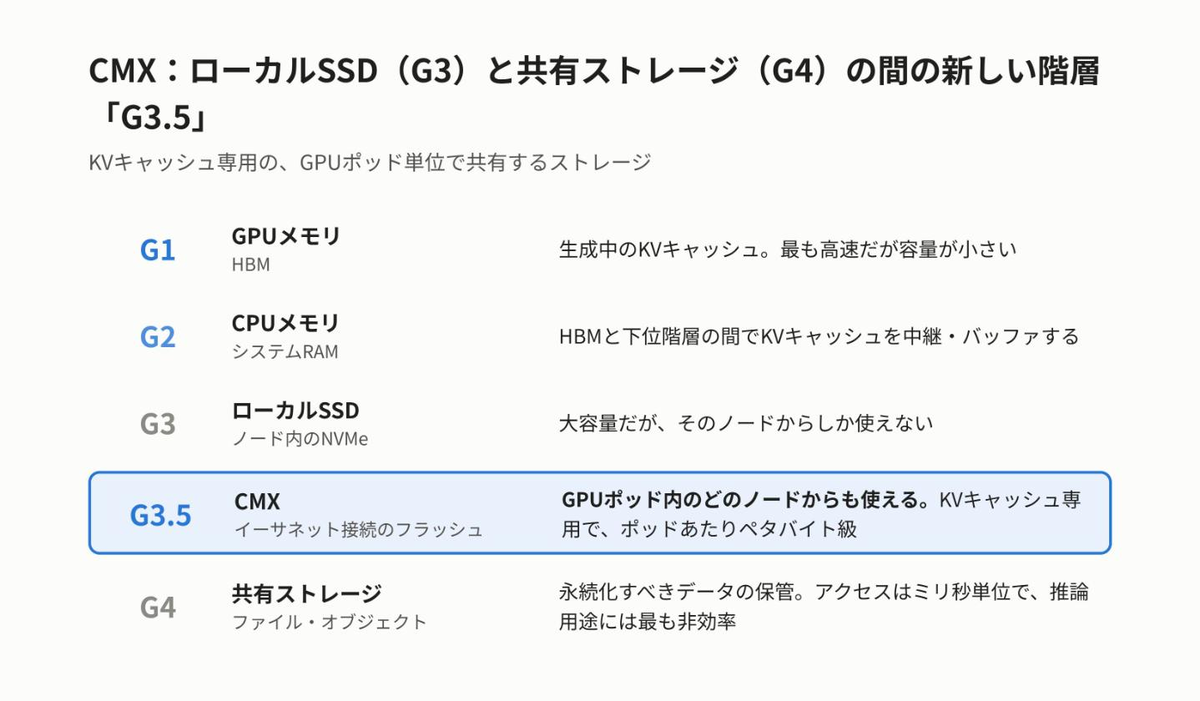
CMXの特徴は次のとおりです。
- GPUポッド内のどのノードからも使える:処理ノードが変わってもKVキャッシュを再利用できる
- KVキャッシュ専用:一時的で、繰り返し読み出されるKVキャッシュの特性に合わせて設計されている
- 大容量:GPUポッドあたりペタバイト級の共有容量を持つ
これにより、G4の共有ストレージは、非アクティブなセッションの状態、クエリ履歴、ログなど、永続化すべきデータの保管に専念できます。
CMXの構成
CMXは、Vera Rubinプラットフォームの一部であるNVIDIA STXリファレンスアーキテクチャ(BlueField-4 STXラック)の上に構築されています。
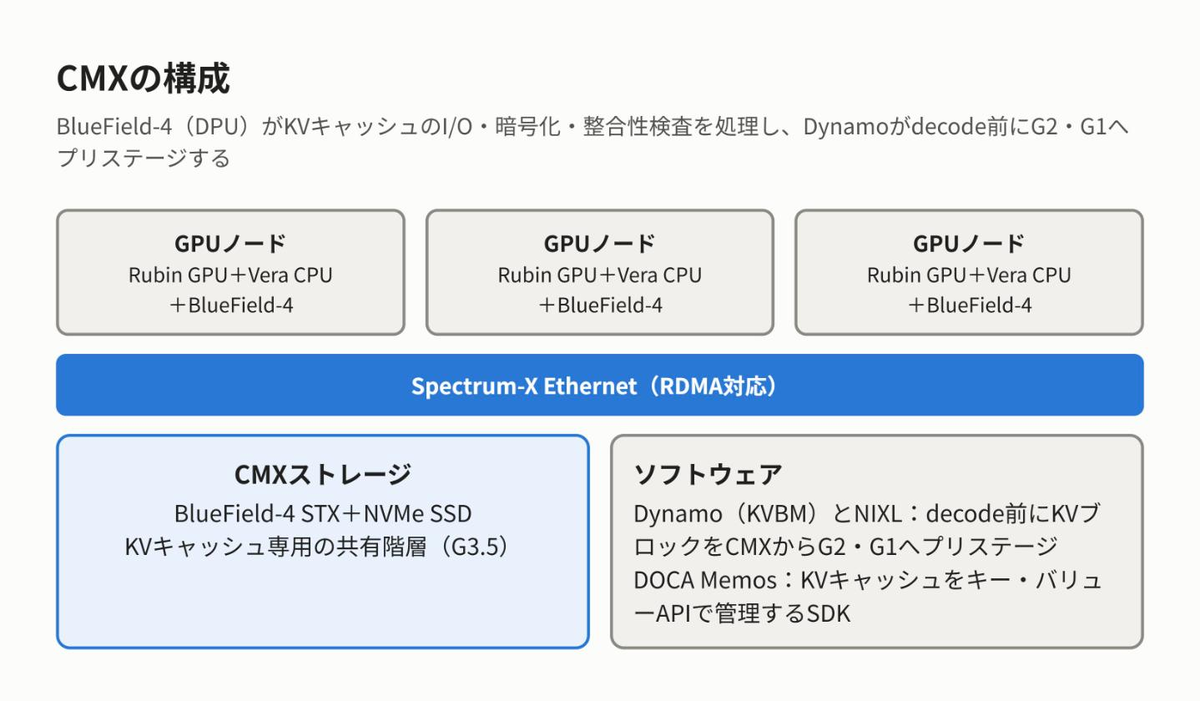
BlueField-4:KVキャッシュのI/Oを処理するDPU
BlueField-4は、ネットワーク接続、マルチコアCPU(Vera)、メモリを統合したDPU(データ処理用プロセッサー)です。
- KVキャッシュの読み書き(NVMe-oFやRDMAのプロトコル処理)を担当し、ホストCPUの負荷とメモリコピーを減らす
- 暗号化とCRCによるデータ整合性の検査を、専用のハードウェアでラインレートで処理する
- GPUノード側のDPUと、CMXストレージ側のコントローラーで処理を分担する
プリステージ
NVIDIA DynamoのKVブロックマネージャー(KVBM)は、転送ライブラリNIXLを使い、decodeの前に、KVブロックをCMXからG2(CPUメモリ)やG1(HBM)へ先に移しておきます。これにより、decodeの途中でKVキャッシュの読み込みを待って止まる時間が減ります。
その他の構成要素
- Spectrum-X Ethernet:RDMA対応のイーサネット。輻輳制御、アダプティブルーティング、ロスレスRoCEで遅延とジッターを抑える
- DOCA Memos:KVキャッシュをキー・バリューAPIで管理・共有するSDK。ストレージベンダーがG3.5階層に対応するためのオープンなインターフェースでもある
- Grove:KVキャッシュの位置を考慮してワークロードを配置するオーケストレーター
効果
NVIDIAは、長い文脈の推論とエージェントの処理について、次のように説明しています。
- 1秒あたりに生成できるトークン数が、従来のストレージと比べて最大5倍
- 電力効率が、汎用のストレージと比べて最大5倍
ただし、比較の前提となった構成や試験条件は示されていません。条件がそろったときの最大値として扱うのが妥当です。
制約と注意点
- 製品はこれから:CMXはVera Rubin世代の基盤の一部です。2026年5月時点の報道では、BlueField-4の出荷は2026年後半の予定で、CMXに基づく製品はまだ出ていないとされていました
- NVIDIAの設計への依存:ストレージベンダーにとっては、G3.5階層の仕様がNVIDIAのハードウェアとソフトウェアのロードマップに左右されます
- 再利用できるKVキャッシュがあってこそ:毎回異なる入力を処理する用途では、効果は限られます
まとめ
- KVキャッシュの置き場所には、「速いがノードに固定されたローカルSSD(G3)」と「共有できるが遅い共有ストレージ(G4)」の間に差があった
- CMXは、その間にKVキャッシュ専用の共有階層「G3.5」を追加し、GPUポッド内のどのノードからもKVキャッシュを読み出せるようにする
- BlueField-4がI/Oを処理し、Dynamoがdecodeの前にKVキャッシュをGPU側へプリステージする
- 長く続き、処理ノードが変わるエージェントのセッションほど効果が大きい
連載「GPUメモリを無駄なく使う5つの方法」
あわせて読みたい
- Agent Substrate:待機の長いエージェントを少数のPodで動かす
推論基盤のDynamoと連携して、エージェントを大規模に動かす仕組み
参考
- Five Ways NVIDIA Co-Design Maximizes the Value of Every Byte in the AI Factory(NVIDIA Technical Blog)
- Introducing the NVIDIA Inference Context Memory Storage Platform(NVIDIA Technical Blog)
- NVIDIA CMX context memory storage platform(NVIDIA)
- MinIO Spies Solution to GPU Memory Wall Problem with MemKV(HPCwire)