AI推論の性能は「メモリの使い方」で決まる――NVIDIAが示す、GPUメモリを無駄なく使う5つの方法【まとめ】
結論:これからのAI推論で効いてくるのは「GPUメモリをどれだけ積むか」より「1バイトあたりどれだけ役に立つ処理をさせるか」です。NVIDIAはその方法を、NVFP4、Wide-EP、Dynamo、Vera CPU、CMXの5つに整理しています。
ポイントは次の3つです。
- 背景:次世代GPUのVera Rubinでも、GPU1枚あたりのHBM容量は288GBで、前世代のGB300から増えない。容量ではなく使い方で差がつく
- HBMを使うもの:主に「モデルの重み」と「KVキャッシュ」の2つ。AIエージェントの普及で、KVキャッシュの比重が大きくなった
- 5つの方法:チップ、接続、ソフトウェアを組み合わせて設計(コデザイン)し、メモリの無駄を減らしている
この記事は5本の個別記事のまとめです。
前提:メモリの階層
GPUサーバーの記憶装置は、速いものほど容量が小さく高価です。NVIDIAは、KVキャッシュの置き場所を次の階層で整理しています。
| 階層 | 置き場所 | 特徴 |
|---|---|---|
| G1 | GPUメモリ(HBM) | GPUが直接計算に使う。最も高速だが容量が小さい |
| G2 | CPUメモリ | HBMより低速だが大容量 |
| G3 | ローカルSSD | 大容量だが、そのノードからしか使えない |
| G4 | 共有ストレージ | 最も大容量だが、最も遅い |
GPUが計算に使えるのはHBM上のデータだけです。HBMに載せられる量が、同時に処理できるリクエスト数や扱える文脈の長さを決めます。
HBMを使う2つのデータ
| データ | 内容 | 大きさの特徴 |
|---|---|---|
| モデルの重み | 学習済みのパラメータ | モデルが大きいほど大きい。数百GBになることもある |
| KVキャッシュ | 処理済みの入力の中間データ | 文脈が長いほど、同時に処理するリクエストが多いほど大きくなる |
AIエージェントは、長いシステムプロンプトや資料を入力したまま、ツール呼び出しを挟んで何度もLLMを呼び出します。そのためKVキャッシュが大きくなり、しかも長時間保持されます。
5つの方法の全体像
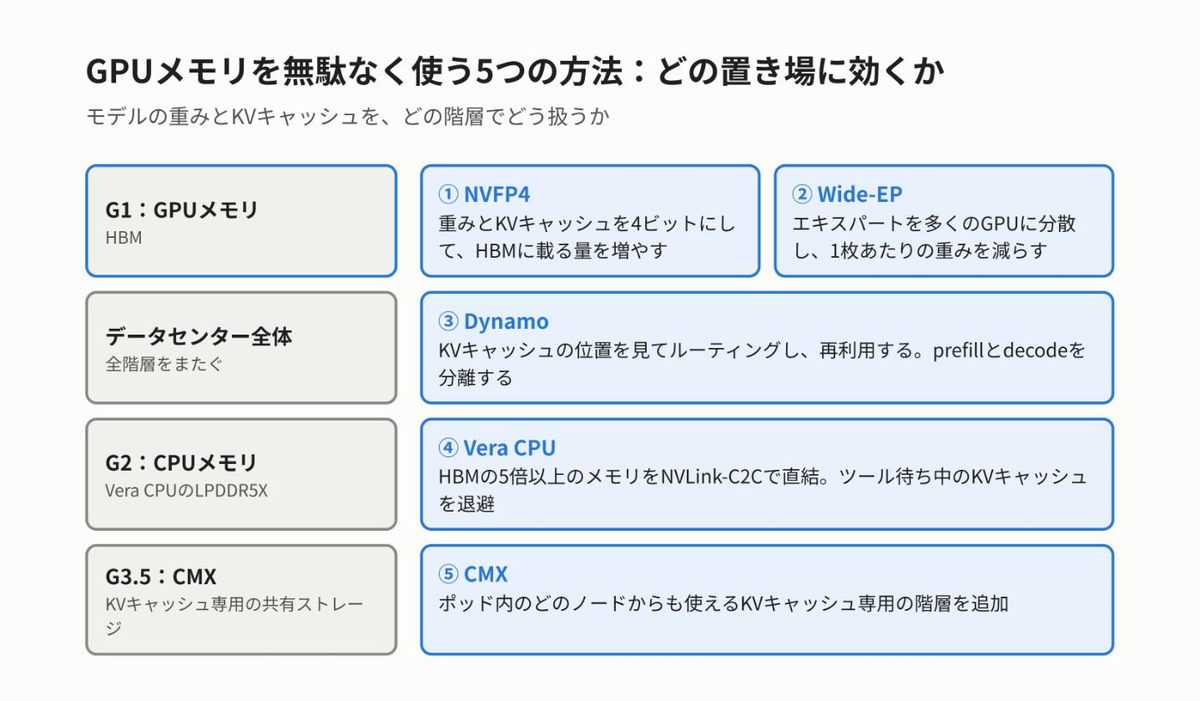
| 方法 | 内容 | 数字(NVIDIAの説明) |
|---|---|---|
| ① NVFP4 | 重みとKVキャッシュを4ビットにして、HBMに載る量を増やす | 重みは16ビット形式の約3.5分の1。精度の差は多くの項目で1ポイント以内 |
| ② Wide-EP | MoEモデルのエキスパートを多くのGPUに分散し、1枚あたりの重みを減らす | EP32はEP8よりGPU1枚あたりの出力量が最大1.8倍 |
| ③ Dynamo | KVキャッシュの位置を見てルーティングし、再利用する。prefillとdecodeを分離する | KVキャッシュをG1〜G4の4階層で管理 |
| ④ Vera CPU | 大容量のCPUメモリをGPUと高帯域で接続し、ツール待ち中のKVキャッシュを退避する | 最大1.5TBのメモリ、GPUとの帯域は毎秒1.8TB |
| ⑤ CMX | ポッド内のどのノードからも使えるKVキャッシュ専用の階層(G3.5)を追加する | 長い文脈の推論で、処理量と電力効率が最大5倍 |
① NVFP4
FP4(E2M1)で表せる値は15個しかありません。NVFP4は、16個の値ごとにFP8のスケールを、テンソル全体にFP32のスケールを付ける2段階の構造で、4ビットでも精度を保ちます。
② Wide-EP
MoEモデルは、計算に使うエキスパートは一部でも、全エキスパートの重みをHBMに置く必要があります。Wide-EPはエキスパートを数十枚のGPUに分散し、空いたHBMをKVキャッシュに回します。層ごとのオールツーオール通信を高速に処理するため、NVL72のような大きなNVLinkドメインが前提です。
→ 詳しくはWide-EPとは?MoEモデルのエキスパートを数十枚のGPUに分散して、メモリと計算を効率化するNVIDIAの方法
③ Dynamo
同じプレフィックスを持つリクエストは、KVキャッシュを再利用すればprefillを省けます。Dynamoは、KVキャッシュの位置とワーカーの負荷を見て振り分け、prefillとdecodeを別のGPUで処理し、KVキャッシュを4階層に分けて出し入れします。
④ Vera CPU
エージェントがツールの結果を待つ間も、KVキャッシュはHBMを占有しています。Vera CPUは、RubinのHBMの5倍以上のメモリを持ち、NVLink-C2Cで接続されています。ツール待ちの間だけKVキャッシュを退避し、HBMを別のリクエストに使います。
→ 詳しくはNVIDIA Vera CPUとは?1.5TBのメモリとNVLink-C2Cで、AIエージェントの待ち時間中のKVキャッシュを受け持つCPU
⑤ CMX
ローカルSSDに置いたKVキャッシュは、他のノードから読めません。CMXは、GPUポッド内で共有できるKVキャッシュ専用の階層(G3.5)を追加します。
→ 詳しくはNVIDIA CMXとは?KVキャッシュ専用の共有ストレージ階層「G3.5」の仕組みを解説
5つに共通する考え方
5つの方法に共通するのは、GPU単体の性能ではなく、チップ・接続・ソフトウェアを組み合わせて設計することで、メモリの使い方を改善している点です。
- NVFP4は、BlackwellのTensor Coreとセットで設計されている
- Wide-EPは、72枚のGPUを直結するNVLinkがあって初めて効果が出る
- Vera CPUへの退避は、NVLink-C2Cの帯域があって初めて実用になる
- DynamoとCMXは、ソフトウェア、ネットワーク、ストレージをまたいで動く
注意点
- 「最大1.8倍」「最大5倍」などの数字は、特定のモデルと測定条件での最大値です
- ストレージの速度の数字には、ストレージベンダーによる検証のものが多く含まれます
- Vera RubinやCMXは次世代の基盤で、2026年11月時点では製品が出そろっていないものもあります
まとめ
- GPUのHBMは世代が進んでも容量が大きく増えないため、使い方が性能を左右する
- HBMを使うのは主に「モデルの重み」と「KVキャッシュ」で、エージェントの普及でKVキャッシュの比重が増えている
- NVIDIAは、NVFP4、Wide-EP、Dynamo、Vera CPU、CMXの5つで、メモリの無駄を減らしている
連載「GPUメモリを無駄なく使う5つの方法」
あわせて読みたい
- Agent Substrate:待機の長いエージェントを少数のPodで動かす
推論基盤のDynamoと連携して、エージェントを大規模に動かす仕組み - NVIDIA Snapshot:推論サーバーの起動を数十秒にする
推論サーバーのGPUメモリの状態を保存・復元する仕組み - FLUX 3 Image Klein:画像生成をBlackwellで3〜4倍高速化
NVFP4とFP8を画像生成モデルで使った例
参考