Nemotron 3.5 Bolt 74B-A9B:2ビットで24GBに収めた74B MoEモデルの作り方
NVIDIAが2026年10月15日に公開した「Nemotron 3.5 Bolt 74B-A9B 24GB」は、総パラメータ740億のMoEモデルを約24GBに収め、RTX Spark搭載ノートPCやDGX Sparkでローカル実行できるようにしたオープンモデルです。2ビットでも精度が崩れない理由は、学習後に重みを丸めるのではなく、2ビット化を前提にモデルを圧縮・再学習している点にあります。
本記事では、Sam Witteveen氏の解説動画「NVIDIA’s Secret 2 Bit Model」(2026年11月9日公開)の内容を軸に、NVIDIAの技術ページ、Hugging Faceのモデル情報、DGX Sparkでの第三者実測結果を加えて、仕組みと実力を整理します。
要点は次の3つです。
- メモリ要件:BF16で約150GBある74Bモデルを、層ごとに2/4/8ビットを使い分ける混合精度で約24GBに圧縮している
- 精度:BF16版との差はおおむね0〜5ポイントに収まり、エージェント系ベンチマークでは4ビットの26B〜35Bクラスを上回る
- 制約:生成速度は4ビットの小型MoEより遅く、同時リクエストが増えると1リクエストあたりの速度が大きく落ちる。1人で使うローカルエージェント向けのモデル
Nemotron 3.5 Boltの基本仕様
| 項目 | 内容 |
|---|---|
| 正式名 | NVIDIA Nemotron 3.5 Bolt 74B-A9B 24GB |
| 公開日 | 2026年10月15日 |
| アーキテクチャ | ハイブリッドMamba-Transformer+MoE(混合専門家) |
| パラメータ | 総数74B、1トークンあたりのアクティブ9B |
| 親モデル | Nemotron 3.5 Super VL(120B-A12B) |
| 入力 | テキスト・画像・動画 |
| コンテキスト長 | 最大256K(262,144)トークン |
| 重みのサイズ | 約24GB(2ビット主体の混合精度) |
| 想定環境 | RTX Spark搭載PC、DGX Spark、DGX Station、24GB以上のGPU |
| 対応ランタイム | llama.cpp、Ollama、LM Studio、Unsloth、vLLM |
| ライセンス | OpenMDW-1.1(オープンウェイト) |
同時に公開されたNemotron 3.5ファミリーの中での位置づけは次のとおりです。
| モデル | 規模 | 用途 |
|---|---|---|
| Nemotron 3.5 Super VL | 120B-A12B | サーバー向け。文書・画像・動画を扱う高精度エージェント |
| Nemotron 3.5 Lightning | 30B-A3B | テキスト処理を高スループットで実行 |
| Nemotron 3.5 Bolt 74B-A9B 24GB | 74B-A9B | 24GBメモリで動くローカルエージェント |
| Nemotron 3.5 Bolt E4B | 4GB | 会話エージェント向けの超小型版(10月23日公開) |
BoltはRTX Spark搭載ノートPCの発売(2026年10月16日国内発売)に合わせて設計されたモデルで、他のアプリケーションと同時に動かしながら日常的なエージェント処理をローカルで実行することを狙っています。
前提知識1:パラメータ数とメモリ量の関係
LLMの重みは数値の集まりで、1個の数値を何ビットで表すかによって必要なメモリ量が決まります。74Bモデルで計算すると次のようになります。
| 1重みあたりのビット数 | 計算 | 重みのサイズ |
|---|---|---|
| 16ビット(BF16) | 74B × 2バイト | 約148GB |
| 4ビット | 74B × 0.5バイト | 約37GB |
| 2ビット | 74B × 0.25バイト | 約18.5GB |
4ビットでも37GBあり、24GBには収まりません。24GBに収めつつKVキャッシュや画像エンコーダーの領域を残すには、重みの大部分を2ビットまで落とす必要があります。実際にDGX Sparkで計測された値は、本体の重みが20.51GiB、画像処理用のmmprojが1.61GiBでした。
前提知識2:MoEでは「総パラメータ」と「アクティブパラメータ」が別物
MoE(Mixture of Experts)は、FFN層を多数の「エキスパート」に分割し、トークンごとにルーターが一部のエキスパートだけを選んで計算する構造です。
- 総パラメータ(74B):すべてのエキスパートを合計した量。どのエキスパートが選ばれるかは事前に分からないため、全量をメモリに置く必要がある。メモリ要件を決める数字
- アクティブパラメータ(9B):1トークンの計算で実際に使う量。計算量と生成速度を決める数字
つまりMoEは「メモリは大きく、計算は軽い」モデルです。計算が9B相当で済む一方、メモリには74B分を置く必要があるため、ローカル環境ではメモリ量がボトルネックになります。Boltが2ビット化に踏み込んだ理由はここにあります。
なお、Nemotron 3.5はTransformerの注意機構(Attention)に加えて、状態空間モデルのMamba層を組み合わせたハイブリッド構成です。Mamba層は系列長に対して計算量が線形に増えるため、256Kの長文脈を扱いやすくなります。
前提知識3:なぜ通常の量子化は4ビットを下回ると崩れるのか
一般的な量子化はPTQ(Post-Training Quantization:学習後量子化)です。学習済みのモデルの重みを、後から少ないビット数の値に丸めます。
2ビットで表現できる値は1ブロックあたり4段階しかありません。16ビットで細かく調整されていた重みを4段階に丸めると、各層で生じる誤差が層を重ねるごとに蓄積し、出力が大きくずれます。4ビット(16段階)までは実用的な精度を保てても、それを下回ると急激に性能が落ちるのはこのためです。
これに対してQAT(Quantization-Aware Training:量子化を考慮した学習)は、量子化した状態で順伝播を計算しながら学習を続け、丸め誤差を前提に重みを調整し直します。Boltが採用しているQAD(Quantization-Aware Distillation:量子化を考慮した蒸留)はその発展形で、量子化したモデルを生徒とし、量子化前の高精度モデルの出力分布に近づくように学習させます。正解ラベルだけでなく教師モデルの確率分布全体を手本にするため、失われた精度を効率よく取り戻せます。
NVIDIAは技術ページで、ParetoQやQuestといった先行研究を引用し、「同じメモリ量なら、高ビットの小さいモデルより、1〜2ビットの大きいモデルのほうが精度とサイズの釣り合いが良い」という知見を示しています。Boltの結果もこの知見と整合すると述べています。
24GBに収めるまでの工程
Boltは、親モデルであるNemotron 3.5 Super VL(120B-A12B)から次の工程で作られています。
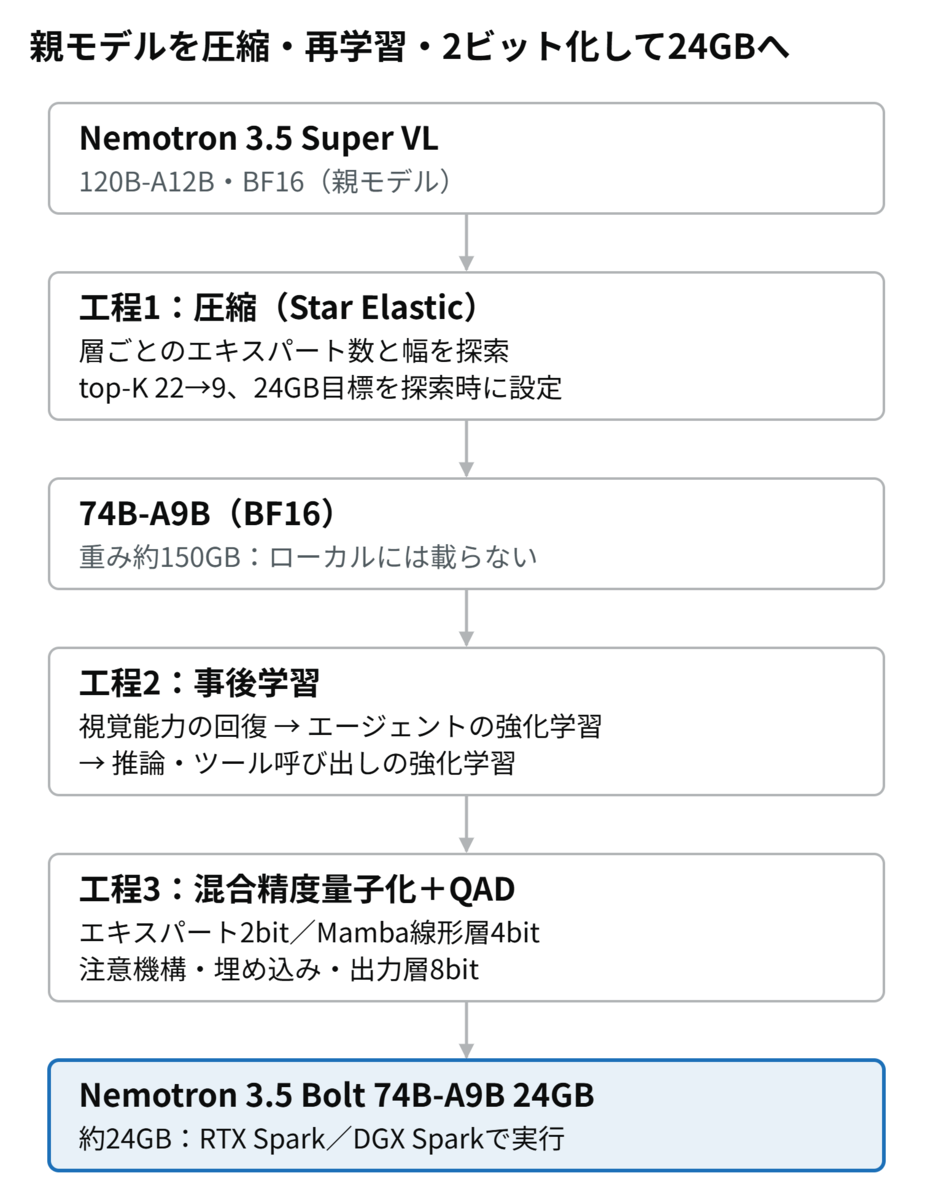
工程1:圧縮(Star Elastic)
NVIDIA独自の圧縮フレームワーク「Star Elastic」で、層ごとに残すエキスパート数とMoE中間層の幅を探索します。ルーターの情報を手がかりに、予算(目標サイズ)に応じた構成を選ぶ仕組みです。
- 総パラメータ:120B → 74B
- アクティブパラメータ:12B → 9B
- 1トークンあたりに選ぶエキスパート数(top-K):22 → 9
重要なのは、「量子化後に24GBに収まること」を探索の段階で目標に設定している点です。後工程の2ビット化を見越して、圧縮後の構成そのものを決めています。動画で説明されている「最初から2ビット化を前提にエキスパートを削る」とはこのことです。
工程2:事後学習
圧縮で落ちた能力を取り戻すため、次の順に学習を重ねます。
- 画像・動画の理解能力(視覚能力)の回復
- シミュレーション環境での強化学習によるエージェント動作の習得
- 推論とツール呼び出しを強化する最終段の強化学習
工程3:混合精度量子化とQAD
最後に重みを量子化し、QADで精度を回復させます。量子化の対象は重みのみで、層の種類ごとにビット数を変えています。
混合精度:どの層を何ビットにしているか
| 対象 | 形式 | ビット数 |
|---|---|---|
| ルーテッド/共有エキスパートのFC1・FC2(重みの大部分) | IQ2_XXS | 約2ビット(2.0625ビット/要素) |
| Mamba層の線形層 | NVFP4 | 4ビット |
| 注意機構、トークン埋め込み、出力層(lm_head)、Latent MoE | Q8_0 | 8ビット |
設計の考え方は明確です。重みの大半を占めるエキスパートを2ビットにして容量を大きく削り、モデル全体の振る舞いに影響する注意機構・埋め込み・出力層は8ビットに残しています。IQ2_XXSはllama.cppの量子化形式で、ブロック単位のスケール情報を含むため1要素あたり2.0625ビットになります。NVFP4はNVIDIA Blackwell世代がハードウェアで扱える4ビット浮動小数点形式です。
ベンチマーク:BF16版との差と競合モデルとの比較
NVIDIAが公開した値の主要部分です。比較対象は「4ビット量子化で24GBに収まるオープンMoEモデル」から選ばれています。
| ベンチマーク | Bolt 24GB | Bolt BF16 | Qwen3.6-35B-A3B | Gemma 4 26B-A4B |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 50.98 | 53.93 | 44.38 | 37.22 |
| GPQA Diamond | 86.43 | 88.83 | 83.4 | 79.61 |
| Humanity’s Last Exam(ツールなし) | 25.3 | 28.73 | 19.56 | 17.42 |
| SciCode | 41.02 | 44.49 | 35.33 | 40.28 |
| BrowseComp | 66.75 | 70 | 48.74 | 26.3 |
| PinchBench | 87.82 | 90.35 | 88.07 | 74.7 |
| MCP-Atlas | 52.2 | 55.6 | 51.2 | — |
| WebArena(vision) | 50.86 | 50.25 | 36.6 | 38.2 |
| AA-Omniscience 正答率 | 16.9 | 21.8 | 19.47 | 22.17 |
| AA-Omniscience 非ハルシネーション | 61.27 | 56.14 | 65.85 | 14.22 |
読み取れることは3点です。
- 2ビット化による低下は小さい:BF16版との差は多くの項目で2〜4ポイント。WebArenaとτ³-bench(Banking、両者とも17.01)では差がない
- エージェント系で強い:BrowseComp(Web調査)で66.75と、Qwen3.6-35B-A3Bの48.74を18ポイント上回る。公開リーダーボードでは、同程度のメモリ量のモデルの中でPinchBench 1位、WebArena 2位、BrowseComp 2位
- 知識の想起は落ちる:AA-Omniscienceの正答率はBF16の21.8から16.9へ4.9ポイント低下し、Gemma 4を下回る。一方で非ハルシネーション率は56.14から61.27へ上がっており、知らないことを答えずに控える傾向が強まっている
生成速度
NVIDIA公表値(RTX Spark、llama.cpp)
Surface Laptop Ultra(RTX Spark、メモリ128GB、Windows 11 ARM64)での計測値です。
| モデル | 生成速度(コーディング) | エージェント処理の再生時間 |
|---|---|---|
| Nemotron 3.5 Bolt(IQ2_XXS+LiLiCorr) | 83.99トークン/秒 | 600.80秒 |
| Qwen3.6 35B-A3B(4ビット+MTP) | 96.63トークン/秒 | 453.97秒 |
| Gemma 4 26B-A4B(4ビット+MTP) | 100.56トークン/秒 | 480.68秒 |
| Qwen3.8 27B(4ビット+DFlash) | 28.26トークン/秒 | 1043.28秒 |
Boltのアクティブパラメータは9Bで、Qwen3.6(3B)やGemma 4(4B)より計算量が多いため、速度では後れを取ります。NVIDIAは「80トークン/秒以上」を設計目標にしており、それを達成するために1.13Bパラメータの投機的デコーディング用ドラフトモデル「LiLiCorr」を同時に公開しています。LiLiCorrは7トークン先まで下書きし、平均4.68トークン(貪欲デコード時)が本体モデルに採用されます。
DGX Sparkでの第三者実測(llama.cpp)
クラスメソッドが公開翌日にDGX Spark(GB10、統合メモリ128GB)で計測した結果です。
| 条件 | 1リクエストあたり | 合計 |
|---|---|---|
| 投機的デコーディングなし、同時1 | 39.47トークン/秒 | 39.47トークン/秒 |
| DFlashあり、同時1 | 61.61トークン/秒 | 61.61トークン/秒 |
| 投機的デコーディングなし、同時4 | 21.34トークン/秒 | 82.08トークン/秒 |
| 投機的デコーディングなし、同時8 | 13.26トークン/秒 | 102.45トークン/秒 |
常駐メモリはDFlashなしで27.9GiB、ありで31.4GiBでした。同時8リクエストでは1リクエストあたりの速度が単独時の約3分の1まで落ちるため、チームで共有するサーバー用途には向きません。
実機での動作検証
Sam Witteveen氏の動画では、ローカル環境でツール呼び出しを伴うエージェント処理を実行し、プロンプトインジェクションへの耐性も確認しています。一部に小さな誤りはあるものの、全体としてエージェントとして機能すると評価しています。親モデルの120Bと比べれば賢さと速度に差はありますが、24GBというハードウェア制約の中で動くモデルとしては実用的という結論です。
クラスメソッドの検証でも、2ビット化による明確な精度低下は見られていません。
| 検証項目 | 結果 |
|---|---|
| 日本語タスク(9問) | 8/9正解(Lightning 8/9、GLM 2ビット版 6/9) |
| コード生成(5問・49テスト) | 5/5すべて合格(Lightning、GLMは4/5) |
| バグ修正(12テスト) | 全テスト合格(5ターン、43.0秒) |
| 基本的なツール呼び出し(5件) | 5/5成功、不正な形式の呼び出しなし |
| エージェント部品のツール選択 | 4/6(Lightningは5/6) |
| 画像理解(3件) | 3/3成功。点検記録のOCRで文字誤り率0.0 |
推論(thinking)の設定で処理量が大きく変わる点も確認されています。日本語タスクでは、highで約13,400トークン・356秒、mediumで約3,200トークン・91秒を消費し、どちらも8/9正解でした。offでは約960トークンで7/9です。出力形式の一貫性はoffで0/5まで落ちるため、エージェント用途ではmediumが現実的な設定です。
使いどころと制約
向いている用途
- 24GB級のGPU、またはRTX Spark/DGX Sparkで、1人がローカルでコーディングエージェントやWeb調査エージェントを動かす用途
- 他のアプリケーションとメモリを共有しながら、クラウドに出せないデータをローカルで処理する用途
- 画像・動画を含む入力を、256Kの長文脈で扱う用途
制約
- 生成速度は4ビットの26B〜35Bクラスより遅い。速度を最優先するならQwen3.6やGemma 4が有利
- 同時リクエストに弱く、チームで共有する推論サーバーにはLightning(30B-A3B)のほうが適する
- ファインチューニングの土台にはしにくい。BF16版は約150GBあり、ローカル環境に載らない
- 知識の想起(AA-Omniscience正答率)はBF16版から約5ポイント落ちる。事実確認が重要な用途ではRAGや検索ツールと組み合わせる
まとめ
- Nemotron 3.5 Bolt 74B-A9B 24GBは、120B-A12Bの親モデルを「24GBに収まること」を目標に圧縮し、事後学習とQADを経て、重みの大部分を2ビットにしたモデルである
- 精度の鍵は、学習後に丸めるPTQではなく、圧縮段階から量子化を前提に設計し、量子化した状態で教師モデルに合わせて学習し直している点にある
- BF16版との差は数ポイントに収まり、エージェント系ベンチマークでは同じメモリ量の4ビットモデルを上回る。一方で速度と同時実行性能は劣るため、1人用のローカルエージェントとして使うのが適している
参考
- Sam Witteveen「NVIDIA’s Secret 2 Bit Model」(YouTube、2026年11月9日)
- NVIDIA Research「NVIDIA Nemotron 3.5 Bolt 74B-A9B 24GB」
- Hugging Face「nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB」
- HPCwire「NVIDIA Expands Nemotron Family with Highest Efficiency Super VL and Bolt Models」
- クラスメソッド「2-bit量子化MoE『Nemotron 3.5 Bolt 74B-A9B』をDGX Sparkで動かしてみた」