Wide-EPとは?MoEモデルのエキスパートを数十枚のGPUに分散して、メモリと計算を効率化するNVIDIAの方法
結論:Wide-EP(ワイド・エキスパート並列)は、MoEと呼ばれる構造の大型モデルで、エキスパートを8枚以上、数十枚のGPUに分散させる方法です。GPU1枚あたりの重みが減ってKVキャッシュに使えるメモリが増え、計算の効率も上がります。NVIDIAの測定では、GPU1枚あたりの出力量が最大1.8倍になりました。
ポイントは次の3つです。
- 背景:最近の大型モデルの多くはMoE構造で、数百個のエキスパートのうち数個だけを使って計算する。ただし、全エキスパートの重みは常にGPUメモリに置く必要がある
- 仕組み:エキスパートを多くのGPUに分散すると、1枚あたりの重みが減り、空いたメモリをKVキャッシュに回せる。1つのエキスパートが多くのトークンをまとめて処理できるため、演算強度も上がる
- 前提条件:層ごとにGPU間でデータをやり取りするため、多数のGPUを直結するNVLink(GB200 NVL72なら72枚)が必要になる
この記事は「GPUメモリを無駄なく使う5つの方法」の2本目です。
前提:MoE(Mixture of Experts)とは
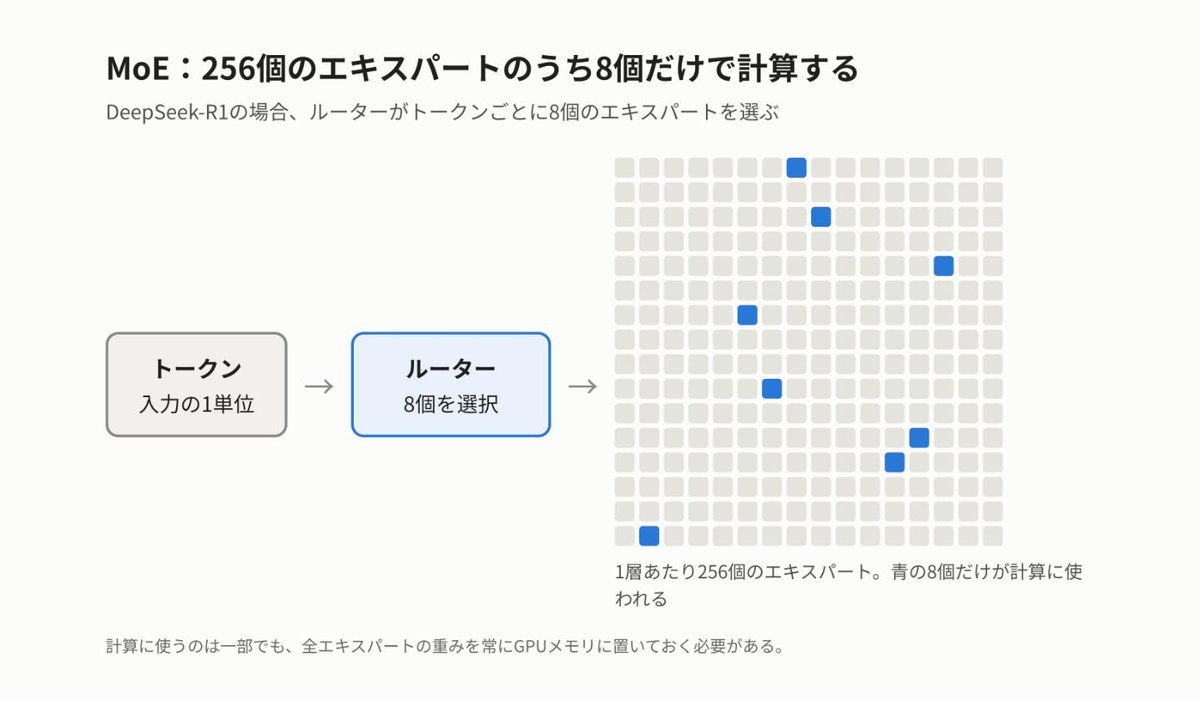
MoEは、モデルの一部を多数の「エキスパート」(小さなニューラルネットワーク)に分け、入力ごとに一部のエキスパートだけを使う構造です。
- 各層に多数のエキスパートがある
- 入力のトークン(文章を分割した単位)ごとに、ルーター がどのエキスパートを使うかを選ぶ
- 選ばれたエキスパートだけが計算し、結果を合算する
たとえばDeepSeek-R1は、パラメータ総数が6710億で、1層あたり256個のエキスパートを持ち、トークンごとに8個を選んで計算します。
MoEの課題:使わないエキスパートの重みもメモリに置く
MoEは、トークンあたりの計算量を抑えられます。一方で、どのエキスパートがいつ選ばれるかは事前に分からないため、全エキスパートの重みを常にGPUメモリに置いておく必要があります。その分、KVキャッシュ(会話の途中経過を保持するデータ)に使えるメモリが減ります。
Wide-EP:エキスパートを多くのGPUに分散する
エキスパートを複数のGPUに分けて配置する方法を エキスパート並列(EP) と呼びます。NVIDIAは、8枚以上のGPUに分散する大規模なEPを「Wide-EP」と呼び、TensorRT-LLMに実装しています。
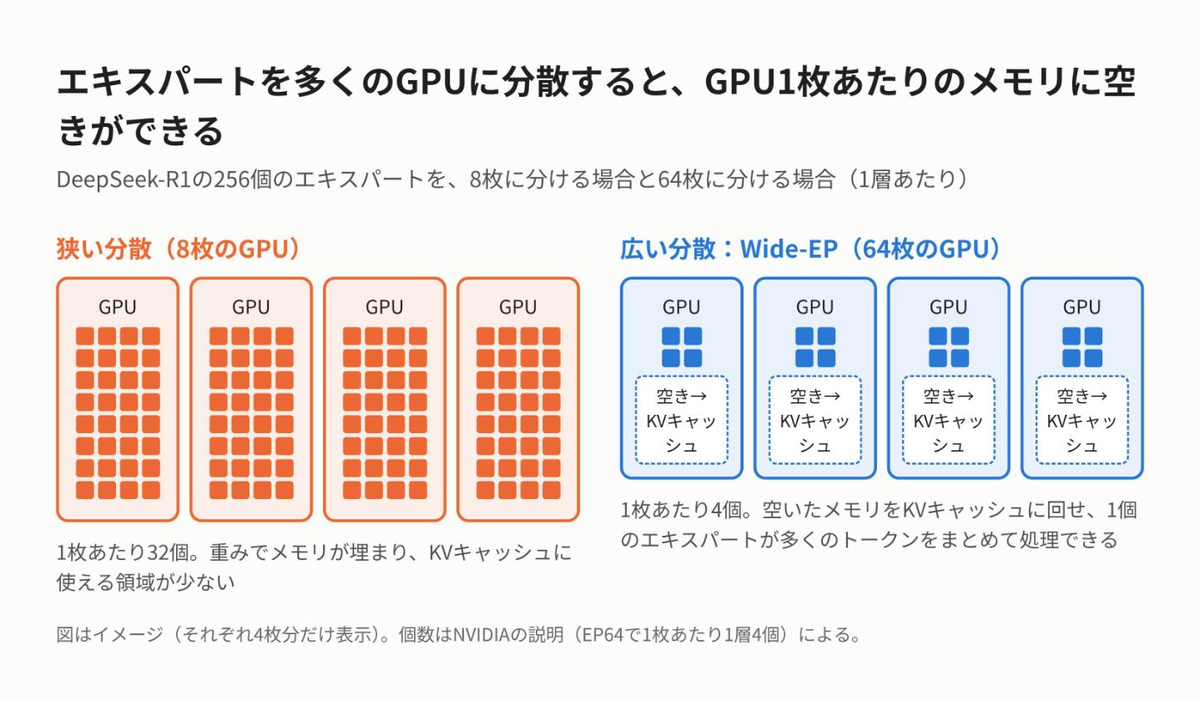
DeepSeek-R1を64枚のGPUに分散する(EP64)と、1枚が受け持つエキスパートは1層あたり4個になります。全58層のMoE層で、1枚あたり232個(全14,848個中)です。8枚に分散する場合は、1枚あたり1層32個です。
分散を広げると、2つの効果があります。
効果1:KVキャッシュに使えるメモリが増える
1枚あたりのエキスパートの重みが減るため、空いたHBMをKVキャッシュに割り当てられます。同時に処理できるリクエスト数や、扱える文脈の長さが増えます。
効果2:演算強度が上がる
GPUの計算では、重みをHBMから読み出す時間がボトルネックになることがあります(メモリ律速)。1つのエキスパートに少数のトークンしか集まらないと、重みを読み出す時間に対して計算量が少なく、計算ユニットが遊びます。
分散を広げると、1枚のGPU上の1つのエキスパートに、多くのトークンが集まります。TensorRT-LLMは、複数トークンの計算をまとめて行う行列演算(GroupGEMM)で重みを再利用するため、読み出したデータ量あたりの計算量(演算強度) が上がります。
前提条件:GPU間の高速通信
分散を広げると、通信の量が増えます。MoE層では、各トークンを担当エキスパートのあるGPUへ送り(dispatch)、計算結果を元のGPUへ戻す(combine)必要があります。すべてのGPUがすべてのGPUとデータをやり取りするため、オールツーオール通信 と呼ばれます。
この通信が遅いと、分散の効果が打ち消されます。そこで重要になるのが NVLink です。
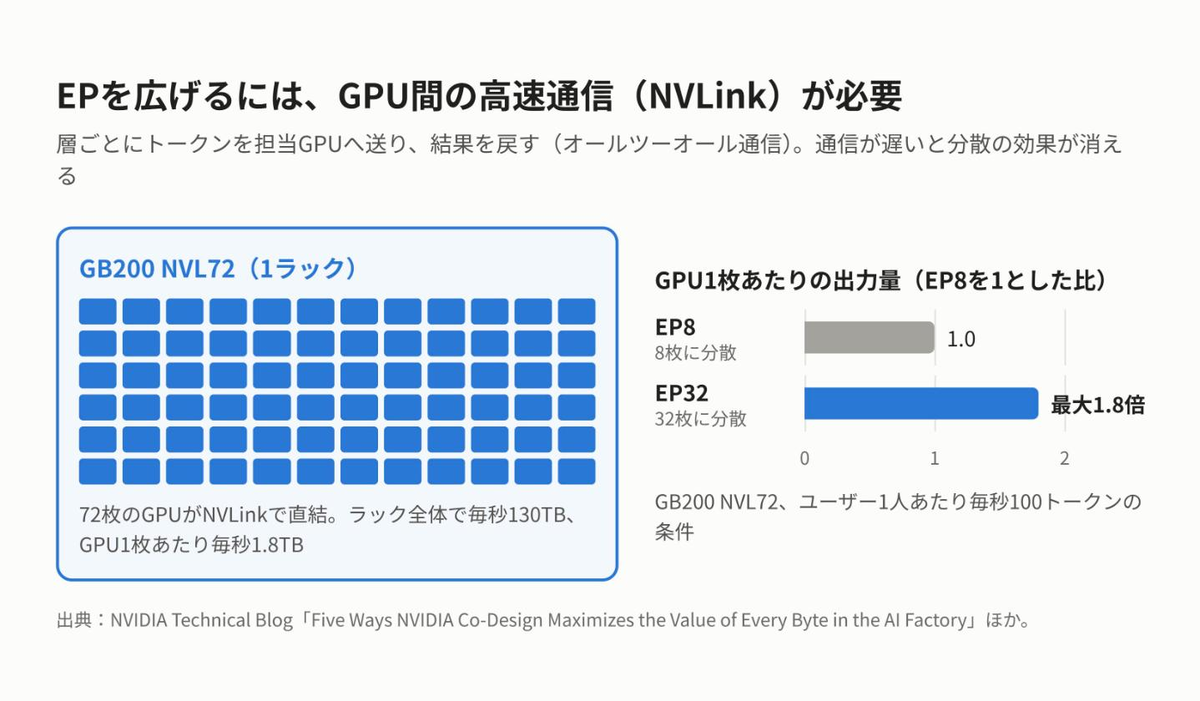
- GB200 NVL72は、72枚のGPUをNVLinkで直結したラックで、全体で毎秒130TB、GPU1枚あたり毎秒1.8TBの帯域がある
- 72枚が同じNVLinkドメインにあるため、数十枚に分散しても通信が高速
- NVIDIAの測定では、EP32はEP8よりGPU1枚あたりの出力量が最大1.8倍になった(GB200 NVL72、ユーザー1人あたり毎秒100トークンの条件)
- GB300 NVL72は、H200 NVL8と比べて電力あたりの処理量が10倍(同条件)
次世代のVera Rubin NVL72では、GPU1枚あたり最大288GBのHBM4、毎秒3.0TBのNVLink 6を備え、ラック全体のHBM4は約20.7TBになります。
一方、GPU8枚のサーバーを複数台つないだ構成では、8枚を超える範囲の通信がサーバー外のネットワーク(InfiniBandなど)を通るため、遅延が大きくなります。Wide-EPは、大きなNVLinkドメインとセットで効果を発揮する方法です。
負荷の偏り:EPLB
エキスパートが選ばれる頻度には偏りがあります。頻繁に選ばれるエキスパートが同じGPUに集中すると、そのGPUの処理が全体のボトルネックになり、ほかのGPUは遊休になります。
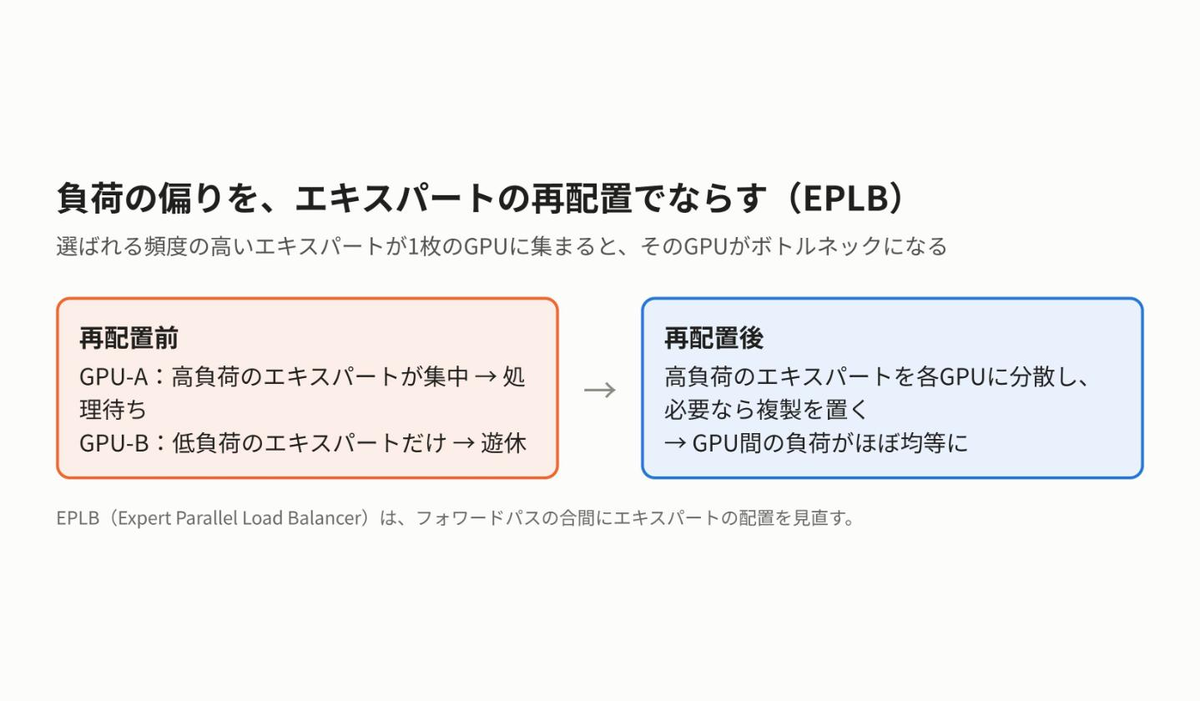
Wide-EPには、EPLB(Expert Parallel Load Balancer) という仕組みがあります。
- フォワードパスの合間に、エキスパートごとの負荷を見て配置を入れ替える
- 特に負荷の高いエキスパートは、複数のGPUに複製を置く
制約と注意点
- NVLinkドメインの大きさが前提:NVL72のような大きなNVLinkドメインがないと、通信がボトルネックになりやすい
- 対象はMoEの大型モデル:数枚のGPUに収まるモデルや、MoE構造でないモデルでは、Wide-EPを使う理由は小さい
- 最良条件の数字:「最大1.8倍」は、DeepSeek-R1と特定の応答速度の条件での結果です
まとめ
- MoEモデルは、計算に使うエキスパートは一部でも、全エキスパートの重みをGPUメモリに置く必要がある
- Wide-EPは、エキスパートを数十枚のGPUに分散し、空いたメモリをKVキャッシュに回し、演算強度も上げる
- 層ごとにオールツーオール通信が発生するため、NVLinkで直結された大きなドメインが前提になる
- 負荷の偏りは、EPLBによるエキスパートの再配置と複製でならす
連載「GPUメモリを無駄なく使う5つの方法」
- GPUメモリを無駄なく使う5つの方法【まとめ】
- ① NVFP4:モデルを4ビットにする数値形式
- ② Wide-EP:MoEのエキスパートを多数のGPUに分散する(この記事)
- ③ Dynamo:KVキャッシュをデータセンター全体で再利用する
- ④ Vera CPU:待ち時間中のKVキャッシュをCPUメモリで受け持つ
- ⑤ CMX:KVキャッシュ専用の共有ストレージ階層
あわせて読みたい
- DSX OS:分散学習を遅くするGPUノードを検出する
多数のGPUを1つの処理で使うときに、遅いノードを見つける仕組み
参考