NVIDIA Vera CPUとは?1.5TBのメモリとNVLink-C2Cで、AIエージェントの待ち時間中のKVキャッシュを受け持つCPU
結論:NVIDIA Vera CPUは、最大1.5TBのメモリを持ち、次世代GPU RubinとNVLink-C2Cで毎秒1.8TBの帯域で接続されたCPUです。AIエージェントがツールの結果を待つ間、そのセッションのKVキャッシュをGPUのHBMからVeraのメモリへ退避させ、HBMを別のリクエストに使えるようにします。
ポイントは次の3つです。
- 背景:エージェントは「LLMで推論→ツールを実行して結果を待つ」を繰り返す。待っている間も、そのセッションのKVキャッシュがHBMを占有している
- 仕組み:Veraのメモリ(LPDDR5X、最大1.5TB)はRubinのHBM4(288GB)の5倍以上。NVLink-C2CはPCIe Gen6(16レーン)の約7倍の帯域で、KVキャッシュの退避と読み戻しが速い
- もう1つの役割:ツールの実行(コードの実行、検索など)はCPUの処理。Veraはこの処理も速い
この記事は「GPUメモリを無駄なく使う5つの方法」の4本目です。
前提:KVキャッシュの階層
LLMの推論では、KVキャッシュ(処理済みの入力の中間データ)を次の階層に置きます。
| 階層 | 置き場所 | 特徴 |
|---|---|---|
| G1 | GPUメモリ(HBM) | GPUが直接計算に使う。最も高速だが容量が小さい |
| G2 | CPUメモリ | HBMより低速だが大容量 |
| G3 | ローカルSSD | さらに大容量だが、そのノードからしか使えない |
| G4 | 共有ストレージ | 最も大容量だが、最も遅い |
この記事が扱うのは、G2のCPUメモリです。
問題:ツール待ちの間もKVキャッシュがHBMを占有する
AIエージェントの1回の処理は、次の繰り返しです。
- LLMで次の行動を決める(GPUで推論)
- ツールを呼び出す(コードの実行、データベースの検索、Webの検索など)
- ツールの結果を待つ
- 結果を入力に加えて、再びLLMで推論する
3の待ち時間は、数秒から数分に及ぶことがあります。この間、セッションのKVキャッシュはHBM上に残ったままで、計算には使われていません。
HBMが埋まると、新しいリクエストを受け付けられません。かといってKVキャッシュを破棄すると、4のときにprefillで再計算することになります。
解決策:ツール待ちの間だけ、KVキャッシュをCPUメモリへ退避する
NVIDIAは、ツール呼び出しの間だけKVキャッシュをVera CPUのメモリへ移し、生成に戻る前にGPUへ戻す運用を示しています。移動を管理するのは、NVIDIAの推論基盤DynamoのKVブロックマネージャー(KVBM)です。
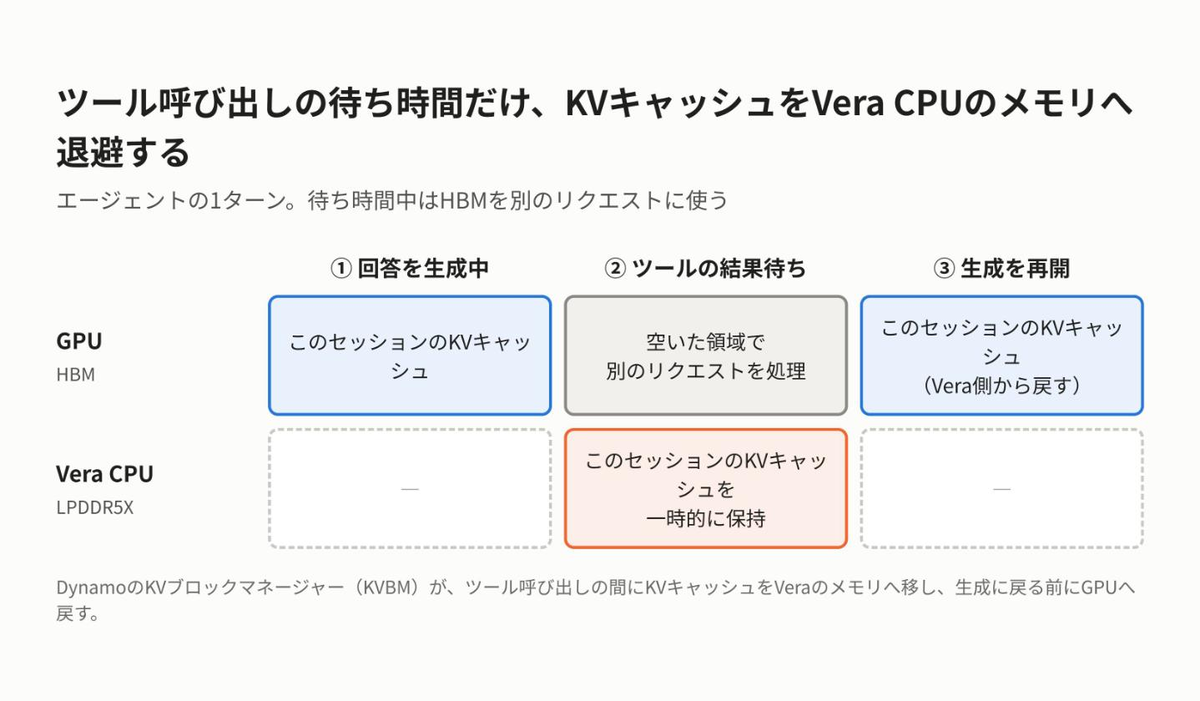
この運用には、CPU側に2つの条件が必要です。
- 容量が大きいこと:多数のセッションのKVキャッシュを保持できる
- GPUとの帯域が広いこと:退避と読み戻しが速く、待ち時間を増やさない
条件1:容量はRubinのHBMの5倍以上
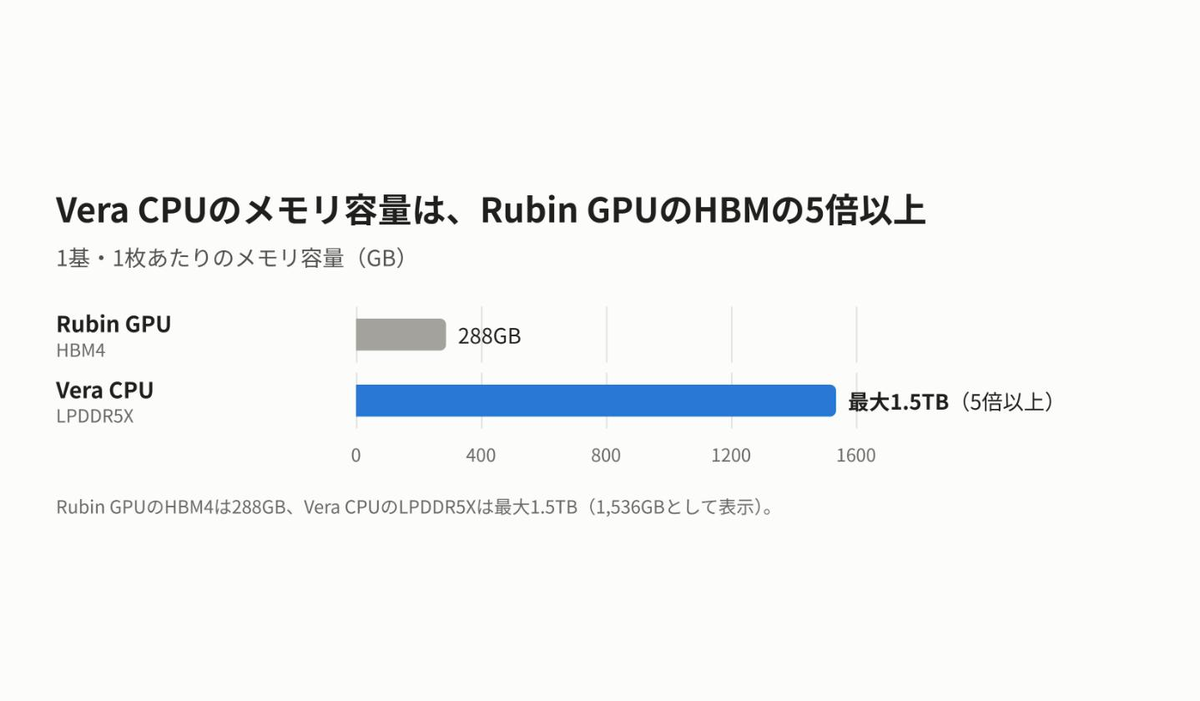
Vera CPUは1基あたり最大1.5TBのLPDDR5Xを搭載できます。Rubin GPU 1枚のHBM4(288GB)の5倍以上です。LPDDR5Xはモバイル機器にも使われる低消費電力のメモリで、HBMより大容量にしやすい特徴があります。Veraのメモリ帯域は最大毎秒1.2TB、コアあたり最大毎秒14GBです。
条件2:GPUとの帯域はPCIe Gen6の約7倍
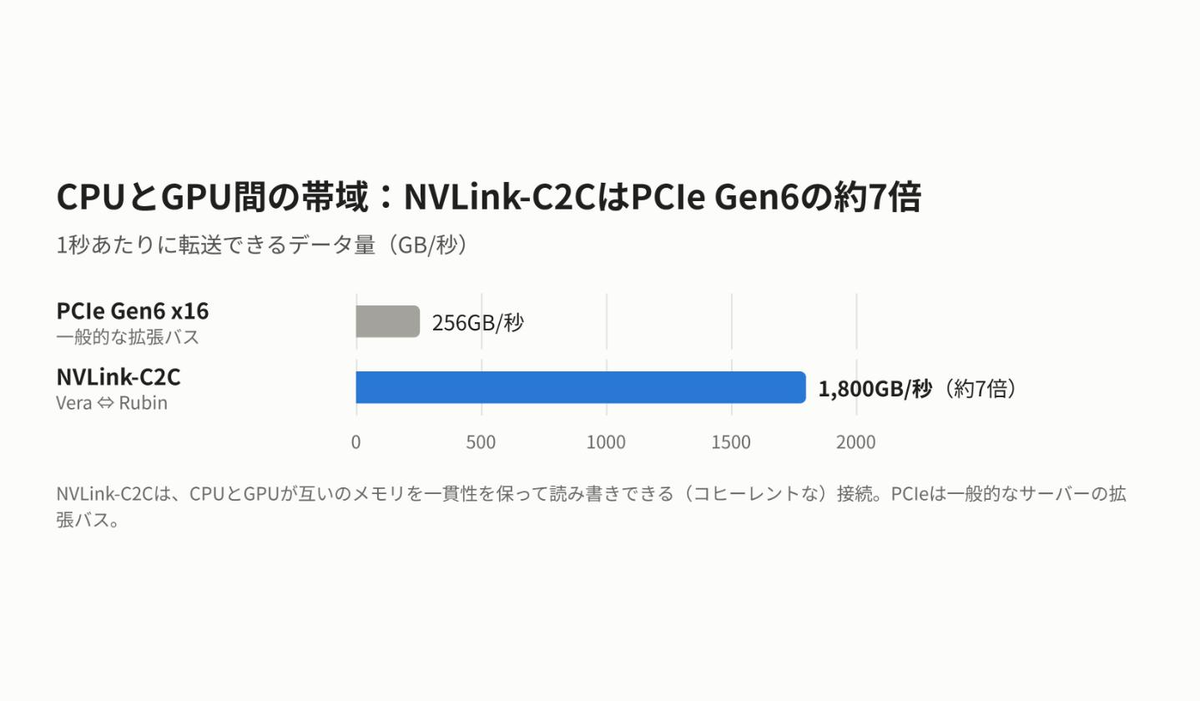
VeraとRubinは NVLink-C2C で接続され、帯域は毎秒1.8TBです。一般的なサーバーでCPUとGPUをつなぐPCIe Gen6(16レーン、毎秒256GB)の約7倍、前世代のGrace CPUのNVLink-C2C(毎秒900GB)の2倍です。
NVLink-C2Cはコヒーレントな接続で、CPUとGPUが互いのメモリを一貫性を保ったまま読み書きできます。
もう1つの役割:ツール実行の高速化
エージェントがツールを使う処理、つまり コードの実行、検索、データベースへの問い合わせなどは、CPUの処理 です。Veraは、NVIDIAが独自に設計した88個の「Olympus」コア(Armv9.2互換、2スレッド同時実行で176スレッド)を持ち、シングルスレッド性能を重視しています。エージェントの処理には、分岐が多く逐次的な処理が多いためです。
NVIDIAが紹介したパートナーの結果は次のとおりです。
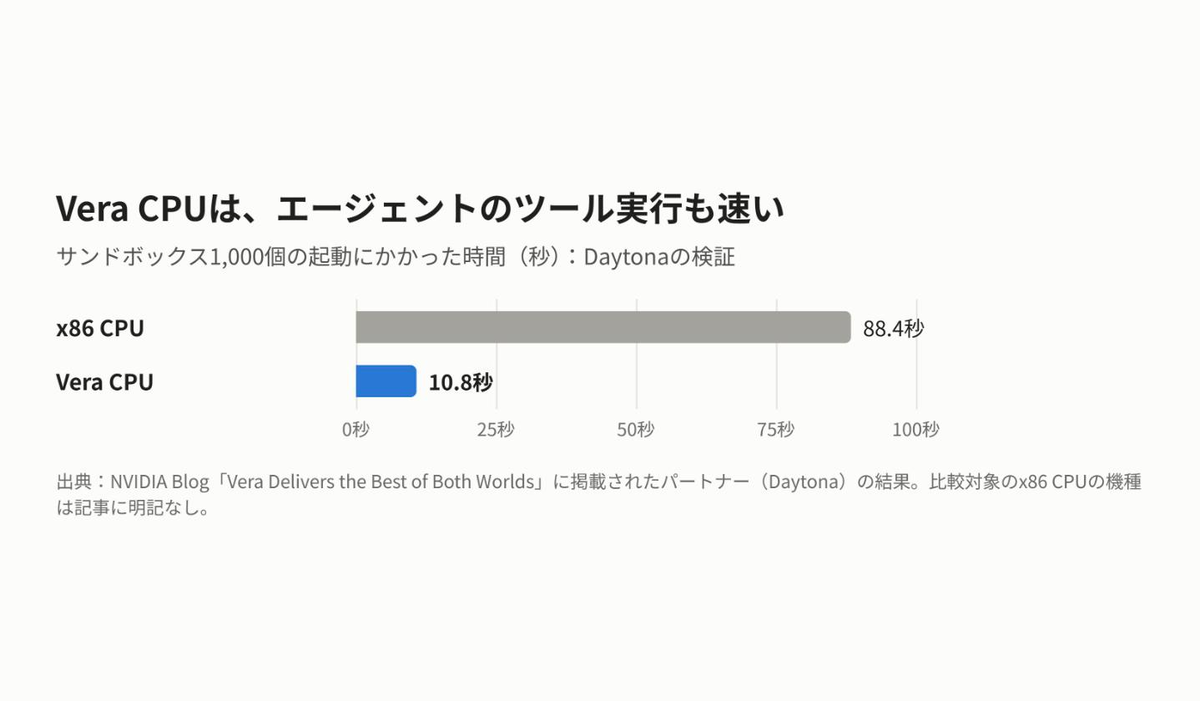
- Daytona:エージェント用サンドボックス1,000個を10.8秒で起動した(比較対象のx86 CPUでは88.4秒)
- Perplexity:コーディングのエージェント処理が、従来のCPUより1.5倍速かった
- DeepInfra:エージェントのオーケストレーション処理で、最速のx86プロセッサーの最大2.2倍の速さだった
NVIDIAは100MW規模のデータセンターでの比較として、最速のx86 CPUに対して電力あたりのエージェント数が1.6倍、電力効率の高いx86 CPUに対してエージェントの処理速度が2倍としています。
制約と注意点
- 退避と読み戻しのタイミング:生成に戻る前に読み戻しが終わっていないと、待ち時間が増えます。タイミングの判断はDynamoに依存します
- Vera Rubin世代が前提:毎秒1.8TBの接続はVeraとRubinの組み合わせの話です。x86サーバーとPCIe接続のGPUでは、同じ効果は期待できません
- パートナーの数字は個別条件の結果:比較対象のx86 CPUの機種など、条件が明記されていないものもあります
まとめ
- AIエージェントは、ツールの結果を待つ間もKVキャッシュでHBMを占有している
- Vera CPUは、RubinのHBMの5倍以上のメモリを持ち、NVLink-C2Cで毎秒1.8TBの帯域で接続されている
- ツール待ちの間だけKVキャッシュをVeraのメモリへ退避すれば、HBMを別のリクエストに使える
- Veraはツールの実行自体も速く、エージェントの推論以外の処理も支える
連載「GPUメモリを無駄なく使う5つの方法」
- GPUメモリを無駄なく使う5つの方法【まとめ】
- ① NVFP4:モデルを4ビットにする数値形式
- ② Wide-EP:MoEのエキスパートを多数のGPUに分散する
- ③ Dynamo:KVキャッシュをデータセンター全体で再利用する
- ④ Vera CPU:待ち時間中のKVキャッシュをCPUメモリで受け持つ(この記事)
- ⑤ CMX:KVキャッシュ専用の共有ストレージ階層
あわせて読みたい
- Agent Substrate:待機の長いエージェントを少数のPodで動かす
待機中のエージェントを退避・復元して、少ないPodで多数を動かす仕組み - NeMo:AIエージェントの失敗をトレースから改善する
エージェントのツール呼び出しをトレースで分析する方法
参考