NVIDIA Dynamoとは?LLMのKVキャッシュをデータセンター全体で再利用する推論基盤の仕組み
結論:NVIDIA Dynamoは、LLMのKVキャッシュを「GPU1枚の持ち物」ではなく「データセンター全体の資源」として扱う推論基盤です。KVキャッシュの位置を見てリクエストを振り分ける、prefillとdecodeを別のGPUで処理する、KVキャッシュを4つの階層に分けて置く、の3つで再計算を減らします。
ポイントは次の3つです。
- 背景:LLMは、処理済みの入力の計算結果(KVキャッシュ)を残しておけば、同じ文章で始まる次のリクエストでその部分の計算を省ける。捨てれば再計算になる
- 仕組み:①KV-awareルーティング、②prefillとdecodeの分離、③KVブロックマネージャー(KVBM)によるG1〜G4の階層管理
- 効果:ストレージ企業の検証では、KVキャッシュの再利用によって、最初のトークンが出るまでの時間(TTFT)が再計算より短くなった
この記事は「GPUメモリを無駄なく使う5つの方法」の3本目です。
前提:KVキャッシュとprefill・decode
LLMが回答を生成する処理は、2つの段階に分かれます。
| 段階 | 処理内容 | 性質 |
|---|---|---|
| prefill | 入力(指示文、会話履歴、資料など)全体を処理する | 計算量が多い(計算律速) |
| decode | 回答を1トークンずつ生成する | メモリの読み出しが多い(メモリ帯域律速)。応答の速さが重要 |
prefillでは、入力の各トークンについてKey(K)とValue(V)という中間データを計算します。これを保存したものが KVキャッシュ です。decodeでは、新しいトークンを生成するたびにKVキャッシュを参照します。
KVキャッシュには、もう1つの使い道があります。次のリクエストの入力が同じ文章で始まる場合、その部分(プレフィックス)のKVキャッシュを再利用すれば、prefillの計算を省けるのです。
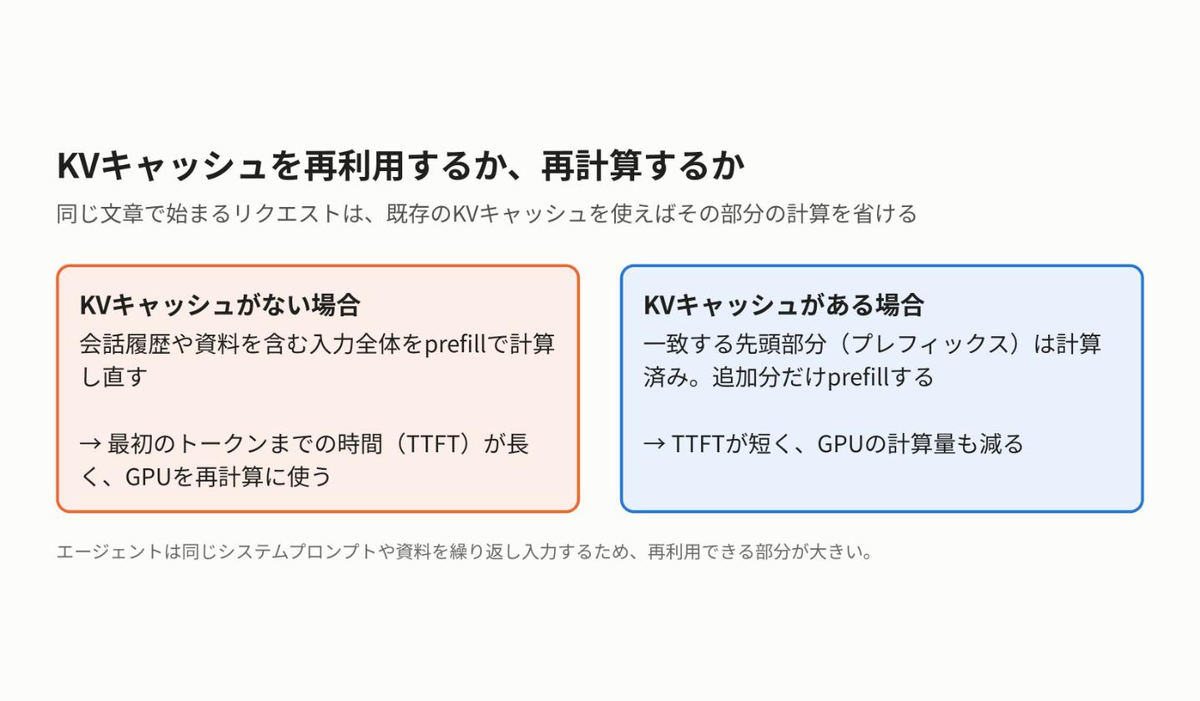
エージェントの普及で、KVキャッシュの扱いが重要になった
AIエージェントは、長いシステムプロンプトや資料を入力したまま、何十回もLLMを呼び出します。同じ先頭部分が何度も繰り返されるため、再利用できる部分が大きくなります。一方で、KVキャッシュを置けるGPUメモリ(HBM)は限られます。KVキャッシュをどこに置き、どう再利用するかが、推論の速さと費用を大きく左右するようになりました。
NVIDIA Dynamoとは
NVIDIA Dynamoは、多数のGPUでLLMを動かすためのオープンソースの推論基盤です。vLLM、SGLang、TensorRT-LLMといった推論エンジンと組み合わせて使い、データセンター規模でリクエストの振り分けやGPUの割り当てを行います。性能が重要な部分はRust、拡張性が必要な部分はPythonで書かれています。KVキャッシュの扱いについて、3つの機能があります。
機能1:KV-awareルーティング
Dynamoのルーターは、各ワーカー(推論エンジンが動くGPU)がどのKVブロックを持っているかを、基数木(radix tree)で一元管理しています。
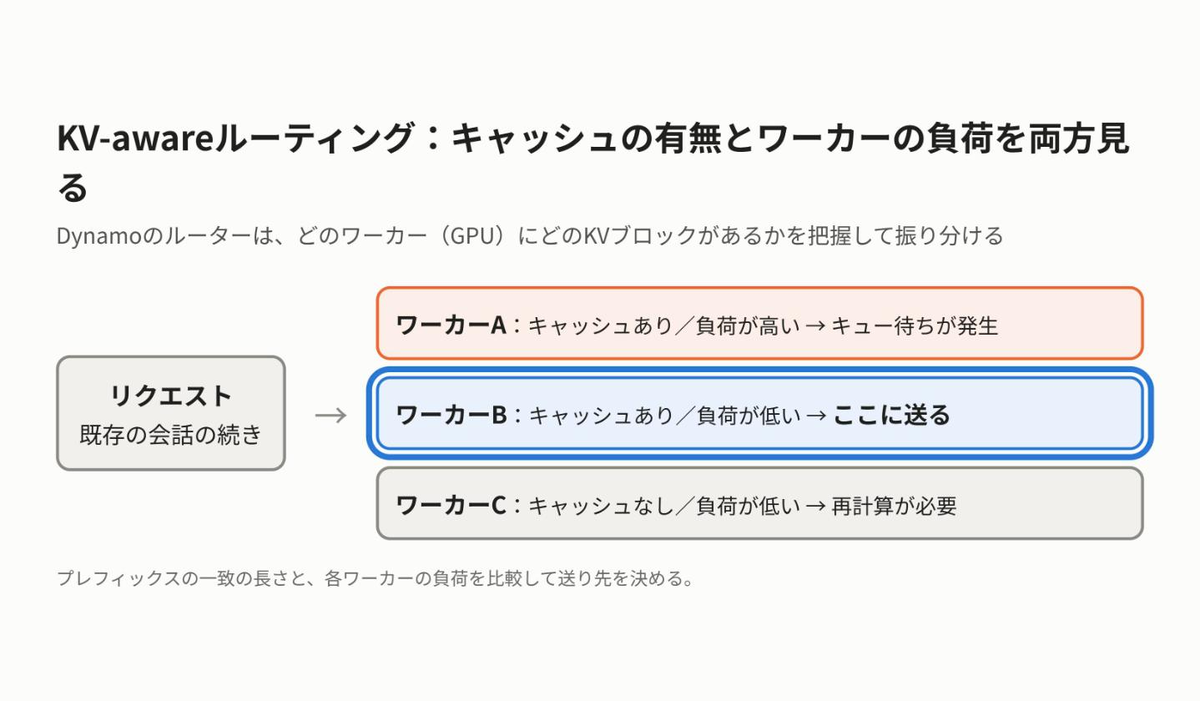
- 新しいリクエストが来たら、プレフィックスが一致するKVキャッシュを持つワーカーを探す
- ただし、そのワーカーの負荷が高ければ、キュー待ちより再計算のほうが早い場合もある
- プレフィックスの一致の長さと、各ワーカーの負荷を比較して 送り先を決める
単純なラウンドロビン(順番に振り分ける方式)では、同じ会話のリクエストが毎回別のワーカーに送られ、そのたびにprefillの再計算が発生します。KV-awareルーティングはこれを避けます。
機能2:prefillとdecodeの分離
同じGPUでprefillとdecodeの両方を処理すると、長い入力のprefillが入るたびに、decode中の他のリクエストの生成が遅れます。そこでDynamoは、2つの段階を別々のGPUグループに担当させます。これを分離型推論(disaggregated serving)と呼びます。
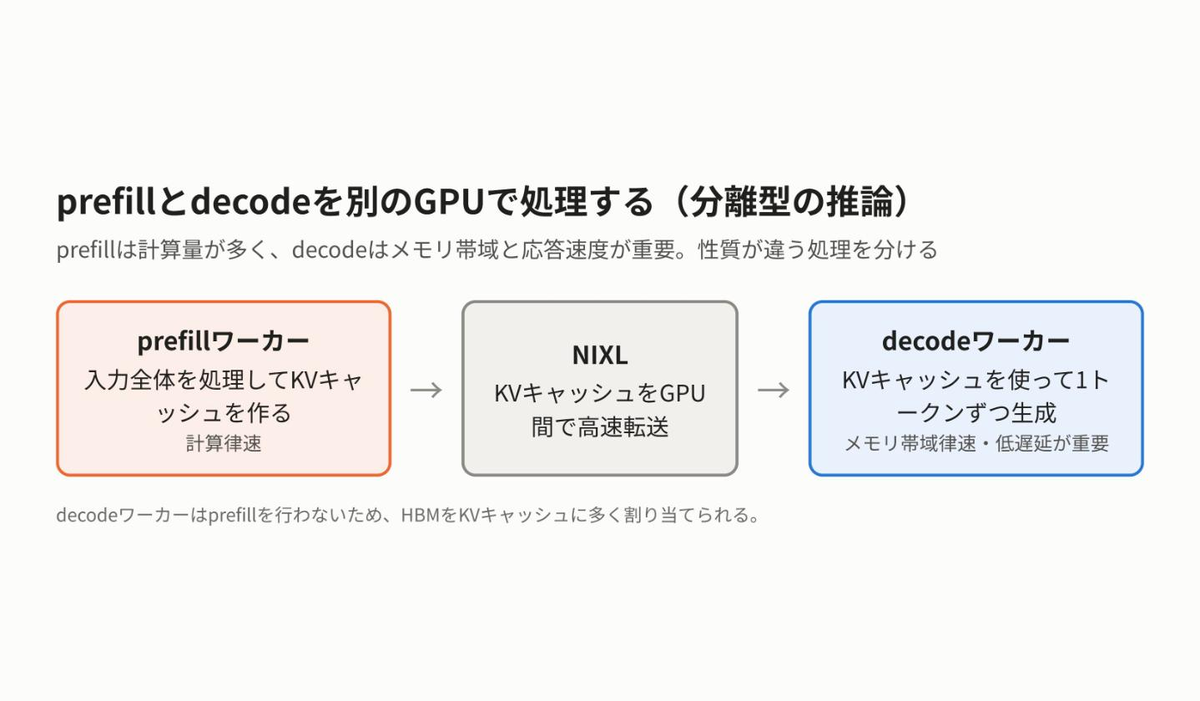
- prefillワーカーがKVキャッシュを作り、転送ライブラリ NIXL(NVIDIA Inference Xfer Library)でdecodeワーカーへ送る
- decodeワーカーはprefillを行わないため、HBMをKVキャッシュに多く割り当てられる
- 負荷に応じて、prefillとdecodeのGPU数をそれぞれ調整できる
機能3:KVBMによる階層管理
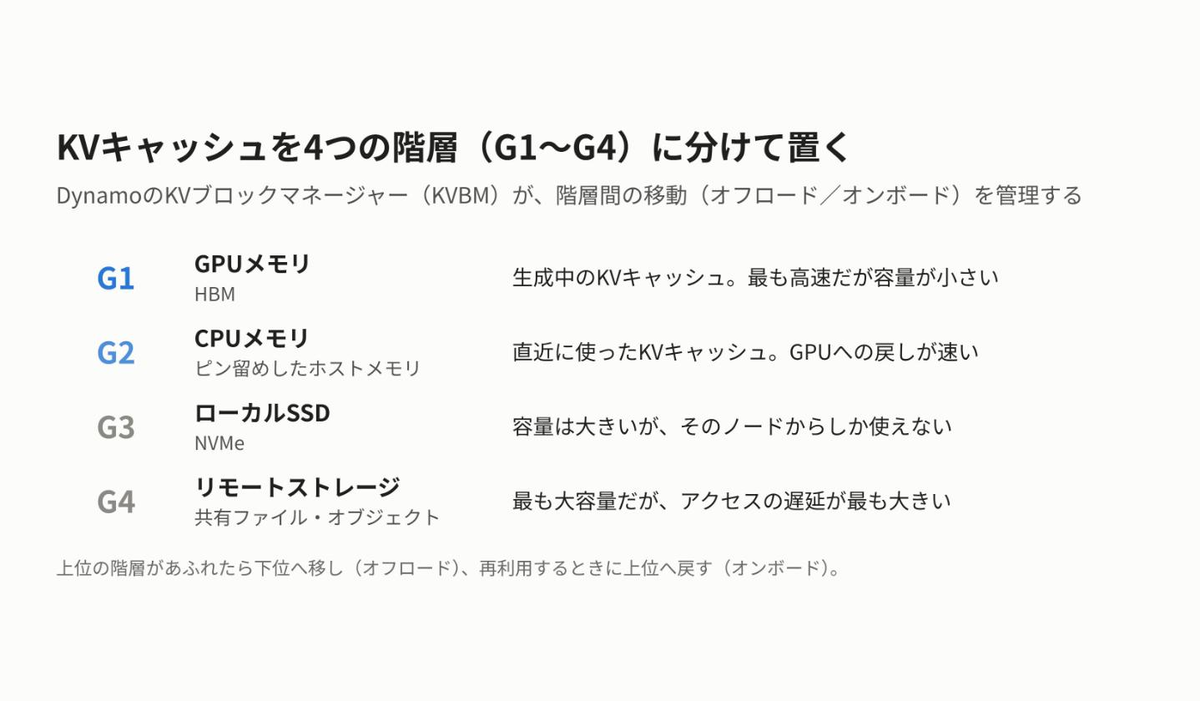
HBMに置けるKVキャッシュには限りがあります。Dynamoの KVブロックマネージャー(KVBM) は、KVキャッシュを次の4階層に分けて管理します。
| 階層 | 置き場所 | 特徴 |
|---|---|---|
| G1 | GPUメモリ(HBM) | 生成中のKVキャッシュ。最も高速だが容量が小さい |
| G2 | CPUメモリ(ピン留めしたホストメモリ) | GPUとの転送が速い |
| G3 | ローカルSSD(NVMe) | 大容量だが、そのノードからしか使えない |
| G4 | リモートストレージ | 最も大容量だが、遅延が最も大きい |
- 上位の階層があふれたら、KVブロックを下位へ移す(オフロード)
- 再利用するときは、上位へ戻す(オンボード)。prefillで再計算するより速い
- 同じ内容のブロックは、ハッシュで重複を排除する
NVIDIAの最新の説明では、複数ノードにまたがってブロックの位置を追跡し、他のノードのKVキャッシュも再利用できるKV Cache Runner(KVCR)にまで機能が広がっています。
設定の目安
Dynamoの設定ガイドは、CPUキャッシュ(G2)をGPU側のKVキャッシュより大きく設定することを推奨しています(目安は100GB以上)。G2がG1より小さいと、フォワードパスのたびにオフロードが発生し、性能が下がるためです。
効果
KVキャッシュ再利用の効果は、主にストレージ企業が検証しています。
- VAST Data:DGX H100上のvLLMとLMCacheで、Qwen3-32Bに約13万トークンの入力を与えた試験で、再利用時のTTFTが再計算より短くなった。CoreWeaveとの共同検証では、過去の会話をすべて再計算する場合と比べ、TTFTが20倍改善したと報告している
- 転送速度:VAST DataはGPUDirect StorageでH100 1枚に毎秒35GB、WEKAは独自のNIXLプラグインでH100 8枚に合計で毎秒最大270GBの読み込みを報告している
いずれもストレージ企業による検証の数字です。実際の効果は、入力の長さや、同じプレフィックスの繰り返し頻度によって大きく変わります。
制約と注意点
- 再利用できない入力には効かない:毎回異なる入力では、再利用できるKVキャッシュがありません
- 転送にも時間がかかる:下位階層からの読み戻しにも時間がかかります。VAST Dataの検証では、多くの場合、ストレージよりネットワークがボトルネックでした
- 障害時の保護には前提がある:推論エンジンが停止してもホストメモリ上のKVキャッシュを保持する機能(KVCR-Guard)がありますが、その保護サービスとホストが動作していることが前提です
まとめ
- KVキャッシュを再利用すれば、同じプレフィックスを持つリクエストのprefillを省ける
- Dynamoは、KV-awareルーティング、prefillとdecodeの分離、KVBMによるG1〜G4の階層管理で、KVキャッシュをデータセンター全体で使い回す
- 同じシステムプロンプトや資料を繰り返し使うエージェントほど、効果が大きい
連載「GPUメモリを無駄なく使う5つの方法」
- GPUメモリを無駄なく使う5つの方法【まとめ】
- ① NVFP4:モデルを4ビットにする数値形式
- ② Wide-EP:MoEのエキスパートを多数のGPUに分散する
- ③ Dynamo:KVキャッシュをデータセンター全体で再利用する(この記事)
- ④ Vera CPU:待ち時間中のKVキャッシュをCPUメモリで受け持つ
- ⑤ CMX:KVキャッシュ専用の共有ストレージ階層
あわせて読みたい
- Agent Substrate:待機の長いエージェントを少数のPodで動かす
Dynamoと連携して、エージェントを大規模に動かす仕組み - NVIDIA Snapshot:推論サーバーの起動を数十秒にする
推論サーバーの起動を速くする仕組み
参考