NVFP4とは?精度をほぼ落とさずにAIモデルを4ビットにする、NVIDIAの数値形式の仕組み
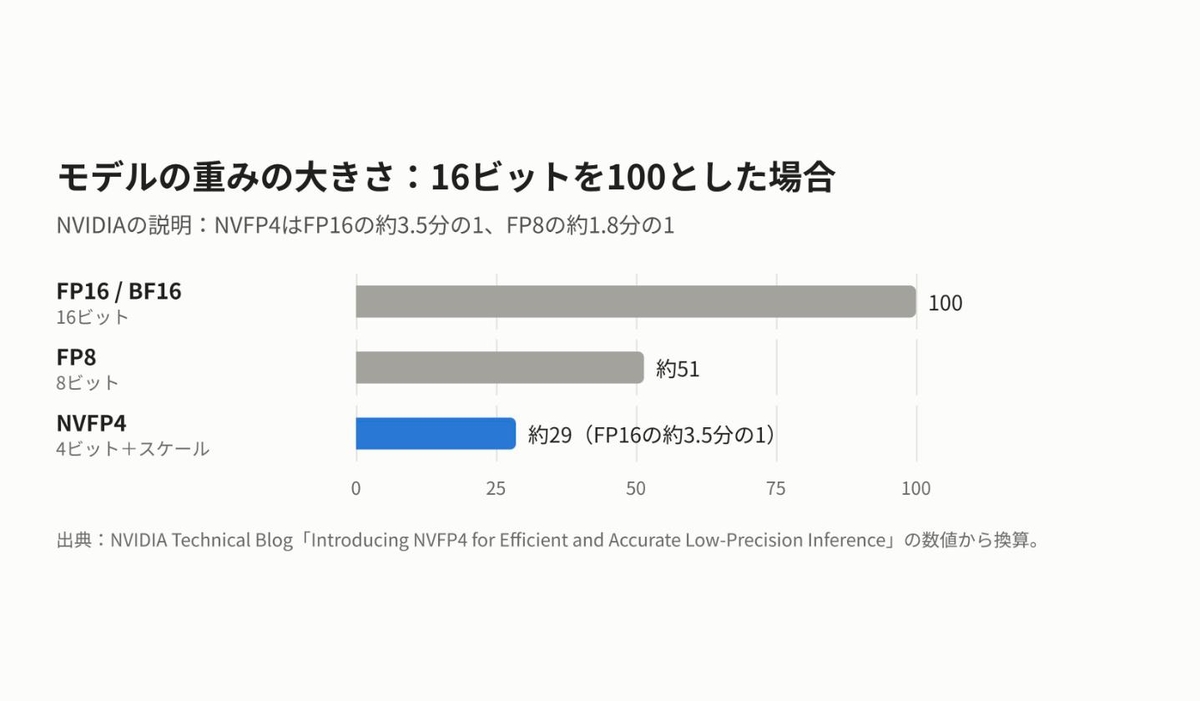
結論:NVFP4は、AIの計算に使う数値を4ビットまで小さくしながら、「16個の値ごとにFP8のスケールを付ける」ことで精度の低下を1ポイント前後に抑える、NVIDIAの数値形式です。モデルの重みは16ビット形式の約3.5分の1になります。
ポイントは次の3つです。
- 背景:GPUの高速メモリ(HBM)は容量が限られ、推論の性能はそこに何を載せられるかで決まる。数値のビット数を減らせば、同じHBMにより多くのデータを載せられる
- 仕組み:4ビットの浮動小数点数(E2M1)で表せる値は15個しかない。そこで16個の値ごとにFP8のスケールを、テンソル全体にFP32のスケールを付ける2段階の構造にした
- 効果:DeepSeek-R1-0528での正答率の差は、多くの項目で1ポイント以内。KVキャッシュに使えば、FP8より最大50%小さくなる
この記事は「GPUメモリを無駄なく使う5つの方法」の1本目です。
前提:ビット数を減らすことの意味
LLMは、数千億個にもなる数値(重み)の集まりです。推論のたびに、GPUはこの重みをHBMから読み出して計算します。1つの数値を何ビットで表すかによって、必要なメモリの量と読み出しにかかる時間が変わります。
| 形式 | 1つの数値のビット数 | 対応するGPU |
|---|---|---|
| FP32 | 32ビット | すべて |
| FP16/BF16 | 16ビット | 現在の標準的な形式 |
| FP8 | 8ビット | Hopper(H100)以降 |
| NVFP4 | 4ビット+スケール | Blackwell以降 |
ビット数を半分にすれば、メモリの量も読み出しの時間も半分になります。ただし、表せる値の種類が減るため、計算結果の精度が落ちるおそれがあります。ビット数を減らすことと、精度を保つことの両立が課題です。
FP4(E2M1)で表せるのは15個の値だけ
NVFP4の土台になっているFP4は、4ビットを「符号1ビット・指数2ビット・仮数1ビット」に分けた浮動小数点数です(E2M1形式)。表せる値は次の15個です。
0、±0.5、±1、±1.5、±2、±3、±4、±6
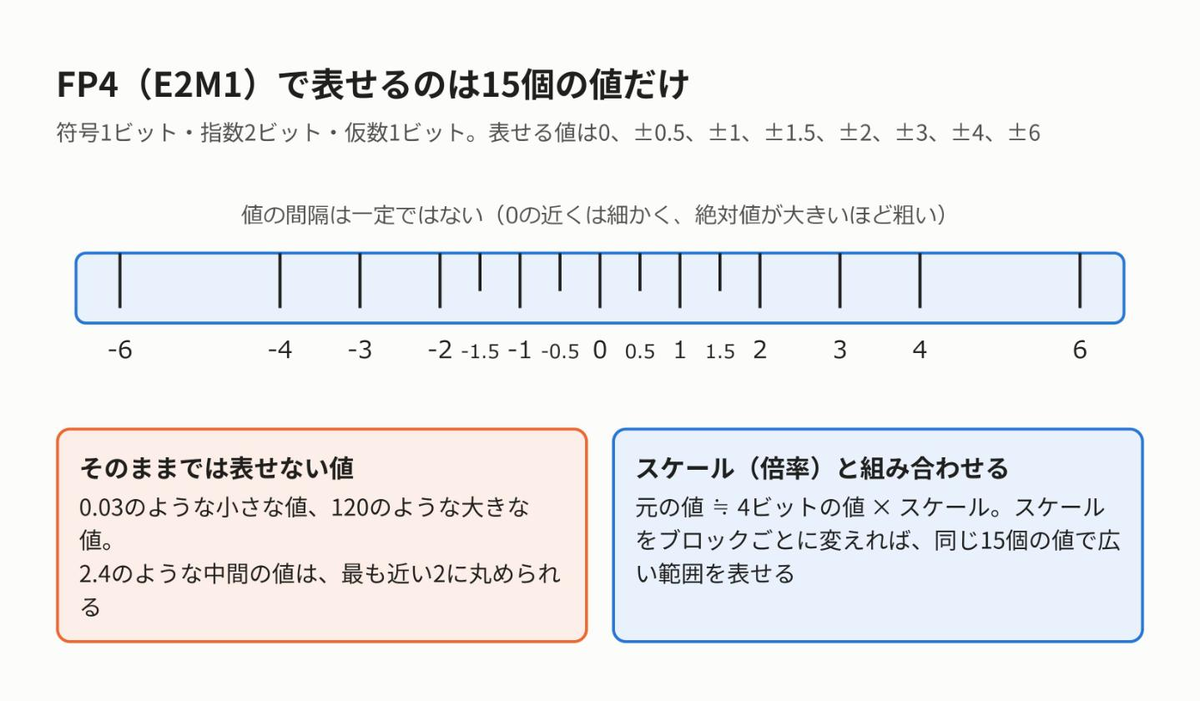
値の間隔は一定ではなく、0の近くは細かく、絶対値が大きくなるほど粗くなります。この15個だけでは、次のような値をそのまま表せません。
- 0.03のような小さな値(0に丸められる)
- 120のような大きな値(6に丸められる)
- 2.4のような中間の値(最も近い2に丸められる)
AIの重みには、ごく小さな値から大きな値までが混在しています。15個の値だけでは表現しきれません。
スケールと組み合わせる
そこで使うのが スケール(倍率) です。値の集まりごとにスケールを決め、「元の値 ≒ 4ビットの値 × スケール」として表します。
- 小さな値が集まるブロックでは、スケールを0.01にする → 0.005刻みで表せる
- 大きな値が集まるブロックでは、スケールを20にする → 最大120まで表せる
記録するのは「4ビットの値」と「スケール」の2つです。設計上の論点は、スケールを何個の値ごとに付けるかと、スケール自体をどれだけ細かく表すかの2つです。
NVFP4の設計:小さなブロックに、細かいスケールを付ける
業界標準の4ビット形式「MXFP4」(Open Compute Projectの仕様)と比べると、NVFP4の設計がよく分かります。
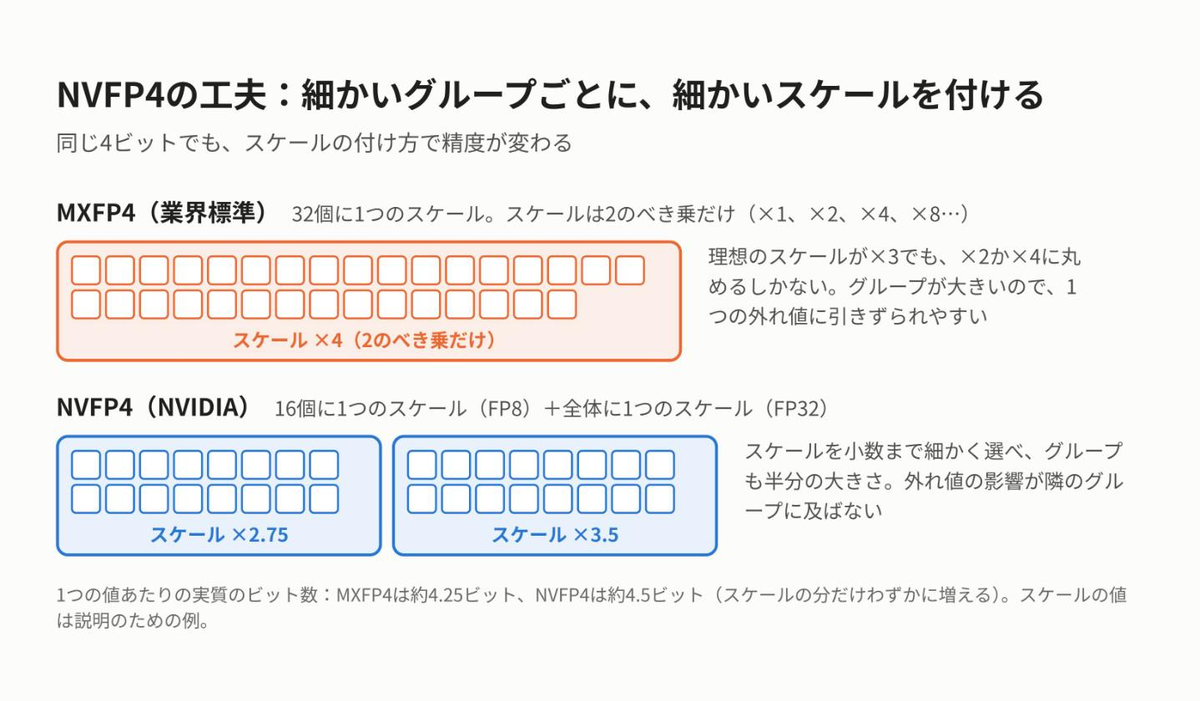
| 項目 | MXFP4 | NVFP4 |
|---|---|---|
| 1つのスケールを共有する値の数 | 32個 | 16個 |
| スケールの形式 | E8M0(2のべき乗だけ) | E4M3(FP8。小数を含む値を表せる) |
| テンソル全体のスケール | なし | FP32で1つ |
| 1つの値あたりの実質ビット数 | 約4.25ビット | 約4.5ビット |
設計1:スケールをFP8で表す
MXFP4のスケールはE8M0形式で、2のべき乗(1、2、4、8…)しか表せません。理想のスケールが3でも、2か4に丸めることになり、その分の誤差が4ビットの値に乗ります。
NVFP4はスケールをFP8(E4M3形式)で記録するため、2.75のような値も表せます。NVIDIAの例では、スケールを量子化するときの誤差(平均二乗誤差)が、E8M0の0.72に対してE4M3では0.08でした。
設計2:ブロックを16個にした
1つのスケールを共有する範囲が広いと、その中に1つだけ極端に大きな値(外れ値)があったとき、スケールがその値に合わせて大きくなり、ほかの値が粗くしか表せなくなります。NVFP4はブロックを32個から16個に減らし、外れ値の影響が及ぶ範囲を半分にしました。
設計3:テンソル全体のスケールを追加した
E4M3はE8M0より細かく表せる代わりに、表せるスケールの範囲が狭くなります。そこでNVFP4は、テンソル全体にもう1つFP32のスケールを付けました。テンソル全体のスケールで値の分布を大まかに合わせ、そのうえで16個ごとのスケールで細かく調整する、2段階の構造です。
効果
サイズは16ビット形式の約3.5分の1
スケールの分だけ1つの値あたり約4.5ビットになりますが、それでも16ビット形式より大幅に小さくなります。
精度の低下は1ポイント前後
NVIDIAは、DeepSeek-R1-0528を学習後量子化(PTQ)でNVFP4に変換し、FP8版と正答率を比べています。
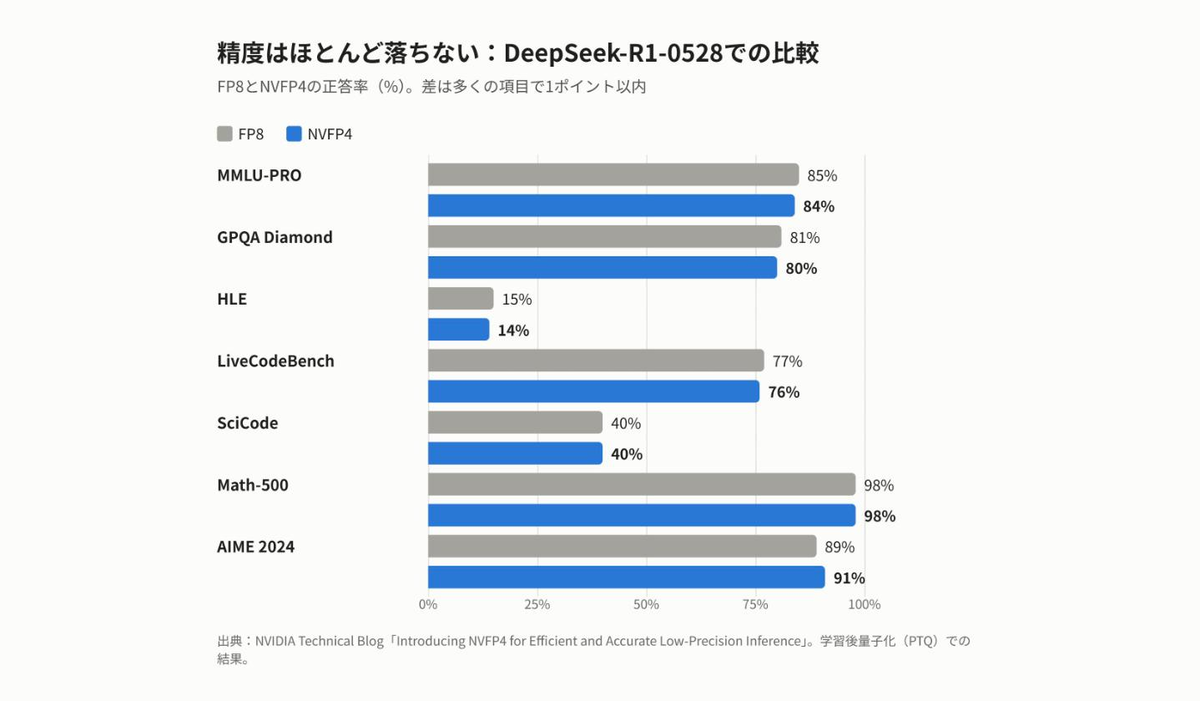
7項目のうち、差は最大1ポイントで、AIME 2024ではNVFP4のほうが2ポイント高い結果でした。
KVキャッシュにも使える
NVFP4は重みだけでなく、KVキャッシュ(会話の途中経過を保持するデータ)にも使えます。NVIDIAによると、KVキャッシュをNVFP4にするとFP8より最大50%小さくなり、GPUに載せられる文脈の長さがおよそ2倍になります。DeepSeek-v4-Proの10種類のベンチマークでは、BF16版の99%以上の成績を保ち、差は0.1〜1.0ポイントでした(最大はTerminalBenchの74.1対75.1)。
制約と注意点
- 誤差はゼロではない:精度の差が1ポイントでも問題になる用途では、対象のタスクで検証が必要です
- Blackwell以降が必要:NVFP4を高速に計算するTensor Coreは、Blackwell世代から搭載されています
- 最良条件の数字:「電力あたり最大4倍」(GB300でのDeepSeek R1、FP8比)などの数字は、特定のモデルと条件での最大値です
試すには
- NVIDIA TensorRT Model OptimizerまたはLLM Compressorで、モデルをNVFP4に変換できます(PTQ、量子化を考慮した学習=QATなど)
- 変換したモデルは、TensorRT-LLMやvLLMで動かせます
- DeepSeek-R1-0528などの変換済みモデルが、Hugging Faceで公開されています
まとめ
- FP4(E2M1)で表せる値は15個しかなく、そのままでは幅広い値を表せない
- NVFP4は、16個ごとのFP8スケールとテンソル全体のFP32スケールの2段階で、表現の精度を上げている
- モデルは16ビット形式の約3.5分の1になり、精度の低下は多くの項目で1ポイント以内
- KVキャッシュにも使え、GPUに載せられる文脈の長さがおよそ2倍になる
連載「GPUメモリを無駄なく使う5つの方法」
あわせて読みたい
- FLUX 3 Image Klein:画像生成をBlackwellで3〜4倍高速化
NVFP4を画像生成モデルに適用し、処理時間を短縮した例
参考