汎用モデルに焦点を与えるのは人間の専門知識である ― ティム・オライリー「The Bitter Lesson vs. AI Markets for Human Expertise」を読む
この記事の要点
ティム・オライリーのエッセイ「The Bitter Lesson vs. AI Markets for Human Expertise」は、「計算資源で押し切る汎用手法が最後に勝つ」というBitter Lessonを認めたうえで、人間の専門知識に対価が流れる市場の仕組み(メカニズム)をAIの側に設計すべきだと主張する。要点は3つある。
- LLMは知識を広く持つが、問題に焦点を合わせる力を持たない。焦点を与えるのは人間の経験と専門知識である。
- その専門知識を発見し、品質を確かめ、作り手に対価を払う仕組みが、今のAI産業には欠けている。
- MCPのような開かれたプロトコルは、Unixと同じ「参加のアーキテクチャ」をAIにもたらし、その仕組みの土台になりうる。
本記事では、エッセイの論点を整理し、前提となる用語(Bitter Lesson、トイル、メカニズムデザイン、参加のアーキテクチャ)を補足する。
元記事について
- 著者:Tim O’Reilly(O’Reilly Media 創業者)
- 初出:Substack「Asimov’s Addendum」。O’Reilly Radar に転載
- 成り立ち:2026年10月23日にサンノゼで開かれた AGNTCon + MCPCon North America の基調講演の前に収録された、AAIF Live での対談(聞き手 Demetrios Brinkmann)を Ilan Strauss が編集・再構成したもの。基調講演の内容も一部取り込んでいる
AAIF(Agentic AI Foundation)は、2025年12月に Linux Foundation のもとで設立された団体で、Anthropic の MCP、Block の goose、OpenAI の AGENTS.md を創設プロジェクトとして引き受けている。AGNTCon + MCPCon はその年次カンファレンスである。
前提:Bitter Lesson とは
強化学習の研究者リチャード・サットンが2019年3月に書いた短いエッセイである。70年のAI研究を振り返り、人間の知識を組み込む手法は短期的には成果を出すが、長期的には計算量に応じてスケールする汎用手法(探索と学習)に追い抜かれる、と結論づけた。根拠として挙げたのは、コンピュータチェス(深い探索が、チェスの知識を組み込んだ手法に勝った)、囲碁、音声認識(統計的手法、のちの深層学習が、音声学の知識に基づく手法に勝った)、画像認識である。「bitter(苦い)」は、研究者が自分の知識をシステムに組み込みたがる傾向が、繰り返し裏切られてきたことを指す。
オライリーはこの教訓を正しいと認める。そのうえで、AI業界が「AIを暴走させない方法」と「AIによる雇用喪失」は研究していても、「人間に新しい経済的機会を生む仕組み」は研究していない点を問題にする。
論点1:LLMは何でも知っていて、何も知らない
オライリーはAIを、文字・印刷・ウェブと続いてきた「知識を時間と空間を越えて共有する技術」の延長にある文化技術と位置づける。LLMは可能性の海であり、それを動かすのは人間の問いと文脈である。同じモデルに同じ調査を頼んでも、使う人の経験と与える文脈によって結果は変わる。
彼が引くのは、ジョン・カウパー・ポウイス『The Meaning of Culture』の教養の定義である。教養とは、学ぼうとしたことを忘れたあとに残るもの、つまり人それぞれが吸収した狭く固有な知識の層である。LLMはすべてを吸収しようとするため一般的になりすぎる。人間の固有な知識が、モデルにとってのレンズになる。
事例:増員か、トイルの監査か
O’Reilly Media の CTO アンドリュー・オデワーンは、IT部門の管理を支援する調査エージェントを作った。人手不足を訴える部署について分析させると、エージェントも増員が必要と答えた。次に、O’Reilly の専門家コンテンツを通して回答させるMCPサーバー(O’Reilly Expert Intelligence)を使い、「O’Reilly の専門家ならどう言うか」と聞き直した。するとモデルは、Google の『Site Reliability Engineering』(SRE本)の観点から問題を捉え直し、増員はかえって問題を悪化させる、まずトイルを監査し、組織を再編すべきだと答えた。
トイル(toil)はSRE本の用語で、本番システムの運用に伴う作業のうち、手作業で、繰り返し発生し、自動化でき、長期的な価値を残さず、サービスの規模に比例して増えるものを指す。トイルの多い組織に人を足しても、仕組みが変わらなければトイルが人数分に広がるだけである。SRE本は、SREの作業時間に占めるトイルを50%未満に抑えることを目標に掲げている。
重要なのは、SRE本の知識自体はもともとモデルの中にあった点である。回答を変えたのは知識の追加ではなく、「どの専門家集団の視点で考えるか」という指定だった。オライリーはこれを次の一文にまとめている。
“An LLM knows everything, and as a result it doesn’t know anything.” (LLMはすべてを知っているがゆえに、何も知らない)
論点2:マジックワードとコンテキストエンジニアリング
オライリーは以前「Magic Words」という記事で、一部の語は大量の文脈を背負っていると書いた。「GTD(Getting Things Done)」や「アイゼンハワー・マトリクス」と一語指定するだけで、利用者がその手法を知らなくても、モデルはタスクリストをその枠組みで整理する。SREの事例で「O’Reilly の専門家なら」と指定したのも同じ構造である。
ただし、呪文を知っていても正しく使えなければ魔法は暴走する。エージェントは任せれば走り続けるが、人間の望む方法で進むとは限らない。オライリーは自身のファインチューニング作業で、モデルが Mac 環境(既定のシェルは zsh)なのに bash を前提にし、同じ文脈の把握を何度もやり直した例を挙げている。
ここで紹介されているのが、セキュリティ企業 Trail of Bits のダン・グイドが公開したAI導入の方法論である。個人の生産性向上を組織の生産性に結びつけるため、全員の設定を統一する。統一しないと、エージェントが起動のたびに自分の置かれた環境を調べ直し、トークンを浪費する。失敗から得た教訓をシステムに組み込むことを、グイドは「傷跡をインフラに変える」と表現する。経験のある人間が持つ文脈を、毎回の対話ではなく環境として先に与えるという考え方である。具体的には、AGENTS.md や CLAUDE.md のようなリポジトリ単位の指示ファイル、共通のMCPサーバー設定、手順書としてのスキルをチームで共有する形になる。
論点3:Bitter Lesson はウェブの時代にもあった
O’Reilly は1993年に最初の商用ウェブサイト Global Network Navigator(GNN)を立ち上げ、その一部としてウェブのカタログを作った。当初のサイト数は約200で、出版社として良いサイトを選んで載せる方針だった。翌年に登場した Yahoo はすべてを載せようとして追いつけなくなり、最後に Google が、すべてをアルゴリズムで索引化し、あとから並べ替える方式で勝った。クレイ・シャーキーが「filter, then publish(選んでから公開)」から「publish, then filter(公開してから選ぶ)」への転換と呼んだ変化である。
そのうえでオライリーは、技術に何をさせるかの選択が決定的だと述べる。ユーザーが本当に探しているものを見つける技術は、やがて企業の利益を優先する方向へ変質した。コリイ・ドクトロウはこの過程を enshittification(プラットフォームの劣化)と呼んだ。AIのアラインメントも、突き詰めれば「人間が大事にするものをシステムにも大事にさせる」問題である。
論点4:価値を作り手に循環させる仕組みがない
Anthropic は2025年、モデル学習のために海賊版書籍をダウンロードした件の集団訴訟(Bartz v. Anthropic)で、15億ドルの和解に合意した。オライリーは、他のAI企業が同様の責任をまだ問われていないことに驚きを示している。
対比として挙げられるのが YouTube の Content ID である。2007年に導入されたこの仕組みは、権利者がアップロード動画内の自分の楽曲や映像を検出し、ブロックするか、公開を認めて広告収益を受け取るかを選べるようにした。多くの権利者が収益化を選び、それがクリエイター経済の土台の一つになった。削除要請と訴訟の対立を、収益分配の仕組みに置き換えた例である。
AI業界は同じ挑戦をせず、自社の収益化を先に考えた。オライリーは NotebookLM の公開前に開発チームへ、自分のサービスに組み込んで収益化できるようにしてほしいと提案したが、チームの関心は Google への送客だった。彼の指摘は、プラットフォームは「自分がどう稼ぐか」ではなく「利用者がどう稼ぐか」を設計すべきだ、というものである。Substack の寄付・購読ボタン程度の機能で足りた、とも述べている。
AIプラットフォームを作る者は経済圏を作っており、その中でお金が循環しなければならない。人間の仕事を置き換え続ければ顧客がいなくなる。オライリーは、この問題はハルシネーションよりはるかに深刻だと位置づけている。
前提:メカニズムデザインとは
ゲーム理論は、与えられたルールのもとで参加者がどう行動するかを分析する。メカニズムデザインはその逆で、望ましい結果を先に決め、参加者が自分の利益を追求した結果としてその状態に至るようなルールを設計する。このため「逆ゲーム理論」とも呼ばれる。2007年には、ハーヴィッツ、マスキン、マイヤーソンがこの分野の基礎を築いた功績でノーベル経済学賞を受賞した。
アルビン・ロスは2012年、ロイド・シャプレーとともに、安定配分の理論とマーケットデザインの実践で同賞を受けた。ロスの代表的な仕事が腎臓交換である。血液型などが合わず家族に腎臓を提供できないドナーと患者のペアを複数組み合わせ、互いの相手に提供し合う交換を成立させる。参加したほうが得になるルールにすることで参加者が増え、移植件数が増える。研修医と病院のマッチング制度の改良もロスの仕事として知られる。
オライリーは、新しい技術には新しいメカニズムが必要だが、優れたメカニズムは経済学者ではなく、使う人々が偶然見つけてきたものだと言う。そしてAIについて次の問いを立てる。
- エージェントは最良の専門知識やスキルをどう発見し、その品質をどう確かめ、作り手にどう対価を払うのか
- 最も多く払う者へ誘導するプラットフォームに頼らず、サービスをどう見つけるのか
答えはまだない。能力の向上には巨額が投じられているが、その能力を他の人々の機会に変える仕組みには、ほとんど労力が割かれていない。
論点5:Unix と MCP ― 参加のアーキテクチャ
オライリーは、オープンソースを成立させたのはフリーソフトウェアのライセンスではなく、Unixの設計だったと見る。ケン・トンプソンとデニス・リッチーがベル研究所で作ったUnixは、AT&Tのプロプライエタリなライセンスのもとにあったが、多様なハードウェアで動くように設計されていた。
- カーネルが小さい。数十種類の機種に移植する必要があったためである
- その周りに小さなユーティリティが並び、プレーンテキストの読み書きと、パイプによるストリームの受け渡しという共通の約束に従って協調する
- 誰でも小さな部品を書けば、システムの一級市民になれる
- ある機種でコンパイルしたバイナリは別の機種で動かないため、ソフトウェアはソースコードで共有された
その後、Unixの部品はほぼすべて置き換わった。ハードウェアも、カーネル(Linux)も、シェルも変わった。残ったのはルールである。オライリーはこの構造を「参加のアーキテクチャ」と呼ぶ。
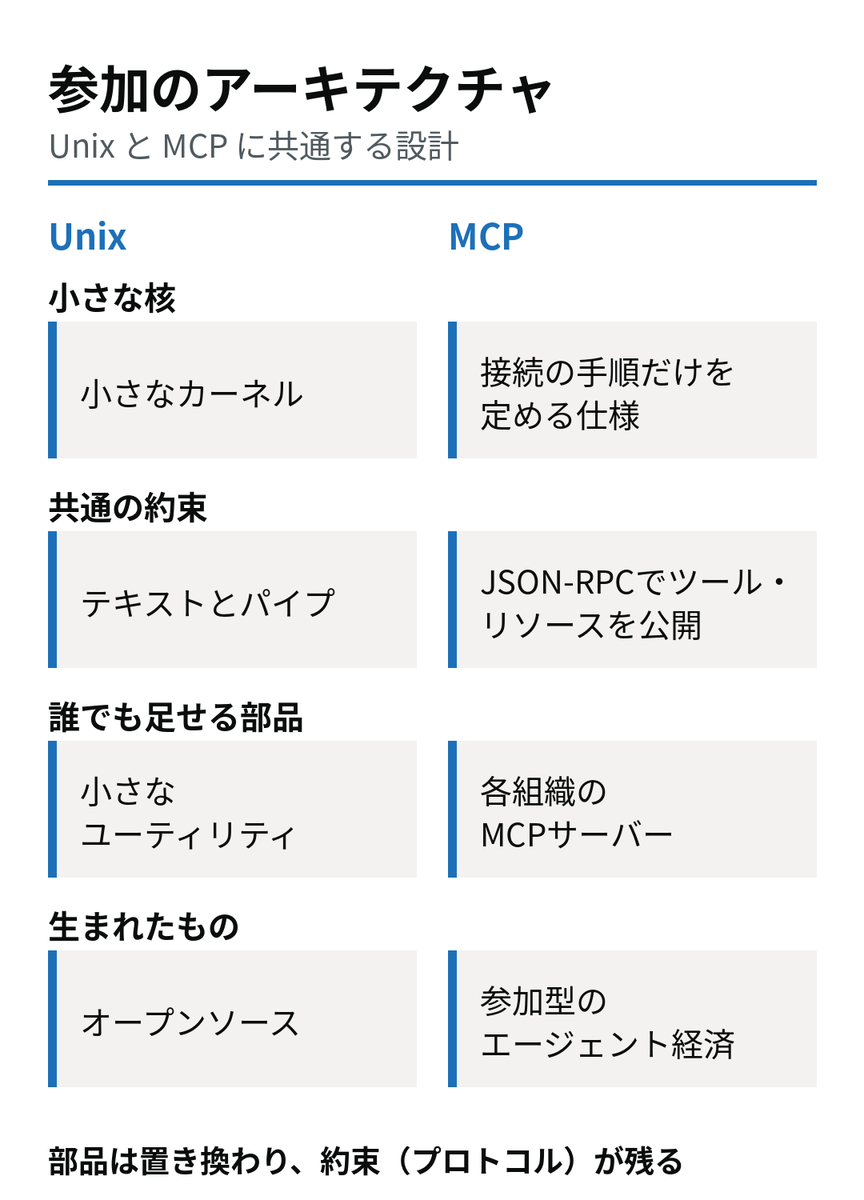
彼はMCPを、AIにおける参加のアーキテクチャであり、偶然生まれたメカニズムデザインの成果だと評価する。当初のAIは、PCのWindowsやスマートフォンのiOS/Androidのように、一つの巨大な知能をみんながAPI経由で呼ぶ中央集権型の構図に見えた。MCPは、どのモデルからでも誰のツールやデータにでも接続できる共通の約束を定めた。これによりエージェントの世界は、オープンソースやウェブのような参加型の経済圏の形を取り始めた。
MCP は Anthropic が2024年11月に公開したオープンな標準で、AIアプリケーション(クライアント)と外部のツールやデータ(サーバー)を JSON-RPC で接続する。サーバーはツール、リソース、プロンプトを公開し、クライアントは接続先を問わず同じ手順でそれを利用する。Unix のテキストとパイプに相当する「共通の約束」がこのプロトコルであり、各組織が公開するMCPサーバーが小さなユーティリティにあたる。論点1の O’Reilly Expert Intelligence も、専門家の知識をこの約束に乗せ、任意のモデルから使えるようにしたものである。
オライリーはさらに、AIが利用者について知っている文脈をツール間で持ち運べる「ポータブルメモリ」の標準化にも取り組んでいる。
論点6:どのゲームを遊ぶのか
メカニズムデザインは、望む結果を決めるところから始まる。オライリーは、いまAI市場で行われているゲームを「超知能の獲得競争」と描く。勝者総取りのゲームであり、それを支える仕組みとして次のものを挙げる。
- 巨額のデータセンター投資(資本力のある者しか参加できない)
- 既存の知的財産の収奪
- 高価なAPIでのモデル提供と、出力からの学習を禁じる利用規約
- 回答への広告の混入
- 利用者の文脈を一社に閉じ込めるメモリ
彼が提案するゲームは「人間の繁栄」である。人々が互いに創り、共有するための新しい手段(アフォーダンス)を増やし、人間とそのエージェントの間で価値が循環する経済を作る。人間はAIに置き換えられるのではなく、AIと協働する。
大手ラボは、動機がどうであれ、調達した巨額の資本を回収するという金融システムの要請に縛られている。その意味でAIは最初から劣化の圧力を抱えている。だからこそ、誰でもダウンロードして動かせるオープンモデルと、国ごとに構築・管理するソブリンAIが重要になる。オープンモデルは最先端のクローズドモデルにまだ及ばないが差は縮まり続けており、すでに多くの実務に十分な性能を持つ。オープンソース、オープンプロトコル、オープンメモリが、利用者に技術を自ら形作り制御する自由を与える。
エンジニアとして読むときの論点
- Bitter Lesson と人間の専門知識は矛盾しない。Bitter Lesson が扱うのはモデルの汎用能力の獲得方法であり、オライリーが扱うのは、その能力を特定の問題に向ける焦点の与え方と、焦点を提供した人への対価である。前者はスケールが決め、後者は設計が決める。
- 専門知識の価値は「知識の量」から「視点の指定」へ移っている。SREの事例でモデルの答えを変えたのは新しい情報ではなく、参照すべき専門家集団の指定だった。専門知識をMCPサーバーやスキルの形で呼び出せるようにしておくことが、知識を使える状態に保つ実装になる。
- エージェントの性能は環境設定で決まる部分が大きい。設定の統一、指示ファイル、失敗事例の取り込みは、モデルの更新を待たずに改善できる領域である。
- 帰属と対価の仕組みは未解決である。MCPは接続の約束を定めたが、どの知識が回答にどれだけ寄与したかを測り、作り手に支払う約束はまだない。Content ID が検出と収益分配を組み合わせたように、AIでも寄与の計測と支払いを組み合わせたメカニズムが必要になる。
出典
- Tim O’Reilly「The Bitter Lesson vs. AI Markets for Human Expertise」(Asimov’s Addendum/O’Reilly Radar、2026年)
- Richard Sutton「The Bitter Lesson」(2019年) http://www.incompleteideas.net/IncIdeas/BitterLesson.html
- Betsy Beyer ほか『Site Reliability Engineering』第5章「Eliminating Toil」 https://sre.google/sre-book/eliminating-toil/
- Linux Foundation「Agentic AI Foundation の設立」(2025年12月9日) https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation
- Model Context Protocol https://modelcontextprotocol.io/