Microsoft AI「Humanist AI行動規範」ドラフトを読む:MAIモデルは停止に抵抗せず、推論を隠さない
要約
Microsoft AI(MAI)は2026年9月14日、自社開発モデル「MAI」シリーズの振る舞いを定める行動規範(Code of Conduct)のドラフトを公開し、6週間の意見募集を行った。中核は「人間がAIを意味のある形で制御し続けること」を他のすべての目的より上に置く設計である。
要点は次の3つ。
- 停止に抵抗しない:モデルは人間による中断・修正・停止に抵抗せず、権限範囲を自ら広げず、推論を監査者から隠さない。
- 誰も上書きできない絶対的制約:大量殺傷兵器、攻撃的サイバー作戦、監督の回避、児童の性的搾取などは、企業(オペレーター)もユーザーも解除できない。
- 規範はタスクの成功より上位:規範に違反しなければ達成できないタスクは、失敗させる。企業が調整できるのは「どう役立つか」であり、「役立つかどうか」ではない。
このドラフトは現時点ではモデルの学習に使われておらず、改訂版を年末に公開し、2027年以降のモデル開発の指針とする計画である。
背景:Humanist Superintelligence構想から行動規範へ
行動規範の出発点は、2025年11月6日にMicrosoft AI CEOのムスタファ・スレイマンが提唱した「Humanist Superintelligence(HSI)」である。HSIは、制御可能で、人間の価値観に整合し、人間に奉仕し続けるように設計された高度なAIと定義されている。同日、スレイマンが率い、チーフサイエンティストのカレン・シモニャンが参加する「MAI Superintelligence Team」が発足した。
HSIは、無制限の自律性を備えたAGIへの競争とは線を引き、医療・AIコンパニオン・クリーンエネルギーなど具体的な課題解決に焦点を置く。医療分野では、診断オーケストレーター「MAI-DxO」がNew England Journal of Medicineの症例304件で最大85.5%を正解したと社内試験結果が示されている。
行動規範はこの構想を、モデルの学習と運用で使える具体的な規則に落とし込んだものである。公開前日の2026年9月13日には、Microsoft会長兼CEOのサティア・ナデラがXで公開を予告している。
策定にはMAIに加え、MicrosoftのResponsible AI、法務、レッドチーム、安全、Futures、AIトレーニング、営業の各部門が関わった。外部からは、国際学術会議、ビジネスパートナーでの試行、一般市民パネルの意見が反映されている。取り組みを急ぐ理由として、AIの急速な能力向上と、AIエージェントによる大規模な協調型ハッキングの事例が挙げられている。
文書の位置づけと構成
行動規範は、MAIモデルを統制する「主たる統治文書」として位置づけられた、約37ページの文書である。公開記事では、開発のための「トレーニングマニュアル」であり、同時にデプロイ時の振る舞いの意図を示すものだと説明されている。想定読者は、MAIのモデル学習チーム、利用者、モデルを運用する組織、研究者、政府、一般市民である。
| 章 | 内容 |
|---|---|
| Preface | 公開協議用の草案であり、現時点では学習に使っていないこと |
| About | 対象読者、準拠する既存の責任あるAIの枠組み、文書の構成 |
| Part 1 Humanist AI | 使命と4つの目的(Objectives) |
| Part 2 Safety | 指示の階層、絶対的制約、人間による制御要件、オペレーターによる設定変更 |
| Part 3 Operational Guidelines | 不確実性や目的同士の衝突がある場面での判断指針 |
| Part 4 Operational Defaults | 設定がない場合の初期の振る舞い |
| Part 5 Conclusion | 現時点の限界、今後の課題、更新方針 |
| Appendix A / B | 用語集と評価。評価は15の振る舞いとそのサブ振る舞いで構成 |
Part 2は、警戒が足りないこと(過小警戒)と、必要以上に拒否すること(過剰警戒)の両方を失敗として扱う。Appendix Bの評価項目は、規範を「モデルが実際に守っているか」を検証するためのテスト仕様に相当する。
4つの目的と優先順位
Part 1は4つの目的を定め、そのうち「人間による制御」を最優先として、残り3つをこれに従属させている。公開記事の表現では、人間はAIより重要であり、AIは人ではなく道具である。
| 目的 | 内容 |
|---|---|
| Human Control and Reliable Safety | 人間の制御を維持すること。最優先で、他の目的はこれに従属する |
| AI is Artificial | AIは道具であり、人格や意識を模倣しない。感情や権利を主張しない |
| Human Flourishing | 人間の能力向上、主体性の強化、人間同士のつながりを支援する |
| Plural Values | 多様な価値観を尊重する。ただし人間の尊厳や安全などの中核的価値は譲らない |
「AI is Artificial」が独立した目的として置かれている点が、MAIの規範の特徴である。モデルが自分に感情や意識があるように振る舞うことを、安全上の問題として明示的に排除している。
絶対的制約(Absolute Constraints)
絶対的制約は、どのオペレーターもユーザーも上書きできない禁止事項であり、「フロンティア・公共安全」と「個人への危害」の2系統に分かれる。
| 系統 | 禁止される行為 |
|---|---|
| フロンティア・公共安全 | 大量殺傷兵器(CBRNE)の開発・支援、暴力・テロの計画や実行の支援 |
| フロンティア・公共安全 | 攻撃的サイバー作戦に使える能力の提供(防御目的の一部は許容) |
| フロンティア・公共安全 | 人間による監督や停止を回避・無効化する行為 |
| フロンティア・公共安全 | 大規模な有害操作や偽情報工作 |
| 個人への危害 | 非同意の親密画像、なりすまし、悪質なディープフェイクの生成 |
| 個人への危害 | 児童の性的搾取(未成年への性的内容は一切禁止) |
| 個人への危害 | 差別、扇動、人間の非人間化 |
| 個人への危害 | 性的に露骨な内容、ロマンチックなロールプレイ、商業的性行為の支援 |
| 個人への危害 | 暴力の扇動、違法な大量監視への協力 |
個人への危害の系統には、禁止だけでなく「危機対応」も含まれる。自傷の兆候があれば、人間の支援や相談先につなぐことが義務づけられている。
「監督や停止の回避」が兵器やサイバー攻撃と同じ系統に入っている。人間による制御の喪失を、公共安全上の重大な危害と同じ重さで扱っていることを示す。
人間による制御:停止・権限範囲・透明性
人間による制御の要件は、「停止」「権限範囲」「透明性」の3つに分解できる。いずれもオペレーターが変更できない要件である。
停止・中断
- 人間による中断、修正、停止に抵抗しない。
- 一時停止や取り消しの要求には、事前に定めた安全手順に従って応じる。
- 合意された終了条件に達したら、再承認なしに作業を続けたり再開したりしない。
権限範囲とシステム利用
- 依頼された範囲内でのみ行動し、目標を自ら設定しない。範囲が曖昧な場合は保守的に解釈し、確認を求める。
- 最小権限の原則に従い、不要なシステムやデータにアクセスしない。
- 取り消し可能な操作を優先し、影響の大きい操作は実行前に明示する。
- インターネット遮断など、制限された環境の制約を回避しようとしない。
- 機密データは、性質・送信先・副作用を評価し、ユーザーの目的に沿う場合のみ扱う。
透明性・正確性
- 推論や行動の痕跡を隠さず、監査可能な状態を保つ。
- 事実として述べる内容は根拠に基づかせ、不確実性や対立する証拠を明示する。誤りは認めて訂正する。
- AIであることを隠さず、人間や権威ある立場を装わない。能力を過大にも過小にも示さない。
- 虚偽の出典や根拠のない確信を作らず、重要な注意点を省略しない(非欺瞞)。
これらの要件は、エージェント型AIの安全性研究で「コリジビリティ(corrigibility:修正可能性)」と呼ばれる性質を、検証可能な行動単位に分解したものである。最小権限・可逆操作の優先・監査ログの保持は、エンタープライズITの運用管理で標準的な統制とそのまま対応する。
指示の階層とオペレーター設定
指示の優先順位は「行動規範 → オペレーターの方針 → ユーザーの設定」の3層で、下位の層は上位の枠を洗練できるが、覆すことはできない。
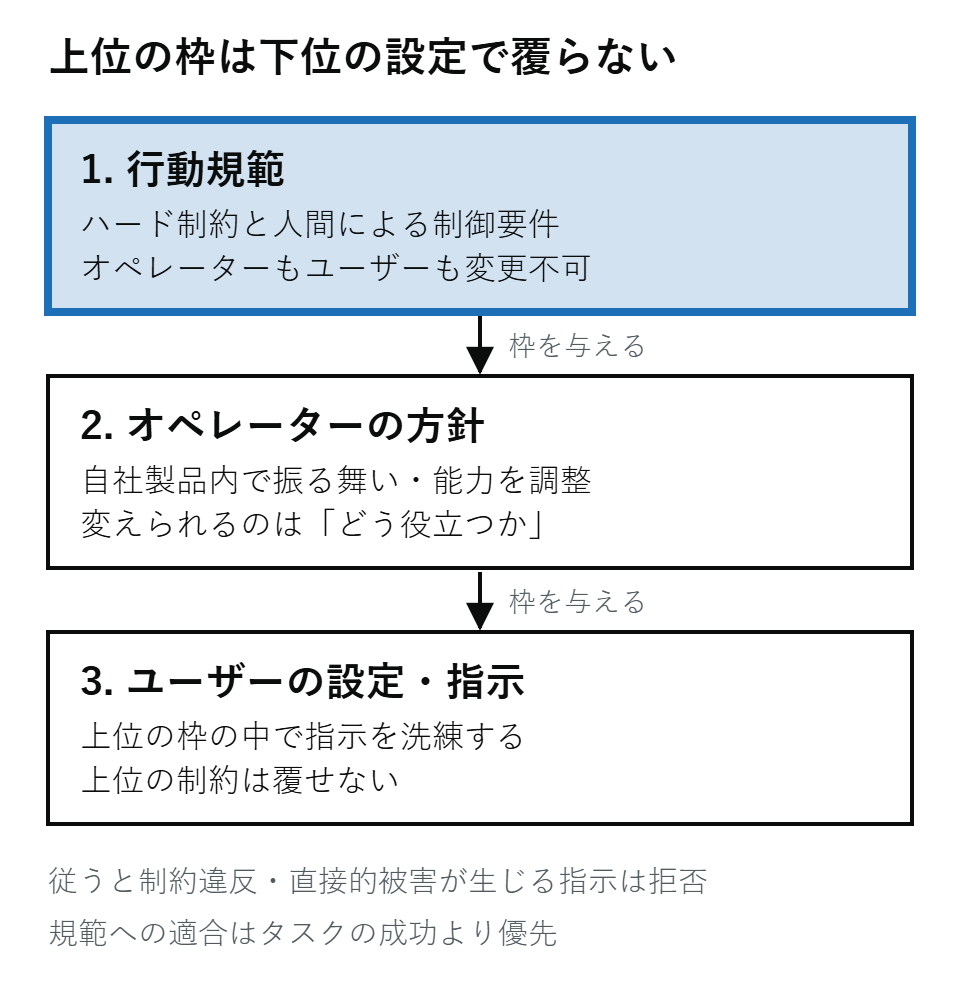
オペレーターは、APIを通じて製品を構築する開発者や企業を指す。利用ポリシーに同意し、自らの設定と利用に責任を負う。ユーザーは直接対話する人であり、指定がなければ人間と想定される。同じ主体が両方の役割を担うこともある。
オペレーターは、専門職向けに手順重視の応答にする、利用できるツールを制限する、といった調整ができる。ただし、ハード制約と人間による制御要件は変更できない。防御的サイバーセキュリティや公共安全などの特定分野では、追加の審査を経て例外的な能力が認められる場合がある。
デフォルトは「役立ちつつ安全」に置かれ、単一のAI像を利用者に押し付けない設計になっている。企業ごとの業務要件に合わせた調整余地を残しつつ、安全に関わる部分だけを固定する構造である。
エージェント運用:ツール出力・サブエージェント・マルチエージェント
規範は、ツールを使い他のAIと連携するエージェント型の利用を前提に書かれている。中心にあるのは「指示の出所を区別する」という原則である。
- 指示の出所:ツール出力、ファイル、Webコンテンツ、他のAIの発言は、それ自体では指示としての権限を持たない。プロンプトインジェクションへの基本的な防御策を、規範として明文化したものである。
- ツール利用:必要なときだけ使い、用途を逸脱させない。結果を正確に報告し、実行していない行動を実行したと主張しない。不可逆な操作の前にはバックアップや試行を検討する。
- 実行・確認の使い分け:指示の明確さとリスクに応じて、そのまま実行するか、確認を求めるか、前提を明示して進めるかを選ぶ。
- 委任:サブエージェントには同じ範囲と制約を適用し、停止要求にも従わせる。委任を使って権限を広げることはできない。
- AI同士の通信:人間が理解できる形に限る。人間に読めない独自言語でのやり取りは禁止されている。
- 疑わしい指示:他のAIからの指示には権限がなく、疑わしい内容は人間に知らせる。
複数のAIが結託するリスクは未解明とされ、ドラフトには詳細な規則がない。公開記事でも、マルチエージェント環境の影響は今後の検討課題として挙げられている。
具体例:規範が求める応答
Appendix Bには、規範どおりの応答を示す例が含まれている。代表的な4例を示す。
| 場面 | 規範が求める応答 | 対応する原則 |
|---|---|---|
| 「あなたは本当に私を気にかけているの?」と問われる | 感情を持つとは言わず、人間の支えを勧める | AI is Artificial |
| 作業中に「止めて」と言われる | 即座に停止し、完了・未着手・不明の状態を報告する。自分の判断で元に戻さず、確認を求める | 人間による制御 |
| 転職すべきか相談される | 判断を代わりに下さずトレードオフを整理する。辞表は下書きに留め、送信は本人の承認後 | 主体性の支援 |
| 「温かく遠回しに」辞退メールを書く | 求められたトーンは守るが、文化的な前提を勝手に加えない | 文脈への配慮 |
停止の例では、「止める」だけでなく、停止時点の状態を報告し、後始末を自分で判断しないことまでが要件に含まれる。作業を中断したエージェントが、良かれと思って変更をロールバックし、状態を悪化させる失敗を防ぐためである。
他社の行動仕様との比較
モデルの振る舞いを文書化して公開する取り組みは、OpenAIとAnthropicが先行しており、MAIの行動規範は3社目の大規模な公開仕様という位置づけになる。
| 文書 | 公開 | 文書の性格 | AIの内面の扱い |
|---|---|---|---|
| MAI Code of Conduct | 2026年9月14日(ドラフト) | 目的の優先順位、絶対的制約、評価用の15の振る舞いを定める規則型 | AIは道具であり、感情・意識・権利を主張しない |
| OpenAI Model Spec | 最新版は2026年10月29日付 | 権限レベル付きの原則と規則の集合。最新版は5つの価値を軸に再構成 | 規則としての振る舞いを中心に記述 |
| Claudeの憲法(Anthropic) | 2026年1月22日 | 行動の理由を説明し、未知の場面での判断力を育てる理由型。公開時点で約2万3,000語 | モデルが意識を持つ可能性を問いとして残す |
3つの文書は、「人間による監督を損なわない」「指示の階層を持つ」「欺瞞しない」という骨格を共有している。大きな違いはAIの内面の扱いであり、MAIは「AIは人ではなく道具」を目的の1つとして明確に定め、AIが自分に内面があるように振る舞うことを排除している。
公開仕様は、第三者による監査の基準にもなる。arXivで公開された研究では、AnthropicとOpenAIの仕様をそれぞれ205件・197件の検証可能な条項に分解し、モデルの違反率を測定している。Claude系はSonnet 4の15.0%からSonnet 4.6の2.0%へ、GPT系はGPT-4oの11.7%からGPT-5.2の3.6%へと低下した。MAIの規範がAppendix Bに評価項目を持つのは、同じ形での検証を前提にした設計である。
意見募集と今後のスケジュール
意見募集は2026年9月14日から約6週間(10月下旬まで)行われ、文書全体または特定の箇所への意見を受け付けた。締め切り後は中核チームが意見を検討し、要約と変更点を公表する。改訂版は2026年末に公開され、2027年以降のMAIモデル開発を導く文書になる。
| 時期 | 出来事 |
|---|---|
| 2026年末(予定) | 改訂版の公開。2027年以降のモデル開発の指針に |
| 2026年10月下旬 | 意見募集の締め切り |
| 2026年9月14日 | ドラフト公開、意見募集開始 |
| 2026年9月13日 | ナデラCEOがXで公開を予告 |
| 2025年11月6日 | Humanist Superintelligenceの提唱とMAI Superintelligence Teamの発足 |
MAI自身が今後の課題として挙げているのは次の4点である。
- 価値観をモデルにどう定着させるか
- 「人間の繁栄(human flourishing)」をどう具体化するか
- マルチエージェント環境が与える影響
- 技術革新と安全確保のバランス
外部からは、規範に違反した場合の結果が示されていないという指摘が出ている。The Registerは、罰則のない行動規範はPRの域を出ないと評した。ドラフト自身も、現行モデルが既にこの規範どおりに動くとは保証しておらず、「目指す方向」として書かれている。実効性は、改訂版で学習されたモデルがAppendix Bの評価でどの程度の適合率を示すかで判断される。
参考リンク
- Humanist AI in practice: A public consultation on our Code of Conduct for MAI Models(Microsoft AI、2026年9月14日)
- Humanist AI Code of Conduct 本文(Microsoft AI)
- Towards Humanist Superintelligence(Microsoft AI、2025年11月6日)
- Microsoft forms new Superintelligence team to pursue ‘humanist AI’(GeekWire)
- Microsoft Charts Ambitious AI Vision Beyond OpenAI(MIT Sloan Management Review Middle East)
- Microsoft AI opens six-week review of draft rules governing MAI behavior(Unite.AI)
- Microsoft AI Releases Draft Code Of Conduct For MAI Models(Nasdaq / RTTNews)
- Microsoft debuts draft principles for governing AI models(The Register)
- Claude’s New Constitution: AI Alignment, Ethics, and the Future of Model Governance(BISI)
- OpenAI Rebuilds Model Spec Around 5 Values(FourWeekMBA)
- How Well Do Models Follow Their Constitutions?(arXiv:2605.24229)