Anthropicはなぜgitを置き換えたのか:エージェント規模のソース管理「Scion」の設計
Anthropicは、AIエージェントが書くコードの量に既存のgit基盤が追いつかなくなったため、「クライアントは常時オンライン」を前提にした社内専用のバージョン管理システムScionを作り、モノレポを5か月でgitから全面移行した。
要点は3つある。
- 規模:1日のマージ数は2026年5月の約2,500件から、9月には3万件超へ12倍に増えた。CIのチェックアウトは1日約2,500万回に達する。
- 設計転換:gitの「各クライアントが全履歴を持つ分散型」をやめ、履歴と計算をサーバーに集約した。クライアントは必要なディレクトリだけを取得する。
- 成果:チェックアウトは数分から数秒になり、CIのCPU容量を25%削減した。基盤のCPU・メモリ使用量は旧gitミラー基盤の200分の1になった。
本記事は、KodeKloudの解説動画「Why Git Wasn’t Enough for Anthropic!」(2026年10月14日公開)の内容を、Anthropicのエンジニアリングブログ「Redesigning source control at Anthropic」(2026年10月13日公開)で補って整理したものである。
1. 背景:ボトルネックはコードを書く工程から、書いた後の工程へ移った
Anthropicでは、コードを書くこと自体はもはやボトルネックではない。Claudeが研究ループの反復、プログラムの最適化、新サービスの構築を自律的に進めるため、詰まるのは「人間の速度に合わせて作られた開発基盤」、つまりソース管理・ビルド・CIである。
| 時期 | 1日あたりのマージ数 |
|---|---|
| 2026年5月 | 約2,500件 |
| 2026年9月 | 3万件超(12倍) |
Anthropicはこの伸びが止まらないと見ている。マージしたいコードの潜在需要は事実上無限であり、ボトルネックを1つ取り除くたびにコード量がさらに増えるからである。
2. gitが合わなくなった理由
2-1. gitは「全員が完全なコピーを持つ」設計である
gitは分散型のバージョン管理システムである。clone(複製)したリポジトリは単独で完結しており、ネットワークがなくても差分の計算、履歴やblame(各行を最後に変更したコミットの特定)の参照、任意の版のチェックアウトができる。オフラインで作業する開発者が多数いる一般的なプロジェクトでは、これが最適な設計であり、gitが標準になった理由でもある。
2-2. Anthropicのモノレポでは、この設計が負担になる
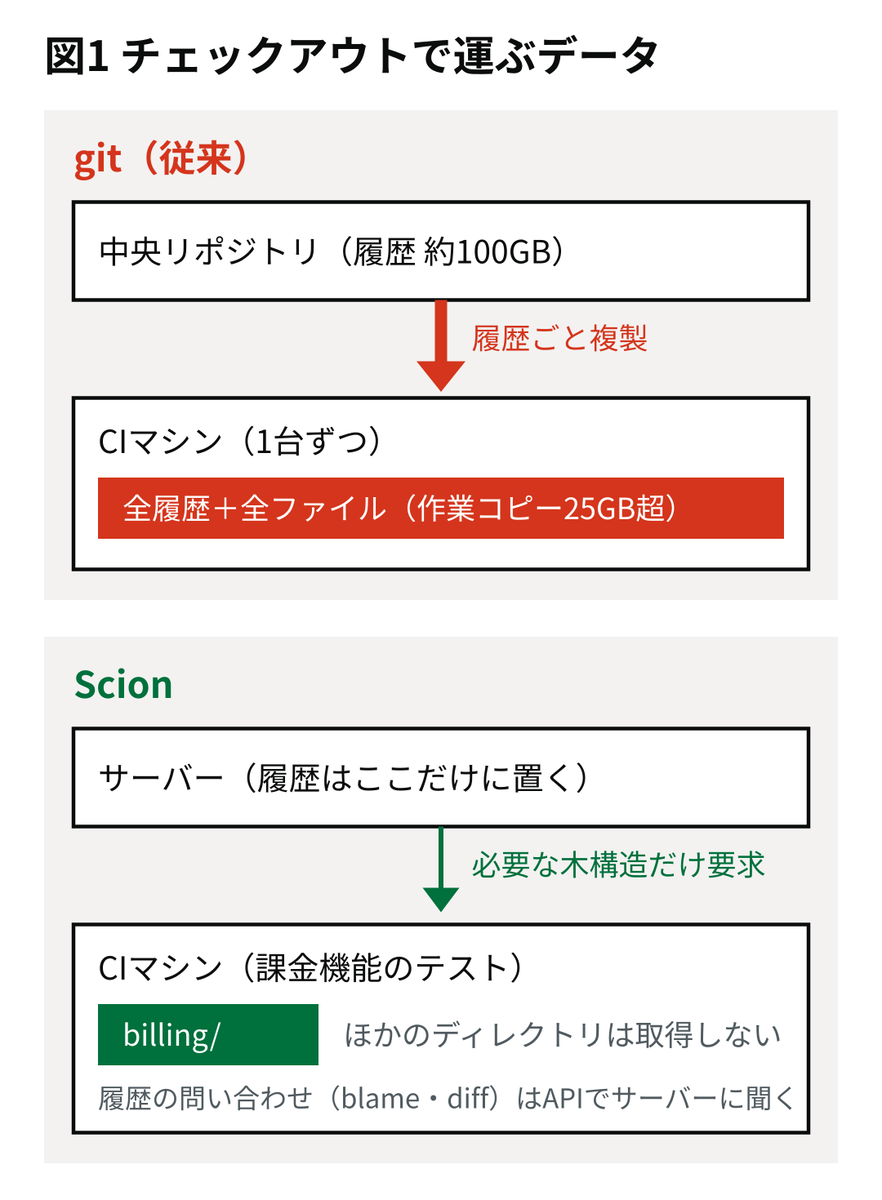
Anthropicのモノレポ(全社のコードを1つに集めたリポジトリ)の規模は次のとおりである。
| 項目 | 規模 |
|---|---|
| mainブランチの履歴 | 約100GB |
| 圧縮した作業コピー(最新ファイル一式) | 25GB超 |
| CIのチェックアウト回数 | 1日あたり約2,500万回(開発環境・エージェント用サンドボックス・研究ジョブは別) |
| 素朴にgitで取得した場合の通信量 | 1日あたり600PB超 |
CI(継続的インテグレーション)は、変更をmainに取り込む前後にテストを自動実行する仕組みである。テストを実行するマシンはリポジトリを手元に展開(チェックアウト)する必要がある。gitのまま1回ごとに全体を取得すると、1日600PBという現実的でない通信量になる。
2-3. gitの部分取得機能と運用上の回避策も限界に達した
gitにも大規模リポジトリ向けの機能はある。
- shallow clone:直近の履歴だけを取得する
- sparse checkout:一部のディレクトリだけを作業コピーに展開する
- promisor remote(partial clone):オブジェクトを必要になった時点で遅延取得する
運用面でも、社内gitミラーの多重化や、リポジトリのスナップショット(seed)をblob storageに置いて配る方法が定番である。Anthropicはこれらをすべて使い、ピーク時には社内gitミラーを数百台運用していた。しかしマージ数が増えるにつれ、次の問題が拡大した。
- seedを更新する間にもmainが進むため、seedとmain先端との差が開き続ける
- 部分取得したクローン上で、履歴に依存する操作(diff・blame)を正しく動かす手間が増える
- リポジトリがミラーのディスクやメモリの上限を超え、ミラーを増やしても拡張できなくなる
2-4. 根本原因:クライアントが常時オンラインなのに、オフライン前提の仕組みを使っていた
Anthropicはここで前提を見直した。多くの企業と同じく、実態は「正本が1つある集中型」としてgitを使っていた。しかもクライアントのほとんどはエージェントとCIジョブであり、定義上つねにオンラインである。オフライン作業のためにgitが全クライアントへ履歴を配る仕組みは、この環境では不要なデータ転送を生むだけになっていた。
そこでAnthropicは「エージェントが常時オンラインである前提でソース管理を設計し直したら、どうなるか」という問いからScionを作った。
3. Scionの設計原則
Scionは、巨大モノレポ向けソース管理の先行事例であるGoogleのPiperと、MetaのSapling(特にサーバー側のMononoke)の知見を取り入れている。設計原則は次の6つである。
| 原則 | gitとの違い |
|---|---|
| クライアントは常時オンライン | gitはオフライン作業のため完全なコピーを配る。Scionは常に到達できるサーバーを前提に、必要なときに必要なデータだけを取得する |
| クライアントとサーバーの非対称 | gitではどのクライアントも完全なサーバーになれる。Scionでは履歴・blameの回答、コミット作成、merge・rebaseをすべてサーバーが行う。クライアントは上限つきのローカルキャッシュを持ち、作業ファイルを配置し、変更を監視するだけである |
| ソース管理をAPIとして提供 | クライアントが使う問い合わせはすべてAPIでも公開する。多くのジョブはローカルリポジトリなしで動く。自動bisect・自動revertのパイプラインは、この安価なAPIがなければ実用にならない |
| すべて水平スケール | リポジトリのデータは分散配置し、各コンポーネントを独立に増強できる。サーバー上にも完全な複製はない。packfile(gitの圧縮オブジェクト束)がないため、リポジトリの保守作業も不要である |
| コミットは安価・増分・ロックなし | コミット・rebase・mergeはサーバー上で行うため、pushがない。処理コストはリポジトリ全体ではなく変更の大きさに比例させる。ブランチやタグなどのref(コミットへのポインタ)は、mainとリリースブランチ以外では使わない運用にする。全サーバーが合意すべきグローバル状態は、スケールの障害になるからである |
| 作業コピーは任意、かつ部分的 | 差分が欲しいだけのCIジョブはサーバーに問い合わせればよく、チェックアウト自体を省ける。チェックアウトが必要な場合も、指定ディレクトリだけを展開するsparse checkoutと、読んだファイルだけを実体化する仮想化チェックアウトが基本である |
4. データ構造:changesetと派生データ
4-1. changesetは「変更点」だけを記録する
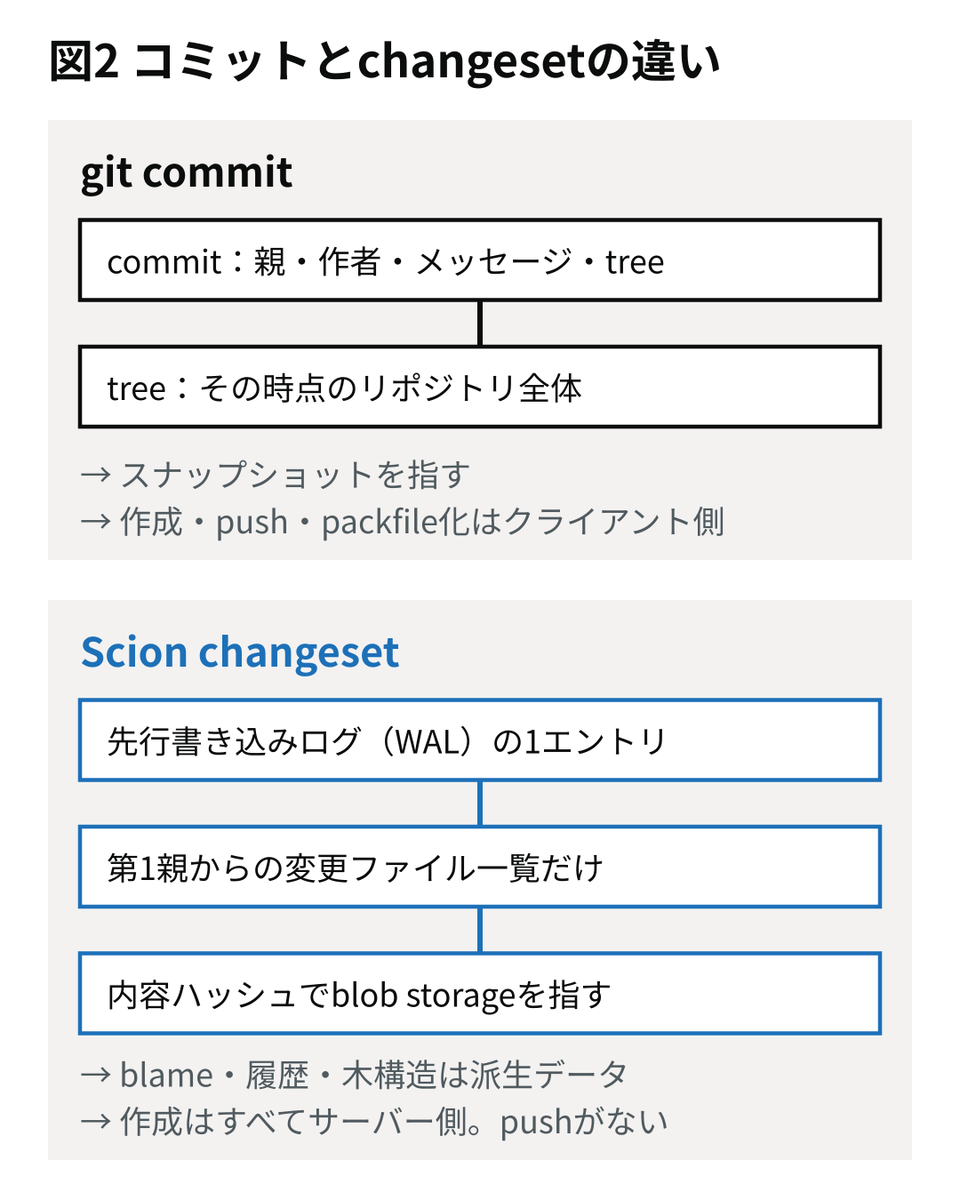
Scionの作業単位はchangesetである。changesetは先行書き込みログ(write-ahead log、WAL)の1エントリで、gitのコミットとほぼ同じ情報を持つ。違いは中身の指し方にある。
- gitのコミット:その時点のリポジトリ全体を表すtree(木構造)を指す
- Scionのchangeset:第1親から変更されたファイルの一覧と、圧縮済みファイル内容へのコンテンツアドレス(内容から計算したハッシュ値による参照)だけを持つ
changesetはサーバー側で作成され、作成した時点で全体から即座に参照できる。受け付ける際にpackfileの処理も、ロックも、サーバー間の調整も、refの更新も要らないため、非常に高いスループットでchangesetを受け付けられる。refを動かす操作は、Spanner(Googleの分散データベース)上の1行に対するcompare-and-swap(値が想定どおりのときだけ書き換える操作)であり、changesetの作成とは切り離されている。
なお「第1親との差分だけを記録する」のは意図的な選択である。トランクベース開発のモノレポでは、利用者が履歴やblameを必要とするのはmain上のコミットに限られるからである。
4-2. 履歴の問い合わせには「派生データ」で答える
changesetは変更点しか持たないため、それだけでは「この行を最後に編集したのは誰か」「このファイルに影響したコミットはどれか」に素早く答えられない。そこでScionは、changesetから次のような補助データ構造を作る。
- blame専用の構造
- パスごとの履歴
- コミットグラフを高速にたどるためのスキップリスト
changeset以外のこれらを派生データ(derived data)と呼び、すべて1つの汎用的な仕組みで計算する。各派生データは再帰的に定義されており、あるchangesetの値は親changesetの値から計算する。この仕組みには3つの利点がある。
- 新しい種類の派生データを簡単に追加できる。実際に、コピー検出やパスベースのファイル検索のための索引を後から何度も追加している
- 種類ごとに、先に計算しておくか、要求されたときに計算するかを選べる。不要なデータは作らない
- クライアントは派生データの内部構造を見ないため、クライアントを変えずにサーバー側だけで最適化できる
5. チェックアウトの仕組み
5-1. 「持っているもの」ではなく「欲しいもの」だけを伝える
gitのfetchでは、クライアントとサーバーが「クライアントが何を持っているか」をやり取り(ネゴシエーション)し、サーバーが不足分を計算して1つの巨大なpackfileにまとめて返す。この計算がgitサーバーのCPUを大きく消費する。
Scionのクライアント(scn)は逆の方式をとる。
- ルートのtreeから始め、ローカルにないtreeを再帰的に要求する
- 続いて、ローカルにないblob(ファイル内容)を要求する
すべての要求は「特定の、二度と変わらないオブジェクト」に対するものである。そのため、どの段のキャッシュでも応答でき、構成は一般的な多段キャッシュと同じ形になる。数GBのpackfileを1回で返す方式ではないため、途中で切れても再開できる。sparse checkoutや仮想化チェックアウトにも特別な対応は要らない。クライアントは要らないtreeを要求しないだけでよい。
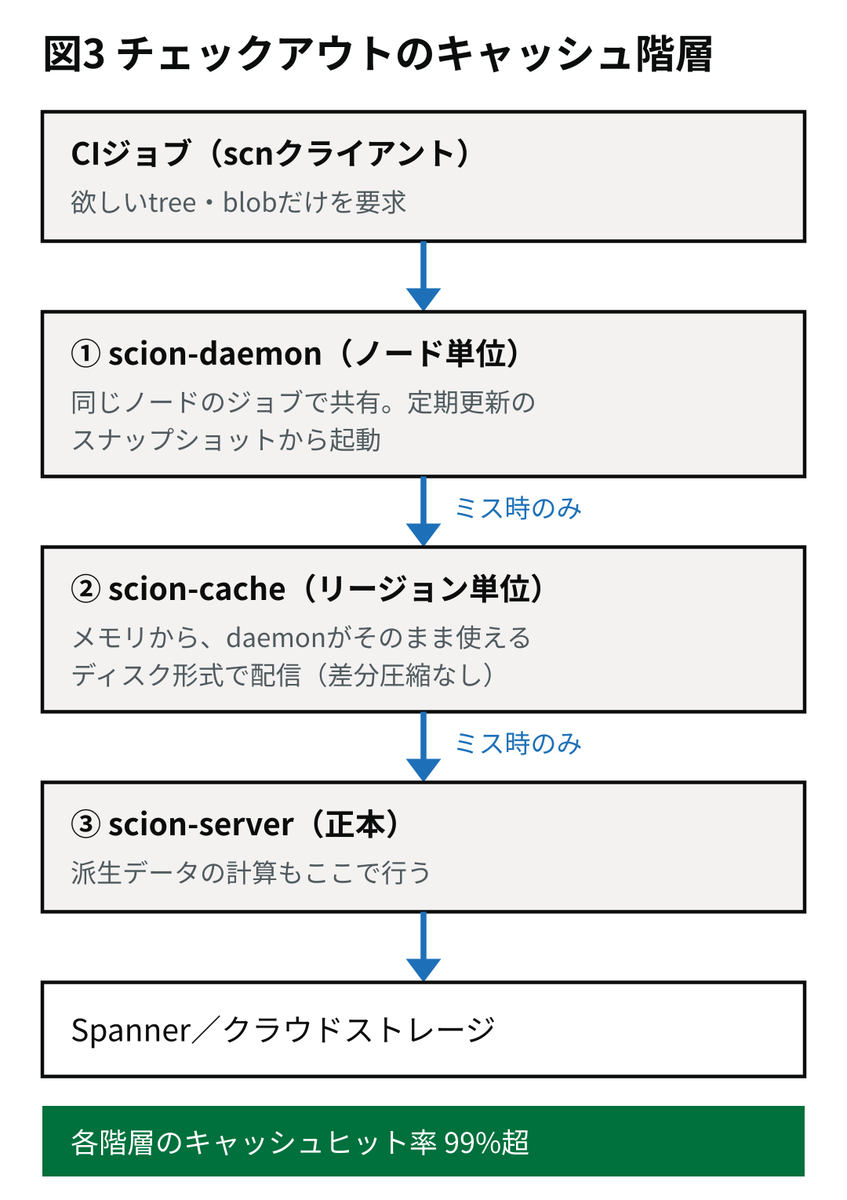
5-2. 3階層のキャッシュ
| 階層 | 役割 |
|---|---|
| ① scion-daemon(ノード単位) | 同じノード上のジョブがオブジェクトを共有する。定期更新のスナップショットから起動し、同一リージョンのscion-cacheとだけ通信する |
| ② scion-cache(リージョン単位) | treeとblobをメモリから配信する。daemonがそのまま使えるディスク形式で保持しているため、不足分の計算や差分圧縮をしない |
| ③ scion-server(正本) | キャッシュにないオブジェクトをSpannerやクラウドストレージから読む。派生データをその場で計算し、結果をSpannerへ書き戻す |
3つの階層はすべて同じRPCに応答するため、クライアントはキャッシュの構成を知らなくてよい。理論上はどの階層もどの階層とでも通信できるが、障害の影響範囲を分けるため、階層の順序を厳格に守らせている。あるリージョンのscion-cacheが故障したとき、上流のscion-serverに要求が殺到して全体が止まる事態を防ぐためである。
5-3. コンテンツアドレスがキャッシュを単純にする
すべてのデータはコンテンツアドレスで管理されるため、一度保存したデータは変わらない。内容が変われば別のIDになるので、キャッシュの無効化を考える必要がなく、どのサーバーも他と確認せずにキャッシュしてよい。サーバーは「派生データも計算できる大きなキャッシュ」として動き、ほとんど調整なしに水平スケールする。
各階層のキャッシュヒット率は99%を超える。どの階層も長期間保持すべき状態を持たないため、負荷に応じた増強も容易である。
6. 成果
| 指標 | 結果 |
|---|---|
| 基盤のCPU・メモリ使用量 | 旧gitミラー基盤の200分の1 |
| CI・研究ジョブのチェックアウト時間 | 数分から数秒へ(約100倍高速) |
| CIのCPU容量 | 25%削減 |
| リポジトリ保守作業 | クライアント・キャッシュともに不要 |
これらはAnthropic自身の社内ワークロードでの報告値であり、gitとの一般的なベンチマークではない。
7. 7人・5か月で作れた理由
ScionはAnthropicの7人のチームが5か月で構築し、同じ期間にコードレビューツールAntique、コード検索、ソース管理用の権限管理(IAM)基盤なども作って、モノレポを全面移行した。その間、1日のマージ数は10倍に増えている。従来であれば、大人数のチームが何年もかけて段階的に移行する規模の作業である。
7-1. Claudeが担った部分
- 書き直しによる最適化:年初に人手で書いたgit→Scionの取り込みパイプラインを、社内向けの早期版Claude Mythos Previewに追加指示なしで書き直させたところ、取り込み順序やデータ構造に関する暗黙の制約を保ったまま、メモリ使用量が20分の1、処理速度が4倍になった
- テストと防御の厚さ:短期間にもかかわらず、これまで遭遇したインフラとソース管理の相互作用をすべて再現する密閉型シミュレーション、ファジング、高度なレート制限を整備した
- 運用監視:Slack上のClaude(Claude Tag)に、コンポーネントを1つずつ専任で見張らせた。社内では「superfan」と呼び、テレメトリとログを常時確認して、従来型アラートでは捉えられない微細な異常を検知させている
7-2. エンジニアが担った部分
Scionを作ったエンジニアは全員、コードを書く能力ではClaudeが自分より上だと評価している。それでもエンジニアの役割は残った。システム間の関係の理解、設計上のトレードオフの判断、目標とする規模の見極めである。
特に多かった仕事は、Claudeに「やめろ」と言うことだった。エージェントは、そもそも許すべきでないパターンに合わせるために、システムの中核的な制約を破ることがある。移行作業ではたとえば、変更がmainに入った時刻を調べるのに、コードレビューツールに問い合わせず、コミットログを先頭から線形に読む実装が複数のシステムで現れた。
AIによる敵対的レビューも、仮定上の懸念に過剰反応して設計を複雑にする場合がある。ある社内サービスを信頼することへの過度に防御的な指摘を受け、Claudeが不要な検証処理を大量に追加した例があり、エンジニアが止めた。現在もすべての変更をチームが確認しているが、確認の対象は全行ではなく、変更の意図である。
7-3. 人間の速度を前提にした他の仕組みも見直している
テストの実行中に数百から数千の変更がマージされる環境では、マージキューをリポジトリ全体でロックする業界標準の方式が成り立たない。Anthropicはマージ後・デプロイ前の自動テストに投資する方式に切り替えた。並行する変更同士が衝突することはあるが、Claudeは人間が衝突に気づくより速く修正する。
セキュリティ面では、Scionはディレクトリ単位の権限設定に対応し、モノレポの利点を保ったまま機密性の高いコードを保護する。レビューツールは承認条件を意味のレベルで表現でき、コメントだけの変更と重要なロジック変更を区別して、人間のレビューを重要な変更に集中させている。
8. Scionは汎用のgit代替ではない
AnthropicはScionを公開する予定がなく、一般用途でgitを置き換えるものではないと明言している。理由は3つである。
- Scionの考え方が意味を持つのは、数万人のエンジニアや大量のエージェントがコードを書く巨大モノレポに限られる
- gitと大きく異なるため、導入には開発ライフサイクルのすべて(コードレビュー・コード検索・CI)を移行する必要があり、Anthropicの各ツールは社内向けに特化している
- Anthropicは社内利用に投じるトークン量が他社とは桁違いであり、その前提で成り立っている
一方でAnthropicは、同じ種類の問題が今後6〜12か月で多くの組織に広がると見ている。そのため、gitの枠組みを保ったままScionの考え方を取り込む方向を提案し、GitHub、GitLab、OSSコミュニティとの協力を表明している。提案の中身は次のとおりである。
- gitサーバーはgitクライアントと同じ作りである必要はなく、スケールに優れたサーバー構成を採れる
- gitホスティング各社が、blameや履歴の問い合わせをScion並みのサーバー側RPCとして提供する。可能であればホスティング間で標準化し、gitクライアントがそれを使えるようにする
- fetchのネゴシエーションプロトコルを見直す
- sparse・shallowなど部分取得系の機能を、組み合わせて使えるように整える
gitの「全員が完全なコピーを持つ」設計は、オフラインの人間の開発者には今も最適である。変わったのは、クライアントの大半が常時オンラインのエージェントになったことであり、Scionはその前提に合わせてソース管理を組み直した事例である。
参考
- Anthropic Engineering「Redesigning source control at Anthropic」(2026年10月13日)https://www.anthropic.com/engineering/redesigning-source-control
- KodeKloud「Why Git Wasn’t Enough for Anthropic!」(2026年10月14日)https://www.youtube.com/watch?v=7atGIcL-vRY
- The Register「Anthropic reinvents source control as Claude floods the world with code」(2026年10月13日)https://www.theregister.com/devops/2026/10/13/anthropic-reinvents-source-control-as-claude-floods-the-world-with-code/5302943
- InfoQ「How Anthropic Redesigned Source Control for AI-Driven Development」(2026年10月)https://infoq.com/news/2026/10/anthropic-source-control