GitHubのアーキテクチャ刷新とAzure移行を解説|AIエージェントで書き込み5倍、Git基盤を保存と計算に分ける
GitHubはいま、AIエージェントが生む大量の書き込みに耐えられるよう、Gitの保存基盤を「保存」と「計算」に分ける形へ、サービスを止めずに作り替えています。
GitHubブログでこの作り替えを解説する連載が始まっています。10月6日の1回目は「なぜ作り替えるのか」の総論、10月21日の2回目は「最終形への橋渡し」にあたる具体策です。2本を読んでとても勉強になったので、前提知識から順に整理してみます。
この記事でわかること
- AIエージェントの普及で、GitHubへの書き込みがどれだけ増えているか
- 今のGitHubの仕組みが、なぜエージェントの書き込みに耐えにくいのか
- GitHubが進めている作り替えの2つの原則と、移行の現在地
AIエージェントでGitHubへの書き込みが1年で約5倍に
GitHub上の書き込みは、1年で4~5倍のペースで増えています。連載1回目に出てくる数字を並べると、次のとおりです。
| 指標 | 数字 | 前年比 |
|---|---|---|
| push数 | 月6.9億件 → 33.5億件 | 約4.9倍 |
| コミット数(2026年9月) | 73.8億件 | 5倍超 |
| GitHub Actionsの実行(2026年9月) | 32.6億回 | 4倍超 |
| PRのマージ数 | ― | 約4倍 |
| Git全体の操作数 | 月2,182億件 → 4,733億件 | 2倍超 |
増加分の主役は、忙しいCIを回す大きな開発チームと、そこで数を増やしているAIエージェントです。最も忙しいリポジトリは、8月だけで約10億リクエストを受けたそうです。
エージェントが生む5つの課題
エージェントは人間と動き方が違います。記事が挙げる課題を、私なりにまとめると次の5つです。
- 1回のpushの速さが、そのままエージェントの速さになる
人がコミットするのは作業の区切りごとなので、pushに少し時間がかかっても気になりません。エージェントは小さな操作のたびにコミットし、pushが終わるのを待ってから次の操作に進みます。この待ち時間が何百回も繰り返されるので、pushが速くならない限り、エージェントの作業も速くなりません。 - 書き込みが1点に集中する
数千のエージェントが1つのリポジトリで各自のブランチに書きます。 - マージは1本のブランチに集まる
マージキューなどで、全員の成果がmainに流れ込みます。 - 1回のpushが数千回の読み取りを生む
CIやコードスキャンが、同じブランチの最新版を毎分数千回取りに来ます。 - 後片付けの作業も増える
データの圧縮や不要データの削除が、書き込みに比例して膨らみます。
読み取りはキャッシュやサーバーを足せば増やせます。難しいのは書き込みです。確実に保存し、次のエージェントやCIが矛盾のない状態を見られてはじめて、完了と言えるからです。
前提知識:Gitのコミット・ブランチとGitHubの5台のサーバー
GitHubの仕組みに入る前に、Gitがデータをどう持っているのかと、GitHubがそれをどこに置いているのかを確認しておきます。
- コミットやファイルの中身
Gitは中身からハッシュ(名前)を決めて保存します。一度作ったコミットは後から書き換わらず、変更は常に新しいコミットとして追加されます。 - ブランチ
mainやfeature-xといったブランチは、「どのコミットを指しているか」という情報です。pushで書き換わるのは、主にこの指し先です。 - 5台のサーバーと多数決
GitHubは同じリポジトリを、標準で5台のサーバーに置いています。pushは、過半数のサーバーが受け付ければ確定する多数決の仕組みで守られています。
なぜブランチの更新だけが難しいのか
2人が同時にmainへpushした場面を考えます。あるサーバーにはAさんのpushが先に届き、別のサーバーにはBさんのpushが先に届くかもしれません。何もしなければ、サーバーごとに「mainが指すコミット」が食い違ってしまいます。
そこでサーバーどうしで「どちらのpushを先に反映するか」を決め、5台のmainを同じコミットにそろえる必要があります。これが多数決で行っている「合意」です。
コミットやファイルの中身には、この心配がありません。中身からハッシュが決まり、一度作ったコミットは書き換わらないので、どのサーバーにどの順番で届いても最終的な中身は同じになります。各サーバーは届いた順に保存するだけで済みます。
pushは次の2つの作業でできています。
| 作業 | サーバーどうしの合意 |
|---|---|
| コミットやファイルの中身を保存する | 不要(量は多い) |
| 「mainの最新はこのコミット」という情報を書き換える | 必要(量は少ない) |
合意が必要なのは、量の少ない後者だけです。この後に出てくる工夫は、どれもこの性質を利用しています。
GitHub Spokesの限界:1つのコピーが保存と応答の二役を兼ねている
今のGitHubでは、「Spokes」という仕組みがリポジトリの完全なコピーを、5台のファイルサーバーの手元ディスクに置いています。このコピーが「壊れないための保存」と「大量のアクセスをさばく応答」の両方を担っているのが、限界の根っこです。
読み取りが増えたら、同じリポジトリを置くサーバーを増やせば分散できます。ただし、pushのたびに全サーバーのリポジトリを更新して合意を取る必要があるので、サーバーを増やすほどpushが遅くなります。読み取りのための増設が、書き込みの足を引っ張る構造です。
さらに、サーバーを1台失うと読み取り能力が下がり、過半数のサーバーがそろわなくなるとpushは止まります。データの圧縮や不要データの削除も、同じサーバーの上で動いています。ほとんどのリポジトリにはこれで十分ですが、エージェントが集まるリポジトリでは天井になります。
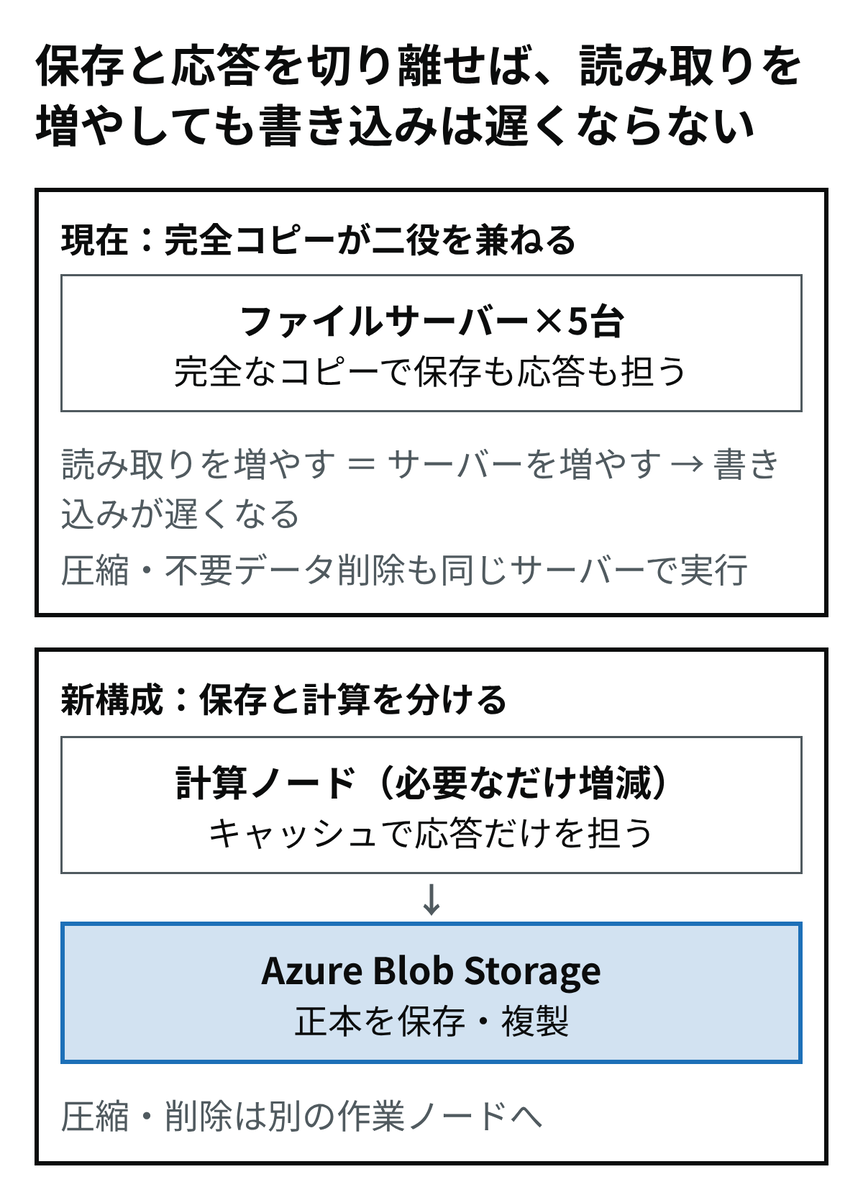
左が今、右がこれからの形です。
- 今:pushのたびに、リポジトリを持つ5台すべてが更新に参加し、合意が取れるまで完了しません。そのため、読み取り用にサーバーを足すと、pushの待ち相手も増えてしまいます。
- これから:正本はBlob Storageに1つだけ置き、pushはBlobに保存できた時点で完了します。読み取りに答える計算ノードは正本を持たず、pushの合意にも参加しません。必要になったデータを後からBlobから取ってくるだけです。
だから計算ノードを何台増やしても、pushの待ち相手は増えず、pushは重くなりません。
GitHubのアーキテクチャ刷新の2つの原則
新しい構成は、社内ベンチマークで書き込み処理量が最大35倍になったそうです。その土台にあるのは次の2つの原則です。
原則1:合意は必要なところだけにする
pushの中で本当に合意が要るのは、「mainの最新はこのコミット」という1行の情報を書き換える作業だけです。Gitのブランチの実体は、コミットのハッシュを1つ書いただけの小さな情報なので、この作業自体は一瞬で終わります。
次のような重い作業は、他のpushと並行して進められます。
- コミットやファイルの中身の保存
- コミットが必要とするファイルや親コミットが欠けずにそろっているかの確認
- シークレットの検査
完了を待たせるのは、この小さな書き換えの合意だけに絞ります。
圧縮や不要データの削除といった保守作業も、応答を返すサーバーから切り離して専用の作業ノードに移します。忙しいリポジトリでも、pushやfetchを遅くせずに裏で整理し続けられます。
原則2:保存と計算を切り離す
リポジトリの正本はAzure Blob Storageに置き、読み取りへの応答はキャッシュを持った軽い計算ノードが担います。これにより次の3つが可能になります。
- 正本のコピーを増やさずに読み取りを増やせる
CIやエージェントの急なアクセスを、書き込みを重くせずに受け止められます。 - 障害からの復旧が速い
計算ノードを失っても、代わりがすぐ応答を始め、必要なデータを順に取り込むだけです。完全なコピーを作り直す必要がありません。 - 需要に合わせて増減できる
リリースや新しいエージェントの稼働など、一時的な山にだけ能力を足し、終われば戻せます。
ブランチ保護、必須レビュー、監査ログといった統制機能はそのまま守ることも、はっきり約束されています。
GitHubのAzure移行の現在地:99.99999%がAzureにもある
全リポジトリの99.99999%は、すでに自社データセンターとAzureの両方に置かれています。多くのリポジトリで、5台のサーバーのうち2台がAzure上にあり、Git通信の約半分をAzureが処理しています。最初のリポジトリがAzureの米国中部リージョンに置かれたのは2025年8月です。
順番にも考えがあります。自社データセンターは電力と機器調達に上限があり、急増する通信に追いつきません。ただし、設計の変更と引っ越しを同時にやるのは危険すぎます。そこで「まずデータを移し、その後で設計を変える」という順序を取ったそうです。
残り0.00001%を阻む「25ミリ秒」
移れていないのは、特に忙しいリポジトリです。Azureの対象リージョンは自社データセンターから約1,600km離れており、通信1往復に約25ミリ秒かかります。書き込み1回には複数回の往復が必要です。
しかも今の多数決は、過半数で確定できるのに正常なサーバー全部の返事を待ち、その間リポジトリ全体に鍵をかけます。一番遠いサーバーの返事を毎回待つことになり、pushの行列が伸び続けます。
解決策:鍵をブランチごとにする
Gitが守るべき一貫性は、ブランチごとに成り立てば十分です。別々のブランチへのpushは互いに影響しません。そこで鍵の単位を「リポジトリ全体」から「ブランチごと」に細かくします。同じブランチを奪い合うpushだけが待ち、それ以外は並行して流れます。
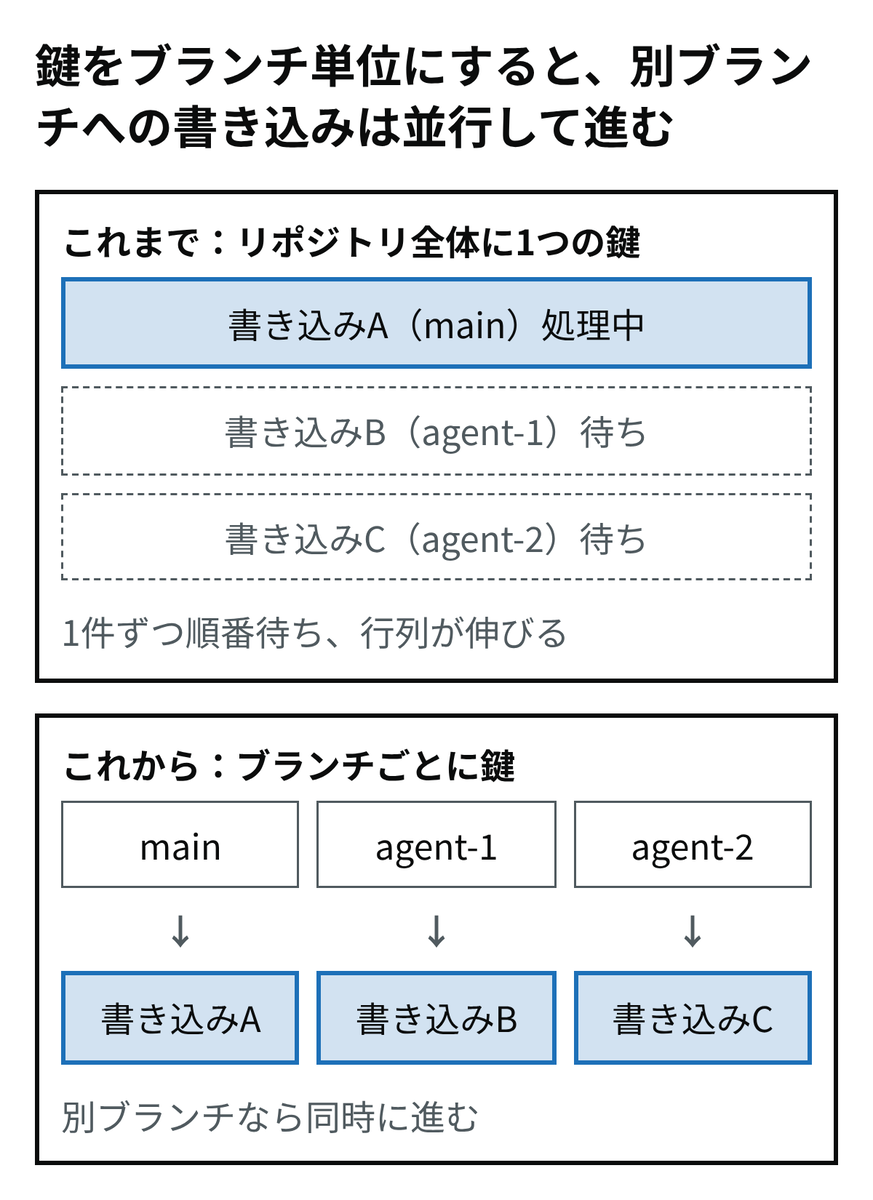
社内テストでは、別々のブランチへのpushの場合、同じ時間にさばけるpushの数が3~4倍に増え、しかもpush 1回が完了するまでの待ち時間も短くなったそうです。エージェントはそれぞれ自分のブランチにpushすることが多いので、この変更だけで行列のほとんどが解消します。
もう1つの一手:仮想レプリカ
多くのリポジトリでは、push 1回に対して読み取りが100~1,000回あります。そこでBlob Storageを、多数決に参加するサーバーの1台として扱います。GitHubはこれを「仮想レプリカ」と呼んでいます。自分のディスクにリポジトリを持たず、Blobとの間をつなぐだけのサーバーです。仮想レプリカには、書き込み用と読み取り用の2種類があります。
書き込み用の仮想レプリカ
多数決に参加するサーバーの1台として働きます。pushを受け取るとBlobに保存し、保存し終わるまでは「受け付けた」と返事をしません。そのため、pushが完了した時点で、正本が必ずBlobに残っています。
サーバー自身はデータを持ち続けないので、壊れても新しく立ち上げ直せば済みます。また、同じ時期に届いた別々のブランチへのpushをまとめてBlobに送るので、pushが増えてもBlobとのやり取りは増えすぎません。
読み取り用の仮想レプリカ
cloneやfetchに答える専用のサーバーです。起動するとBlobから必要なデータを手元に読み込み、それを使って応答します。
多数決には参加しないので、何台増やしてもpushの待ち相手は増えません。読み取りが集中するときは、必要なだけ台数を増やせます。負荷試験では、今の構成は上限に達したのに、読み取り用の仮想レプリカのほうは先に試験装置のほうが限界に達したそうです。
まとめ:変わらないデータは合意しなくていい
変わらないものは、合意しなくていい。
一番の学びは、この考え方です。中身でハッシュが決まるコミットやファイルはそのまま保存先に置き、順番が必要な小さな部分だけを合意する。読み取りや後片付けは使い捨てのノードに逃がす。Gitに限らず、複数拠点でデータを持つシステム全般に使える設計の型だと感じました。
もう1つは進め方です。設計の変更と引っ越しを同時にやらず、「まずデータを移す」と順番を切り分けています。しかも一歩ごとに余裕が増えるように組み立てています。10億リポジトリを止めずに作り替えるという難題に、大きな一発ではなく小さな段階を積み重ねて挑んでいるのが印象的でした。
連載の最終回は、10月28~29日のGitHub Universeに合わせて公開される予定です。
- 書き込みの上限をどう突破するのか
- そのためにどんな副次的な問題を解いたのか
- なぜ、それでも小さな合意の仕組みがどこかに残るのか
答え合わせが今からとても楽しみです。公開されたら、またこのブログでまとめます。
関連記事
エージェント時代の開発ツールは、Rexの記事でも扱っています。
AIコーディング基盤の費用と運用は、Revolutの事例で整理しています。
オープンモデル自社運用でAIコーディング費用を1/10に:Revolutの事例と他社比較