小さく当てて大きく渡す:親ドキュメント検索・GraphRAG・RAPTOR
RAG の回答品質は「何で検索するか」と「何を LLM に渡すか」を別の粒度で設計すると上がる。親ドキュメント検索は小さなチャンクで当てて親セクションを渡し、GraphRAG はエンティティのグラフと事前要約でコーパス全体の問いに答え、RAPTOR は要約ツリーの全階層から必要な粒度を拾う。
本記事は、YouTube チャンネル Under the Hood AI の動画 GraphRAG & Parent-Document Retrieval Explained の内容を、各手法の原論文・公式実装の情報で補って整理したものである。
RAG で文脈が欠ける理由
標準的な RAG は、文書を固定長のチャンクに分割し、各チャンクの埋め込みベクトルとクエリの類似度で上位 k 件を取り出して LLM に渡す。このとき、チャンクサイズは検索精度と文脈量のトレードオフになる。
| チャンクサイズ | 検索(埋め込み)への影響 | 生成(LLM)への影響 |
|---|---|---|
| 小さい(数十〜数百トークン) | 1 チャンク 1 論点になり、埋め込みがクエリと鋭く一致する | 前後の文脈が欠け、指示語や主語が解決できない |
| 大きい(数千トークン) | 複数論点が 1 ベクトルに平均化され、一致が鈍る | 文脈は揃うが、無関係な記述も混ざる |
動画の例は障害報告書である。「ロールバックを実施した」という 1 文は検索で正確にヒットするが、その文だけでは何をロールバックしたのかが分からない。対象(例:キャッシュ設定)は数段落前に書かれており、チャンク境界の外に落ちている。LLM は欠けた部分を推測で埋め、誤答する。
もう 1 つの失敗は、答えがどのチャンクにも書かれていない問いで起きる。「何が繰り返し故障しているか」は、数十件の報告書を横断して初めて答えられる。上位 k 件のチャンクをどれだけ正確に取っても、この種の問いには届かない。GraphRAG の論文は、これを検索ではなく「クエリ指向の要約(query-focused summarization)」の問題と位置づけている。
以降の 3 手法は、前者の失敗を親ドキュメント検索が、後者を GraphRAG が、両者の中間を RAPTOR が扱う。
親ドキュメント検索(Parent-Document Retrieval)
親ドキュメント検索は、検索に使う単位(子チャンク)と LLM に渡す単位(親チャンク)を分離する手法である。登録時に文書を 2 段階で分割し、子チャンクだけを埋め込んでベクトルストアに入れ、親チャンクは ID 付きで別のストアに保存する。検索時は子チャンクで類似度検索を行い、ヒットした子が持つ親 ID で親チャンクを引いて LLM に渡す。
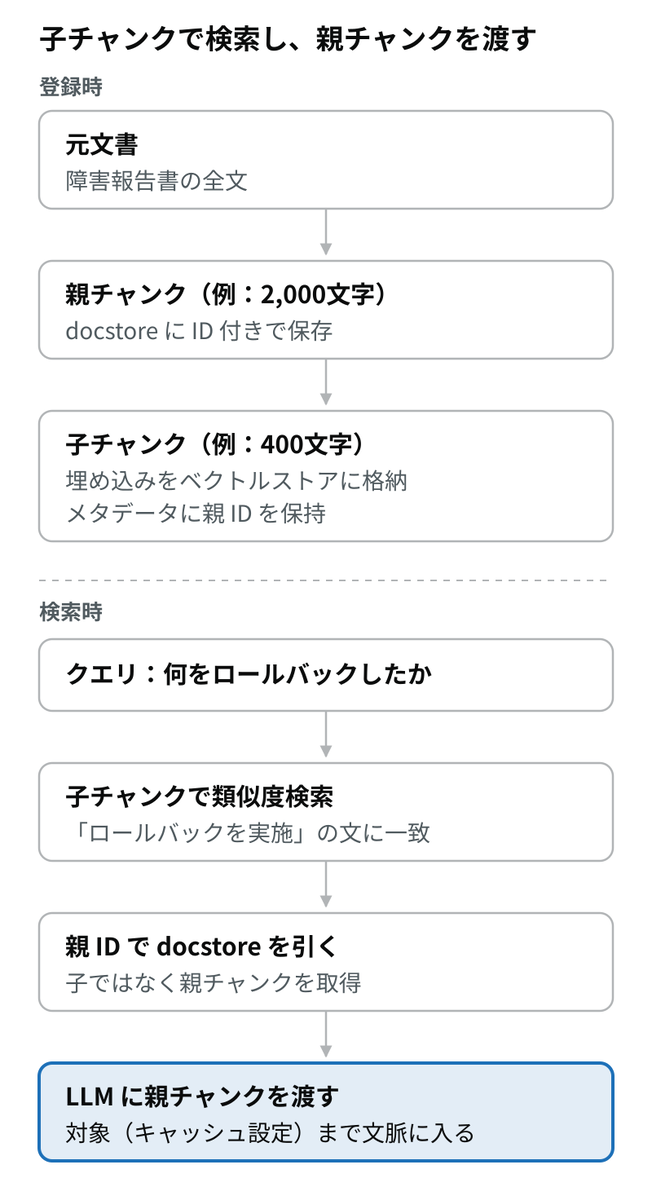
障害報告書の例では、「ロールバックを実施」という短い子チャンクが鋭く一致し、その親であるセクション全体(キャッシュ設定の変更から切り戻しまで)が LLM に届く。
実装
LangChain の ParentDocumentRetriever がこの構成をそのまま提供する。指定するのは次の 4 つである。
| パラメータ | 役割 |
|---|---|
vectorstore |
子チャンクの埋め込みを格納するベクトルストア |
docstore |
親チャンク(または元文書)を ID で保存する KV ストア |
child_splitter |
子チャンクを作る分割器(例:chunk_size=400) |
parent_splitter |
親チャンクを作る分割器(例:chunk_size=2000)。省略すると元文書全体が親になる |
parent_splitter を省略すると、ヒットした子の元文書が丸ごと返る。文書が短いコーパスでは有効だが、長い報告書では 1 件で数万トークンになり得るため、通常は親もセクション単位に分割する。InMemoryStore はプロセス終了で消えるため、本番では永続化された KV ストアを docstore に使う。
設計上の論点
- 親の切り方:文字数で切るより、見出し・セクション境界で切る方が「意味のまとまり」と一致する。Markdown や HTML の見出しで分割する分割器を親に使うのが定石である。
- 重複の除去:同じ親を持つ子が複数ヒットすると、同じ親が重複して返る。親 ID で重複を除いてから LLM に渡す。
- 子の上位 k 件と親のサイズの積:渡すトークン数はおおむね「重複除去後の親の件数 × 親のサイズ」になる。k を増やすと、プロンプトが急速に膨らむ。
GraphRAG
GraphRAG(Microsoft Research、2024 年)は、検索時にチャンクを探すのではなく、索引時に LLM でコーパス全体を読み、要約を作り置く手法である。論文は索引を 2 段階と定義する。第 1 に文書からエンティティのナレッジグラフを導き、第 2 に密接に関係するエンティティ群ごとの要約を事前生成する。
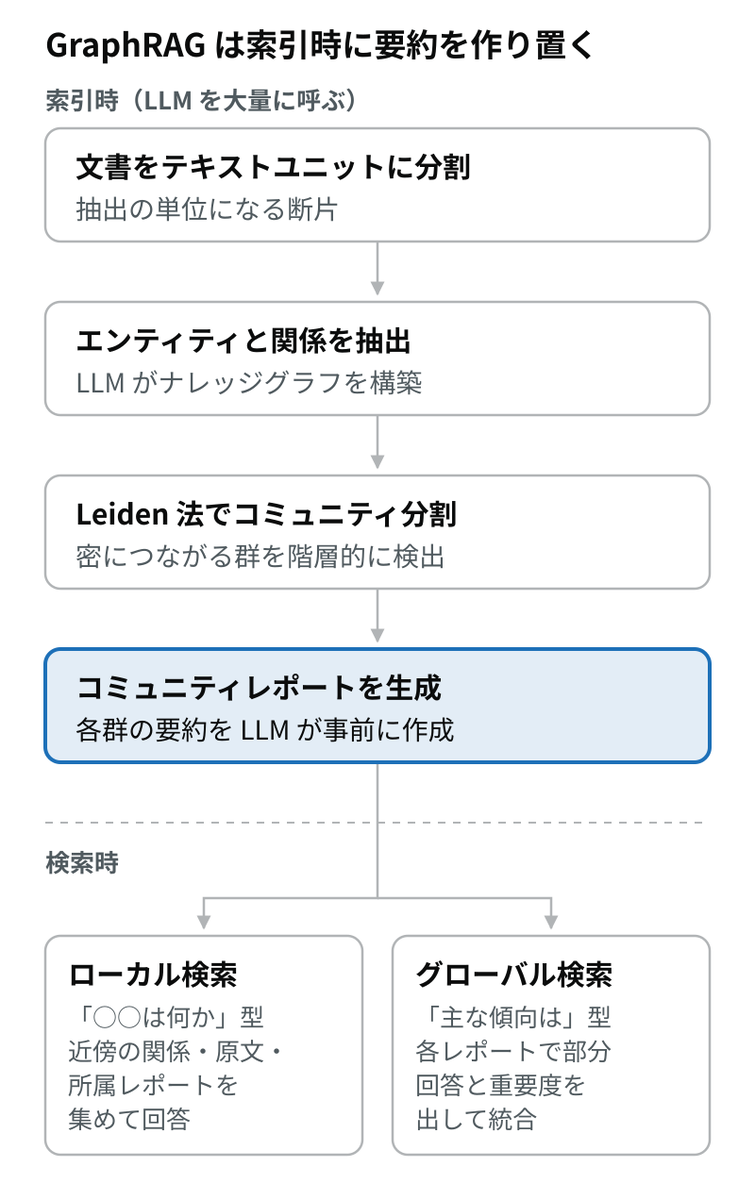
索引の流れ
- テキストユニットへの分割:文書を抽出単位の断片に分ける。
- エンティティ・関係の抽出:LLM が各断片から人・システム・組織などのエンティティと、その間の関係を取り出す。同名のエンティティは 1 ノードに集約され、複数文書の記述が 1 つのグラフにつながる。
- コミュニティ検出:Leiden 法でグラフを階層的に分割する。上位階層ほど少数の大きな群、下位階層ほど多数の小さな群になる。
- コミュニティレポート生成:各コミュニティについて、LLM が要約(レポート)を書く。動画が「全件を読んだ同僚が書いた要約」と表現しているのはこの部分である。
障害報告書のコーパスなら、「キャッシュ層」「設定変更」「ロールバック」などが複数の報告書をまたいで 1 つのコミュニティにまとまり、その群のレポートが、事前に「キャッシュ周りの障害傾向」を要約した状態になる。
検索のモード
| モード | 向く問い | 使う情報 |
|---|---|---|
| ローカル検索 | 特定エンティティについての問い | クエリに近いエンティティとその近傍の関係、元のテキストユニット、所属コミュニティのレポート |
| グローバル検索 | コーパス全体の傾向・主題 | 指定階層のコミュニティレポート全件(Map-Reduce) |
| DRIFT 検索 | ローカルかグローバルか事前に分からない問い | レポートで全体像を掴んだ後、追加質問を生成してローカル検索で深掘りする |
グローバル検索は Map-Reduce で動く。Map ではレポートを分割してそれぞれ LLM に渡し、クエリに関する要点と重要度スコアを出させる。Reduce ではスコアの高い要点を集めて最終回答を生成する。動画の「要約のネットワークからスコアの高いものを組み合わせる」という説明はこの処理を指す。参照する階層を上げるとレポート数が減って安く粗くなり、下げると細かく高くなる。
論文の評価
論文は、ポッドキャストの書き起こしとニュース記事(それぞれ約 100 万トークン規模)で、コーパス全体を問う質問に対する回答を比較している。GraphRAG はベクトル検索のみの RAG に対し、回答の網羅性と多様性で大きく上回った。評価は LLM を判定役にした一対比較であり、この方式自体のバイアスを指摘する後続研究もある。「誰がいつ何をしたか」のような局所的な問いは、従来のベクトル検索が得意とする領域である。
RAPTOR:要約ツリーによる中間解
RAPTOR(Recursive Abstractive Processing for Tree-Organized Retrieval、Sarthi ら、2024 年)は、チャンクを意味でクラスタリングして要約する処理を再帰的に繰り返し、葉が原文チャンク、上位が要約となるツリーを作る。検索時はこのツリーの全階層を対象にするため、詳細な問いには葉が、広い問いには上位の要約が当たる。親ドキュメント検索と GraphRAG の中間に位置づく。
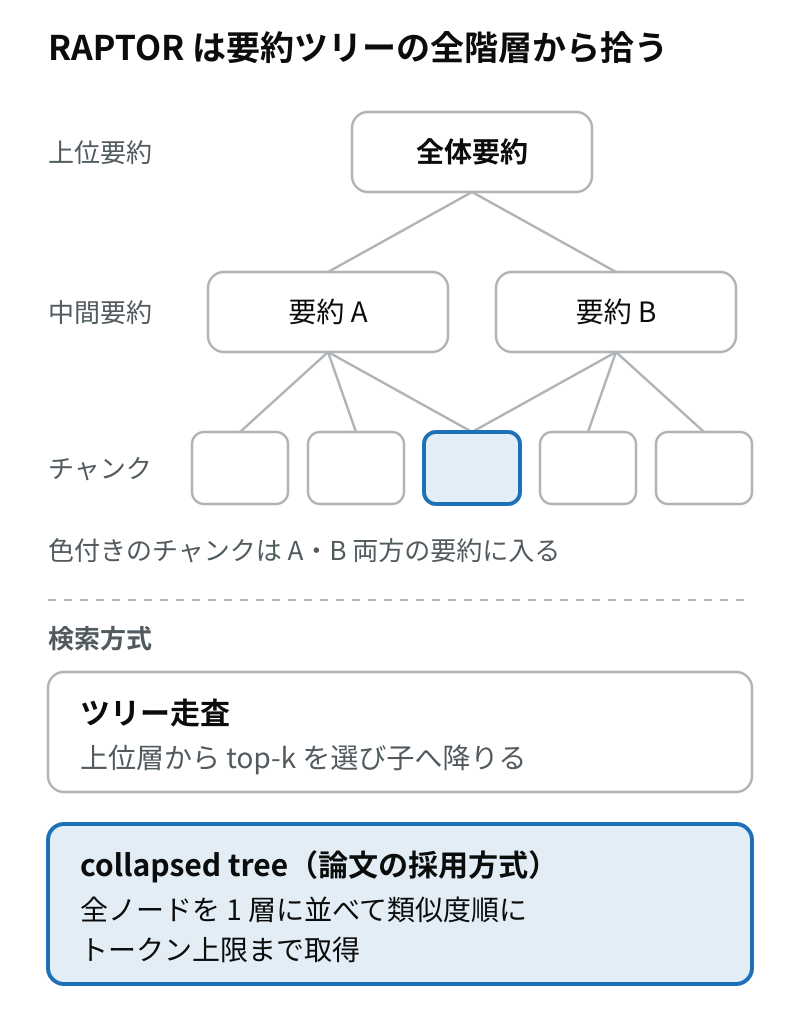
ツリーの構築
- 文書を約 100 トークンのチャンクに分割し、SBERT で埋め込む。これが葉ノードになる。
- 埋め込みを UMAP で次元削減し、ガウス混合モデル(GMM)でクラスタリングする。クラスタ数は BIC(ベイズ情報量規準)で決める。GMM はソフトクラスタリングなので、1 つのチャンクが複数のクラスタに属し得る。
- クラスタごとに LLM(論文では gpt-3.5-turbo)で要約し、要約を親ノードとして再び埋め込む。
- 親ノードの集合に 2・3 を繰り返し、クラスタが作れなくなった時点で根に辿り着く。
2 つの検索方式
ツリー走査は、根の層から類似度上位 k 件を選び、その子の中からまた上位 k 件を選んで葉まで降りる。各層から取る件数が固定になる。collapsed tree は、ツリーを 1 層に平坦化して全ノードとクエリの類似度を計算し、上位からトークン上限に達するまで取る。
論文は QASPER の 20 篇で両者を比較し、collapsed tree が一貫して上回ったため、上限 2,000 トークンの collapsed tree を本実験の方式に採用している。問いに合う粒度のノードを階層を問わず拾えることが理由とされる。代償は、ツリーの全ノードに対して類似度計算が必要になる点である。評価は NarrativeQA・QASPER・QuALITY で行われ、長文全体の理解を要する問いで BM25 や DPR による従来の検索を上回った。
3 手法の比較と使い分け
使い分けの基準は「答えが 1 か所に書かれているか、コーパス全体に散らばっているか」である。
| 観点 | 親ドキュメント検索 | RAPTOR | GraphRAG |
|---|---|---|---|
| 解く失敗 | ヒットした断片の前後文脈の欠落 | 問いの粒度と索引の粒度の不一致 | どのチャンクにも書かれていない全体の問い |
| 索引の構造 | 子チャンク+親チャンクの 2 層 | 要約の木(再帰的クラスタリング) | エンティティのグラフ+コミュニティ階層 |
| 索引時の LLM 呼び出し | 不要(分割と埋め込みのみ) | クラスタごとの要約 | 全テキストユニットの抽出+全コミュニティの要約 |
| 検索時に渡すもの | 親チャンク(原文) | 階層をまたぐ原文と要約 | エンティティ・関係・原文・レポート(ローカル)、レポートの部分回答(グローバル) |
| 向く問い | 「障害 X で何をロールバックしたか」 | 長文 1 冊の筋や論点を問う | 「何が繰り返し故障しているか」 |
| 文書更新への追従 | 再分割・再埋め込みのみ | 該当部分の木の再構築 | 抽出・コミュニティ・レポートの再生成 |
実務では段階的に導入する。まず親ドキュメント検索で局所的な問いの精度を固め、横断的な問いへの要求が実際にある場合に限り、RAPTOR または GraphRAG を追加する。GraphRAG もローカル検索だけで足りるなら、エンティティを手掛かりにしたハイブリッド検索で代替できる場合が多い。
導入時の注意点
3 手法はいずれも「文脈を増やす」ための仕組みであり、その代償はトークン量・索引コスト・要約の正確さの 3 点に現れる。
| 注意点 | 起きること | 対策 |
|---|---|---|
| 親チャンクの肥大化 | ヒット数が増えるとセクション単位の原文がそのままプロンプトに積まれ、トークン消費と無関係な記述が増える | 親 ID で重複を除く。親の上限サイズと件数を決め、超過時はリランカーで絞る |
| GraphRAG の索引コスト | 全テキストユニットの抽出と全コミュニティの要約に LLM を呼ぶ。Microsoft Research は、LazyGraphRAG の索引コストがベクトル RAG と同等で、完全な GraphRAG の 0.1% だと公表している | 小さなコーパスでコストを実測してから全量に広げる。索引時の要約を省いて検索時に遅延処理する LazyGraphRAG も選択肢になる |
| グローバル検索の遅延 | Map-Reduce で多数のレポートに LLM を呼ぶため、ローカル検索より応答が遅い | 参照するコミュニティ階層を上げてレポート数を減らす |
| 要約での欠落・誤り | GraphRAG のレポートや RAPTOR の上位ノードは LLM の要約であり、数値・固有名詞などの細部が落ちたり、誤りが混入したりする | 要約から元のテキストユニット・チャンクへの参照を保持し、回答の根拠として原文を併記する |
| 更新への追従 | 文書が追加・変更されると、GraphRAG はグラフとレポート、RAPTOR は木の該当部分を作り直す必要がある | 更新頻度の高い文書群は親ドキュメント検索で扱い、グラフ・ツリーは変更の少ない文書群に限る |
動画が RAPTOR について指摘する「プロンプトが大きくなり、索引構築にコストがかかる」という代償も、この表の 1 行目と 2 行目の組み合わせである。どの手法も、原文を何トークンまで渡すかという予算設計を先に決めてから導入する。
参考資料
- GraphRAG & Parent-Document Retrieval Explained(Under the Hood AI、YouTube)
- From Local to Global: A Graph RAG Approach to Query-Focused Summarization(Edge ほか、arXiv:2404.16130)
- RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval(Sarthi ほか、arXiv:2401.18059)
- LazyGraphRAG: Setting a new standard for quality and cost(Microsoft Research Blog)
- ParentDocumentRetriever のソースコード(LangChain API Reference)
- How to use the Parent Document Retriever(LangChain Docs)