企業が自社モデルを訓練する時代の実装ロードマップ:Will Brown講演の解説
結論
Will Brown氏(Prime Intellect 応用研究リード)の主張は、組織固有の知識を毎回コンテキストで読み込ませる方式から、その一部をモデルの重みに定着させる方式へ移るべきだ、というものである。着手点はモデル訓練ではなく、Evalの整備である。根拠は3つある。
- エージェントは学び直しを繰り返す。 スキルファイルとコードベースの探索に頼るため、同じ入力を毎回処理し、キャッシュが効いても入力トークンのコストが残る。
- フロンティアモデルの学習経路は長い。 業務を知る本人が、自分の知識を学習させる訓練を監督できない。
- 訓練費用が採用1名と比較できる水準に入った。 講演では約30万ドルで訓練した知識業務モデルが紹介された。
対象は2026年11月2日に公開されたAI Engineerの講演(約20分)である。Prime Intellectはこの訓練基盤を販売する企業であり、講演は事業の立場からの主張である。また、提案はフロンティアモデルの置き換えではなく併用である。
コンテキストと重みの境界
書き下せるルールはコンテキストに置き、書き下せないパターンを重みに置く。Brown氏はこの軸を「ルールからパターン」「コードからデータ」と表現する。手順や規則はコードに近く、選好・摩擦・経験則・傾向はデータに近い。
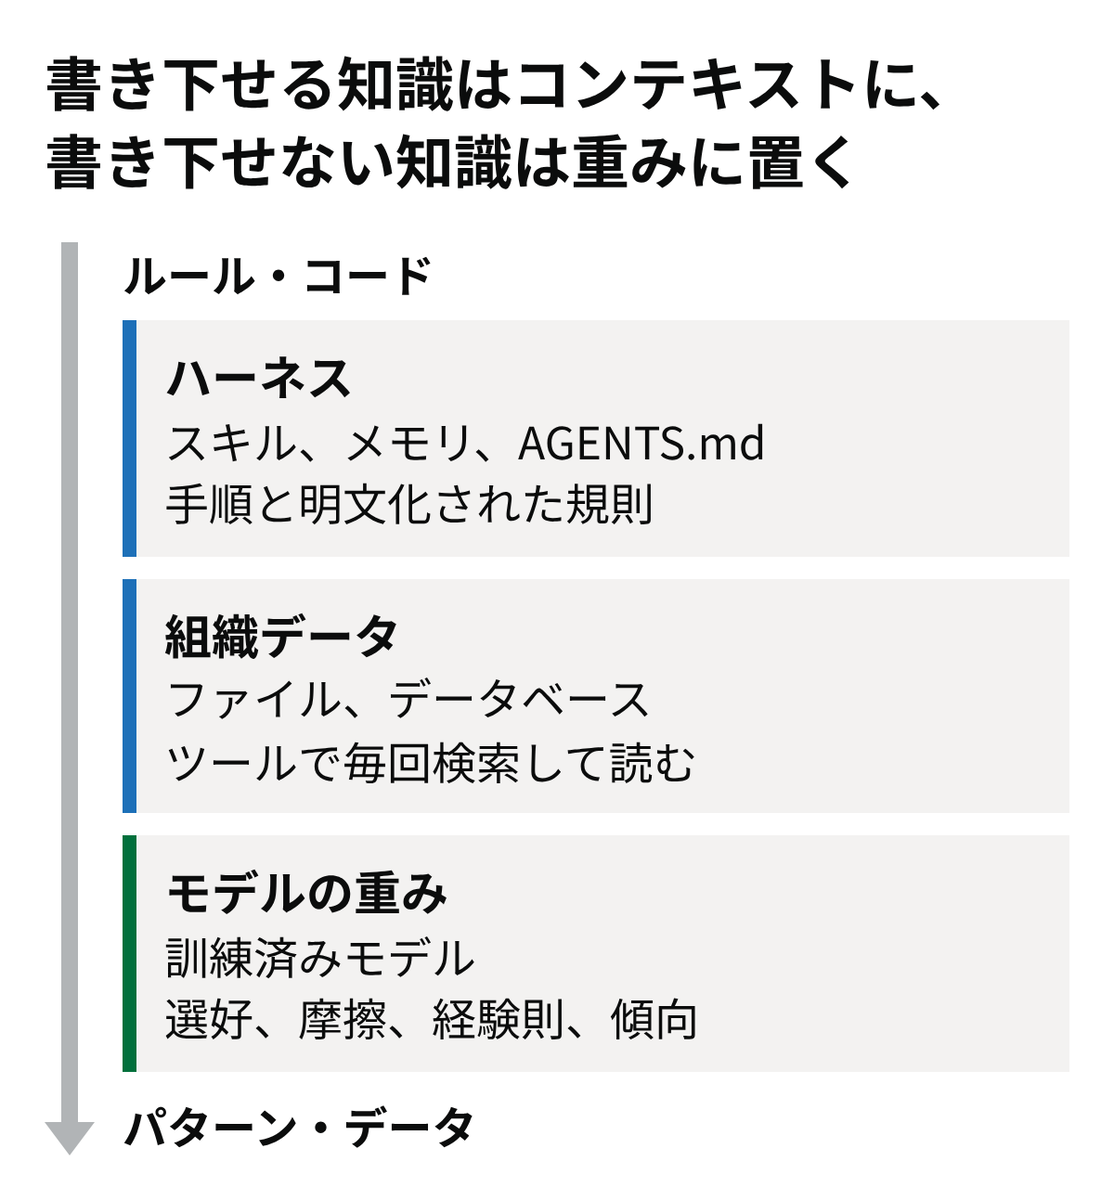
組織の知識は4つの層に分かれる。
| 層 | 置き場 | 向いている知識 | 限界 |
|---|---|---|---|
| 人 | 社員の頭の中 | 実際の意思決定者、変更が浸透する経路、摩擦点 | モデルから参照できない |
| ハーネス | スキル、メモリ、AGENTS.md | 明文化できる規則 | 追記が積み重なり、定期的な整理が要る |
| 組織データ | ファイル、データベース | 文書、コード、メール、議事録 | ツールで毎回検索し、読み直す |
| モデルの重み | 訓練済みモデル | 文脈つきの選好、経験則、組織の直感的な理解 | 訓練と評価の仕組みが要る |
すべてを重みに入れる提案ではない。講演の表現では、重みに入る知識は「earn it(資格を得る)」必要がある。繰り返し現れ、規則に書き下しにくく、評価できる知識だけが候補になる。
知識カットオフ後の話題をモデルと議論するときの扱いにくさは、この差を示している。モデルは直近の出来事をコンテキスト上で組み立て直すため、訓練済みの古い話題ほど流暢に扱えない。組織固有の知識も、現状は同じ状態にある。
訓練データとして使えるフィードバック
コーディングエージェントに伝える「この場面ではこの対応を望む」という修正は、訓練データに近い形をしている。現状ではAGENTS.mdの1行として蓄積される情報を、持続的な学習へ変換できる。
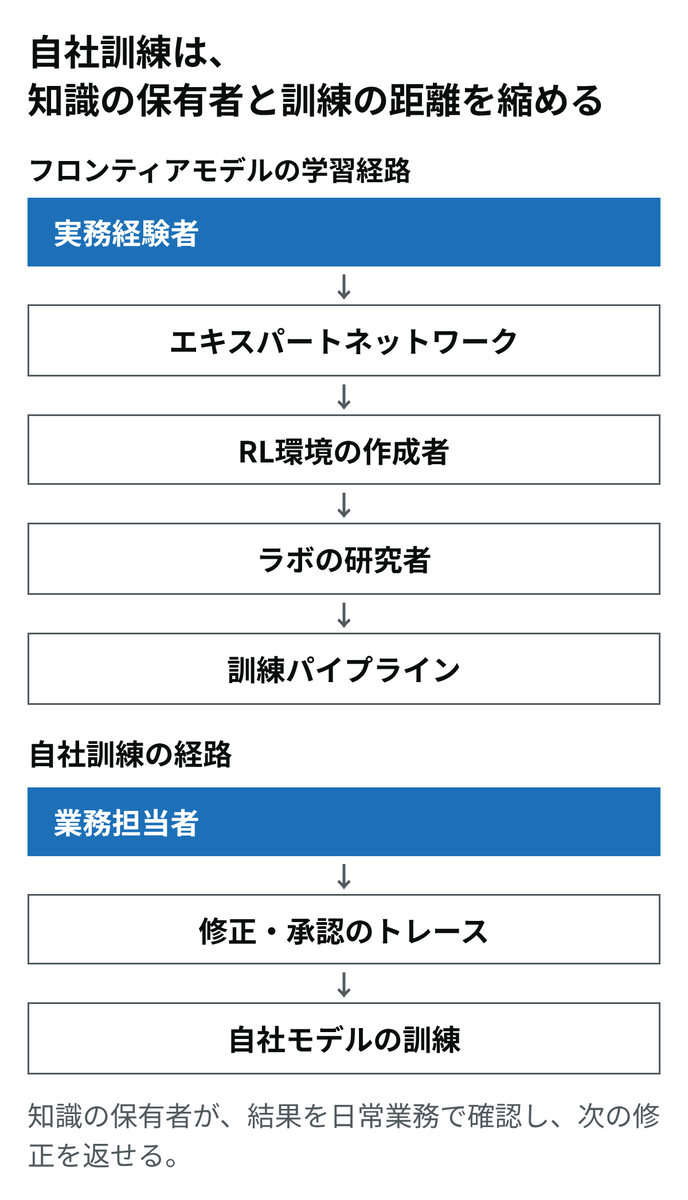
一方、フロンティアモデルの学習経路では、知識は次の順に受け渡される。
- 実務経験者がエキスパートネットワークに登録し、知識を提供する
- ネットワーク企業の担当者がデータを受け取る
- 別の担当者が強化学習(RL)環境に加工する
- 環境が、その領域の専門家ではないラボの研究者へ販売される
- 研究者が調整し、次のモデルの訓練パイプラインへ投入する
各段階は分断され、知識の保有者は訓練を監督できない。自社訓練の狙いは、この距離を縮めることにある。
実装ロードマップ
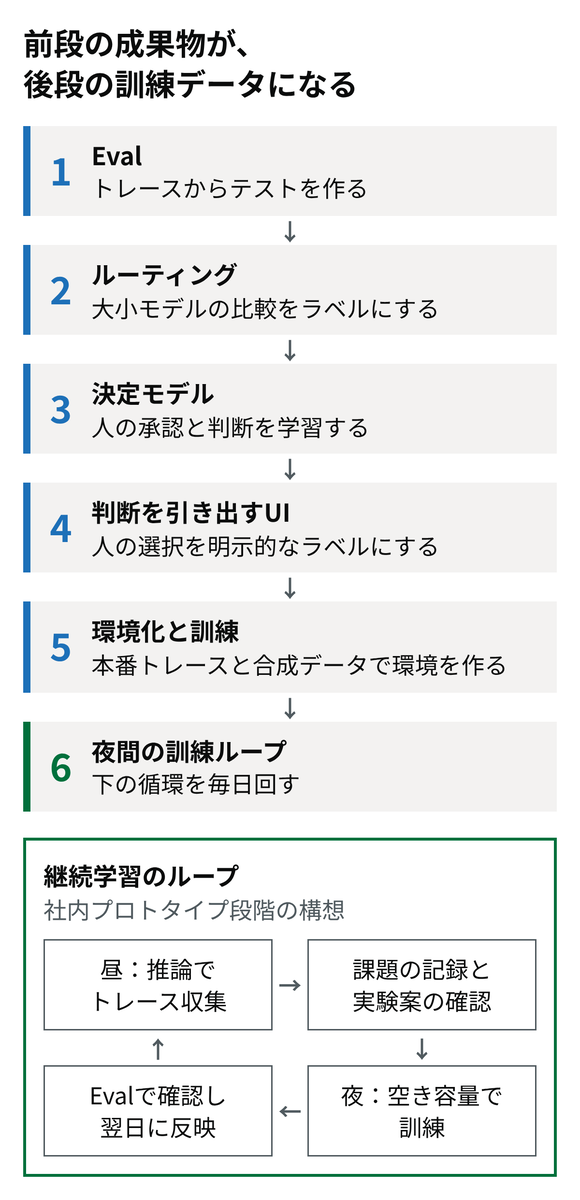
モデルをコードベースと同じように扱い、テストと機能を積み上げる。講演の流れは次の6段階に整理できる。前段の成果物が後段の訓練データになるため、順序に意味がある。
- Evalをテストケースとして整備する。 トレース(プロンプト、ツール呼び出し、人のフィードバックを含む実行記録)から作る。キュレーションの多くをエージェントが担える段階に近づいている。
- ルーティングを導入する。 大小のモデルに同じタスクを実行させ、小型モデルの結果が十分かを判定する。判定結果が、そのまま次回の振り分けに使うラベルになる。
- 決定モデルを導入する。 人の承認や判断を模倣させる。正解を付けやすいため、継続学習の入口になる。
- 判断を引き出すUIを作る。 エージェントが必要な時だけウィジェット型の確認画面を生成する。人の選択が明示的なラベルになり、報酬ハッキングの問題も起きにくい。
- 本番トレースを環境に変換して訓練する。 実データと合成データを混ぜ、実タスクの複雑さを再現する環境を作る。
- 夜間の訓練ループを回す。 課題として記録された項目と実験案を確認し、夜間に訓練を起動する。昼は推論に使う計算資源を、利用が減る夜は訓練に回す。Prime Intellectの社内プロトタイプ段階の構想である。
訓練対象はスタック全体でなくてよい。オーケストレーション層や決定モデルから始められる。
決定モデル
講演で触れられたJevは、TypeSafeが2026年9月に公開した判断専用モデルである。文章を生成せず、状態と質問を受け取り、型付きの回答と確率を返す。選択肢から選ぶchoice、順序付き基準で評価するscore、命題の確率を返すnoulの3種類がある。
モデルが確率を推定し、閾値・権限・エスカレーションはコードで管理する。ツール呼び出しの自動承認では扱えない組織固有の規則や選好も、この層に蓄積できる。
RL環境の構成
Prime Intellectのプラットフォーム文書は、環境を次の3要素で定義する。訓練部分はTrainer、Inference、Orchestratorの3コンポーネントで構成され、Inferenceは重みを更新しながらOpenAI互換APIで配信する。
| 要素 | 内容 | 自社業務での対応 |
|---|---|---|
| データセット | タスクと、必要に応じて正解 | 本番トレースと合成データ |
| ハーネス | ツール、サンドボックス、コンテキスト管理、複数ターンのやり取り | 本番のエージェント実行環境 |
| ルーブリック | 報酬関数と評価指標 | Evalと人のフィードバック |
費用と事例
公開事例では、狭い業務に絞った追加訓練(ポストトレーニング)でフロンティアモデルを上回る結果が報告されている。ただし数値の多くは当事者の発表であり、独立した再現は確認されていない。
| 項目 | Ramp Fast Ask | Paper Instruments Ultramarine 1 Flash |
|---|---|---|
| 対象 | スプレッドシートの情報検索 | 財務、法務、コンサルティング、業務運営の資料作成 |
| ベースモデル | Qwen3.5-35B-A3B(有効パラメータ約30億) | GLM-5.3 Flash |
| 報酬 | 決定的な関数(完全一致の正解を重視) | ルーブリック評価 |
| 結果 | ベース比+10ポイント、Claude Opus 4.6比+4ポイント超、Haiku 4.5相当の速度 | 6ベンチマーク中3つで1位、1タスク0.13ドル |
| 比較上の注意 | 比較は自社の保留データ | 自社の評価を含み、APEX-Agents 1.1は57.0でClaude Fable 5の63.6を下回る |
約30万ドルの訓練
Brown氏は、Paper Instrumentsが約30万ドルでスプレッドシートやスライドなどの知識業務向けモデルを訓練したと述べ、ソフトウェアエンジニア1名の採用と比較できる投資規模と位置づけた。講演はモデル名を挙げていないが、同社が2026年10月に公開したUltramarine 1 Flashと内容が一致する。同社はPrime Intellectのツールの利用企業でもある。
Layer3 Labsの解説も、同モデルの後訓練費を約30万ドル、チームを5人と伝えている。一方、explainxの確認では同社の製品ページに費用の記載はなく、金額を裏づける一次資料は確認できていない。
特化の代償も報告されている。コーディング評価ではTerminal-Bench 2.1が83.2、DeepSWE 1.1が61.5で、ベースモデルの84.3、63.4をそれぞれ下回る。いずれも開発元の報告値である。
Fast Askの設計
Rampの事例(Brown氏が共著者)は、環境設計の具体例である。出発点はトレース分析で、メインエージェントのツール呼び出しの17.8%が探索に使われ、その約75%の直後に別の読み取りが続いていた。
- タスク: 合成の業務ワークブックで14種類、各3通りの言い回し
- 難易度調整: 無関係なシート、不完全な集計シート、請求書IDの難読化
- ツール: 3種類(メタデータ取得、範囲読み取り、Python実行)、上限15ターン
- 訓練: 100ステップ、バッチサイズ256、1問あたり8ロールアウト、約26時間
報酬は正解を最優先し、効率と簡潔さを小さな加点にしている。誤答は加点では救済されない。
R(y_i) = 1.0 × correct(y_i) + 0.1 × efficiency(y_i) + 0.05 × concise(y_i)訓練後も読み取りセル数はほぼ変わらなかった。モデルは読む量を減らしたのではなく、読む場所の選び方を改善した。成果を左右したのはモデル規模ではなく環境設計である、というのがRampの総括である。
訓練対象の選び方
最初の対象は、頻度が高く、結果を採点でき、誤りを取り消せる業務にする。Rampは検索業務を選んだ理由を、範囲が狭い、反復が多い、遅延に敏感、客観的に採点できる、の4点で説明している。判断の性質ごとの手段は次のとおりである。
| 業務の性質 | 手段 | 注意点 |
|---|---|---|
| 規則として書き下せる | スキル、AGENTS.md、コード | 重みに入れる理由がない |
| 回答の選択肢が有限で、基準を説明できる | 決定モデル | 確率の校正を自社データで測定する |
| 反復が多く、正解を機械判定できる | 決定的な報酬によるRL | タスク分布を本番に近づける |
| 正解がなく、品質を基準で評価する | ルーブリック評価によるRL | モデルが評価者に迎合する危険がある |
| 範囲が広く、未知の課題を含む | フロンティアモデル | 訓練済み小型モデルへ判断を任せない |
型付きの出力は、解析不能な回答を防ぐだけで、判断の正しさは保証しない。導入時は、判断の精度、エスカレーション率、処理時間、完了タスクあたりの費用を工程全体で測定する。医療の承認やアカウント停止のような重大な判断は、最初の対象にしない。
着手に新しい訓練基盤は要らない。今日からできる作業は、エージェントのトレースを保存し、人の修正と承認を記録し、そこからEvalを作ることである。この3点は、訓練に進まない場合でも品質管理の資産になる。
関連記事
オープンモデルを自社運用した実例は、Revolutの事例で整理しています。
オープンモデル自社運用でAIコーディング費用を1/10に:Revolutの事例と他社比較
トレースと評価でエージェントを改善する考え方は、次の記事で解説しています。
使うほど賢くなるエージェントのつくり方――モデル・ハーネス・コンテキスト
エージェントの実行と手順を明示的に設計する方法は、次の記事で扱っています。
参考資料
- Your Company Should Train Its Own AI Models - Will Brown, Prime Intellect(AI Engineer、2026年11月2日)
- Building Fast & Accurate Agents with Prime-RL Post Training(Ramp Labs、転載)
- Platform Overview(Prime Intellect Docs)
- Ultramarine 1 Flash: A Small Team Claims Fable-Class Work at 60x Lower Cost(explainx、2026年10月14日)
- Ultramarine 1 Flash Explained(Layer3 Labs、2026年10月16日更新)
- Jev and the New Decision Layer for AI Agents(Unite.AI、2026年10月5日)