使うほど賢くなるエージェントのつくり方――モデル・ハーネス・コンテキスト
概要
AIエージェントを継続的に改善するには、エージェントをモデル・ハーネス・コンテキストの3層に分解し、トレース(実行記録)と評価(Evals)を基盤として、変更コストの低い層から改善ループを回します。
LangChainのカンファレンス「Interrupt London」の講演「How to Build Agents That Improve Over Time: Model, Harness, Context」を見て、内容をまとめました。
なぜ「改善し続ける仕組み」が必要なのか
従来のソフトウェアは、仕様どおりに作れば同じ入力に同じ出力を返します。バグは「動かない」「エラーが出る」という形で見えます。
AIエージェントは違います。エラーは出ないのに、答えがズレている、手順が遠回り、言ってはいけないことを言うといった「意味の失敗」が起きます。しかも利用者・業務・データは日々変わるので、リリース時点で完成ということがありません。
そこで講演の主題は「一度うまく作る」ではなく、「使われながら良くなっていく仕組みをどう作るか」です。
1. エージェントを3つの層に分ける
改善するには、まず「どこを直すのか」を分けて考える必要があります。講演ではエージェントを次の3つに分解していました。
| 層 | 中身 |
|---|---|
| モデル(Model) | 推論・判断を担う中核エンジン。ガードレール用や評価用の周辺モデルも含む |
| ハーネス(Harness) | モデルを包む制御の仕組み。何を見せるか、行動の実行、結果の確認、記憶の管理、人間への確認 |
| コンテキスト(Context) | モデルに渡すテキスト、ファイル、知識、ツール |
ハーネスの役割
LLM単体は「文章を受け取って文章を返す」だけです。それを「調べる→考える→ツールを使う→結果を確かめる→やり直す」というループで動かし、実際の仕事につなげるのがハーネスです。LangChainは自社のブログで、エージェントを「モデル+ハーネス」と定義し、ハーネスの仕事は「各ステップでモデルに適切なコンテキストを届けること」だと説明しています。LangChainの「Deep Agents」はこのハーネスを部品として提供するもので、計画づくり(ToDo分解)、ファイルを使った文脈の退避・要約、記憶、人間による承認などを最初から備えています。
2. 3つの層それぞれの改善方法
講演では、改善の進め方を「手作業」→「人間が確認しながらの半自動(Human-in-the-loop)」→ 目指す姿(North Star)としての「完全自動」という段階で語っていました。そのうえで、層ごとの改善方法は次のとおりです。
モデルの改善:重みを更新する
モデルそのものを再学習(ファインチューニング)して、性能を上げる方法です。2種類あります。
- SFT(教師ありファインチューニング):うまくいった実行記録(トレース)を「お手本」として見せて真似させる。正解がはっきりした単純なタスク向き。
- RL(強化学習):試させて、結果に点数をつけ、点が高くなるやり方を覚えさせる。正解の手順が一つに決まらない複雑なタスク向き。
効果は大きい一方、学習用のデータ・計算資源・評価の仕組みが必要で、3層の中で一番重い改善です。
ハーネスの改善:コード・プロンプト・ツールを直す
トレースを分析して「どこで、なぜ失敗したか」を見つけ、制御のコード、システムプロンプト、ツールの作りを直します。
講演で紹介されていたLangSmith Engineは、大量のトレースから失敗を自動で分類(似た失敗をまとめる)し、修正案をPR(プルリクエスト)として提案するところまでを自動化し、マージ前に人間がレビューします。原因調査・失敗の集約・修正案の作成を自動化し、最終判断だけを人間に残す構成です。
コンテキストの改善:記憶を育てる
テキストを書き換えるだけなので、3層の中で最も手軽です。再学習もコード変更もいりません。
具体的には、ユーザー単位・組織単位の「記憶(メモリ)」をバックグラウンドで蓄積・修正していきます。「この人は結論から読みたい」「この会社ではこの用語をこう使う」といった情報が貯まるほど、同じモデル・同じハーネスでも応答が良くなります。使うほど賢くなるを最も直接的に実現できる層です。
どの層から手を入れるか
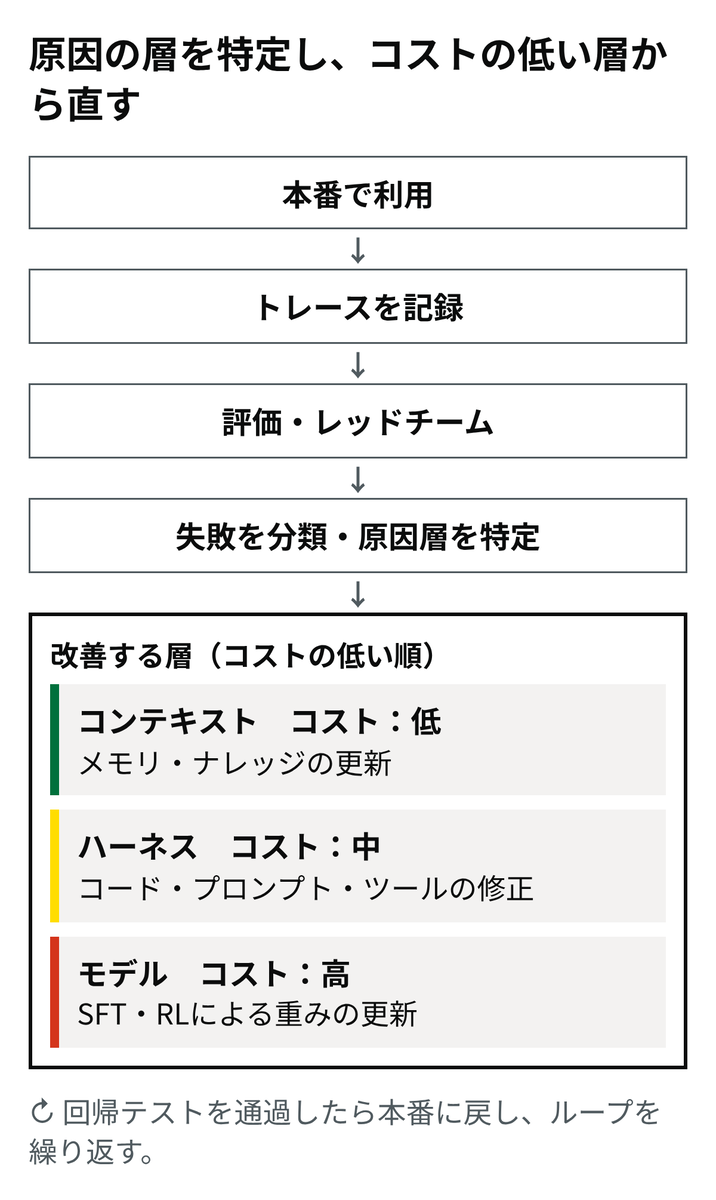
3層それぞれの改善コストと切り戻しのしやすさを比較すると、次のとおりです。
| 層 | 変更対象 | 改善コスト | 切り戻し | 対象となる失敗 |
|---|---|---|---|---|
| コンテキスト | メモリ、ナレッジ、ツール定義 | 低 | 容易 | ドメイン知識・ユーザー固有情報の不足 |
| ハーネス | オーケストレーションのコード、プロンプト、ツール実装 | 中 | バージョン管理で可能 | 手順の誤り、ツール呼び出しの失敗、検証の漏れ |
| モデル | SFT・RLによる重みの更新 | 高(学習データ・計算資源・評価基盤が必要) | 困難 | 推論能力そのものの不足 |
失敗の原因をトレースで特定したうえで、コンテキスト → ハーネス → モデルの順に対処を検討すると、コストと影響範囲を最小限に抑えられます。
3. 改善ループの土台:トレースと評価
どの層を直すにしても、「何が起きたか」と「何が良いのか」が分からなければ直しようがありません。それを支えるのがトレースと評価です。
トレース(Traces):実行の記録
入力、出力、途中でどのツールをどう呼んだか、という実行の全手順を記録したデータです。
従来のログとの違いは、従来のログが「エラーが出たか」を見るためのものなのに対し、トレースは「意味として正しかったか」を後から検証するためのものだという点です。エラーなく動いたのに答えがズレている、という失敗はトレースを読まないと見つかりません。エージェントのトレースは長く大量になるため、講演では専用のデータベース(SmithDB)が使われていると紹介されていました。
評価(Evals):AI開発の新しい仕様書
「何が良い出力・良い振る舞いなのか」を定義し、自動で点数をつける仕組みです。講演では、EvalsがAI開発における新しいPRD(製品要求仕様書)になる、と表現されていました。
従来の仕様書は「この入力ならこの出力」と決め打ちできました。エージェントは出力が毎回変わるので、代わりに「この観点を満たしていれば合格」という評価基準を先に決め、シミュレーション環境で繰り返しテストします。変更による回帰も評価で検出できます。
レッドチーム(Red Teaming):本番前の脆弱性検出
本番で問題が起きる前に、敵対的な入力を意図的に与えて弱点を洗い出す手法です。講演では、似た質問を言い回しを変えて投げ、答えが矛盾しないかを自動で確かめる例が紹介されていました。
全体像
考察
改善ループ自体が差別化要因になる
汎用モデルは誰でも利用できるため、差が出るのは自社業務に合わせたハーネスとコンテキスト、およびそれらを継続的に更新するループです。LangChainも10月のニュースレターで、モデル・ハーネス・コンテキストを自社で保有することが長期的な価値につながる、という趣旨を述べています。
評価は実装より先に定義する
評価基準がなければ、変更が改善なのか劣化なのかを判定できません。Evalsを先に定義しておけば、プロンプトやツールを変更するたびに回帰テストとして実行でき、チーム内の判断基準も統一できます。
修正対象の層はトレースで特定する
本番での失敗は、必要な情報が渡っていない(コンテキスト)か、手順や検証が欠けている(ハーネス)ことに起因するケースが多くあります。モデルの再学習に着手する前に、トレースで原因の層を特定することが前提になります。
関連記事
エージェントの実行を明示的なグラフで設計する方法は、次の記事で解説しています。
改善をモデルの重みまで進める方法は、次の記事で解説しています。
出典
- 講演動画:LangChain「How to Build Agents That Improve Over Time: Model, Harness, Context | Interrupt London」 https://youtu.be/xy_7SzwsIjM
- LangChain Blog「How to Build a Custom Agent Harness」(2026/6/3) https://www.langchain.com/blog/how-to-build-a-custom-agent-harness
- LangChain Docs「Deep Agents」 https://docs.langchain.com/oss/javascript/deepagents/harness/index.html
- LangChain Blog「October 2026: LangChain Newsletter」 https://www.langchain.com/blog/october-2026-langchain-newsletter