NVIDIA Snapshotとは?LLM推論サーバーの起動を「数分→数十秒」にする、CPU・GPUメモリのチェックポイント/復元
結論:NVIDIA Snapshotは、LLMの推論サーバーが回答できる状態になった時点のCPUメモリとGPUメモリを丸ごと保存し、新しいサーバーはそこから復元して起動する仕組みです。起動にかかる時間は、通常の起動の8〜36倍短くなります。
ポイントは次の3つです。
- 問題:LLMの推論サーバーは起動に数分〜十数分かかり、アクセスの急増や障害に素早く対応できない
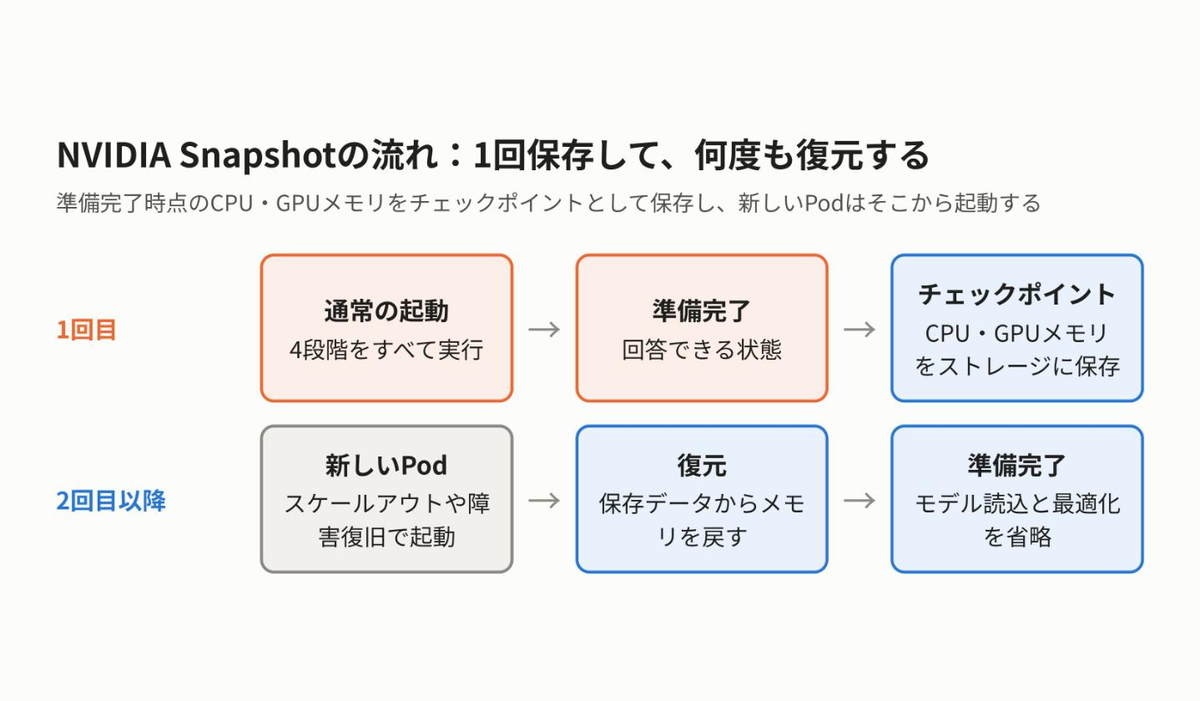
- 仕組み:準備完了時点の状態をチェックポイントとして1回保存し、2回目以降はそこから復元する。モデルの読み込みと最適化の工程を省ける
- 効果と制約:NVIDIAの測定では、8枚のGPUを使う大型モデルでも43秒以内に回答できる状態になった。ただし、保存時と同じGPU・ドライバーでしか復元できない
2026年11月10日に、NVIDIAのDSX AI Factory Platformの部品としてオープンソースで公開されました。
前提:LLMの推論サーバーは、なぜ起動が遅いのか
ChatGPTのようなサービスでは、「推論サーバー」と呼ばれるプログラムがGPU上で動き、質問を受けて回答を生成しています。推論サーバーは、起動してすぐには回答できません。NVIDIAは起動(コールドスタート)を次の4段階に分けています。
| 段階 | 処理内容 |
|---|---|
| ① 起動 | プロセスの立ち上げ、ライブラリの読み込み、GPU間通信の初期化、一部のJITコンパイル |
| ② モデル読込 | 数GB〜1TB近いモデルの重み(学習済みのパラメータ)をGPUメモリに転送する |
| ③ 初期化 | メモリ使用量の計測、KVキャッシュ(会話の途中経過を保持する領域)や作業用バッファの確保 |
| ④ 最適化 | コンパイル、性能の自動調整、CUDAグラフ(GPUへの一連の命令をまとめて記録したもの)の取得 |
通常の起動では、この4段階を毎回最初から実行します。
起動が遅いと、次の3つの問題が起きます。
- スケールアウトが遅れる:アクセスが急に増えてサーバーを追加しても、使えるまで数分かかる
- 障害からの復旧が遅れる:1台が停止して代わりを起動するまで、その分の処理能力が欠ける
- GPUが遊ぶ:起動中のGPUは高価なのに、回答を1つも生成しない
Snapshotの仕組み
1回目:通常どおり起動し、準備完了の状態を保存する
Snapshotはまず、推論サーバーを通常どおり起動します。4段階が終わって回答できる状態になった時点で、CPUのメモリとGPUのメモリの内容を、持ち運べる形式でストレージに保存します。これをチェックポイントと呼びます。保存は構成(モデル・GPU数・推論エンジンの組み合わせ)ごとに1回だけです。
2回目以降:保存データから復元する
スケールアウトや障害復旧で新しいPod(Kubernetesでアプリを動かす単位)を起動するときは、保存データから復元します。②モデル読込と④最適化を実行せずに、チェックポイント時点から処理を再開できます。
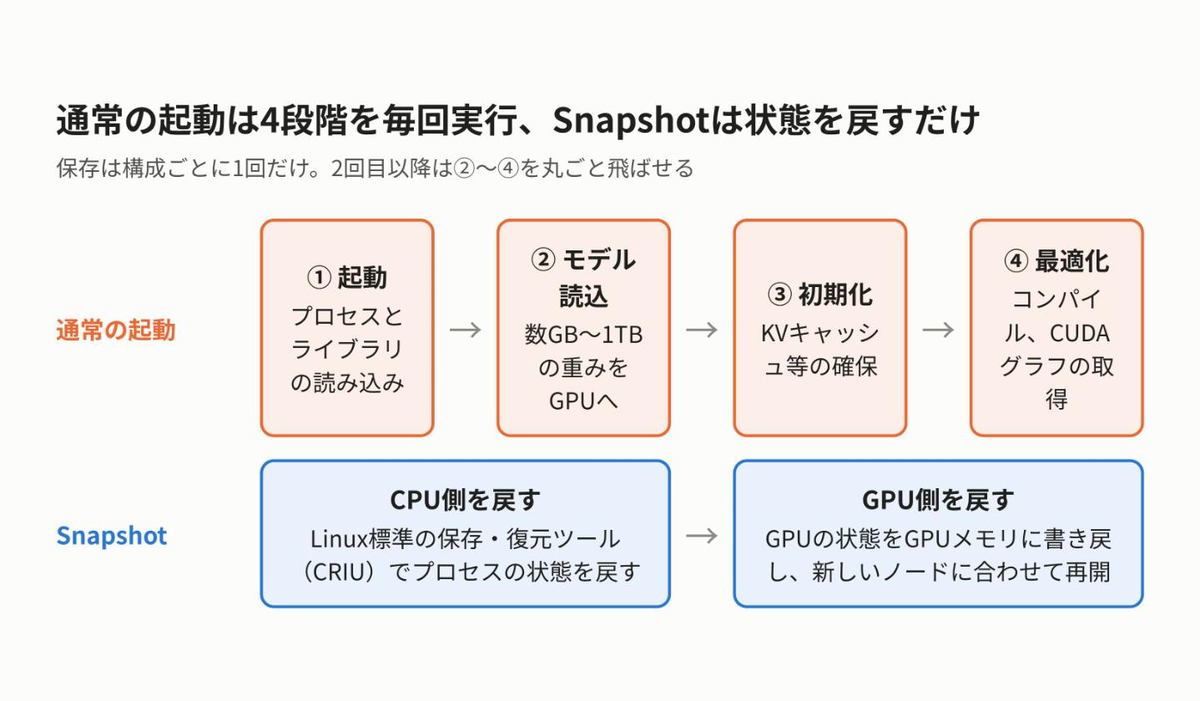
復元は2つの工程で進みます。
- CPU側の復元:Linux標準のプロセス保存・復元ツール CRIU(Checkpoint/Restore in Userspace)で、プロセスの状態をホストメモリに戻す。この工程の時間は、主に保存先ストレージの読み出し速度で決まる
- GPU側の復元:GPUの状態をGPUメモリに書き戻す。最後に、ノードに常駐するSnapshotエージェントが、新しいノードの環境に合わせて再マッピングを行い、処理を再開させる
KVキャッシュは、リクエストごとの一時的なデータなので、チェックポイントの前に解放します。保存データには含まれません。
Kubernetesからの使い方
Snapshotは、Kubernetesのカスタムリソースとして操作します。
| 操作 | 方法 |
|---|---|
| 動作中のPodを保存する | PodSnapshot リソースを作成する |
| テンプレートからPodを起動し、準備完了後に保存する | SnapshotJob リソースを作成する |
| 保存データから新しいPodを起動する | Podに nvidia.com/restore-from アノテーションを付け、PodSnapshotの名前を指定する |
推論エンジン側には、「チェックポイントの直前に一時停止し、復元後に再開する」というハンドシェイクの実装が必要です。リポジトリには、vLLM、SGLang、TensorRT LLM向けの実装例が含まれています。1ノード内で複数GPUを使う構成(テンソル並列、データ並列とエキスパート並列の組み合わせなど)にも対応しており、全ランクを1つの保存データとして扱います。
測定結果
NVIDIAは、B200 GPU(ドライバー615.71.09)とVAST DataのNFSストレージで測定しています。コンテナイメージの取得やインフラの準備時間は含まれていません。
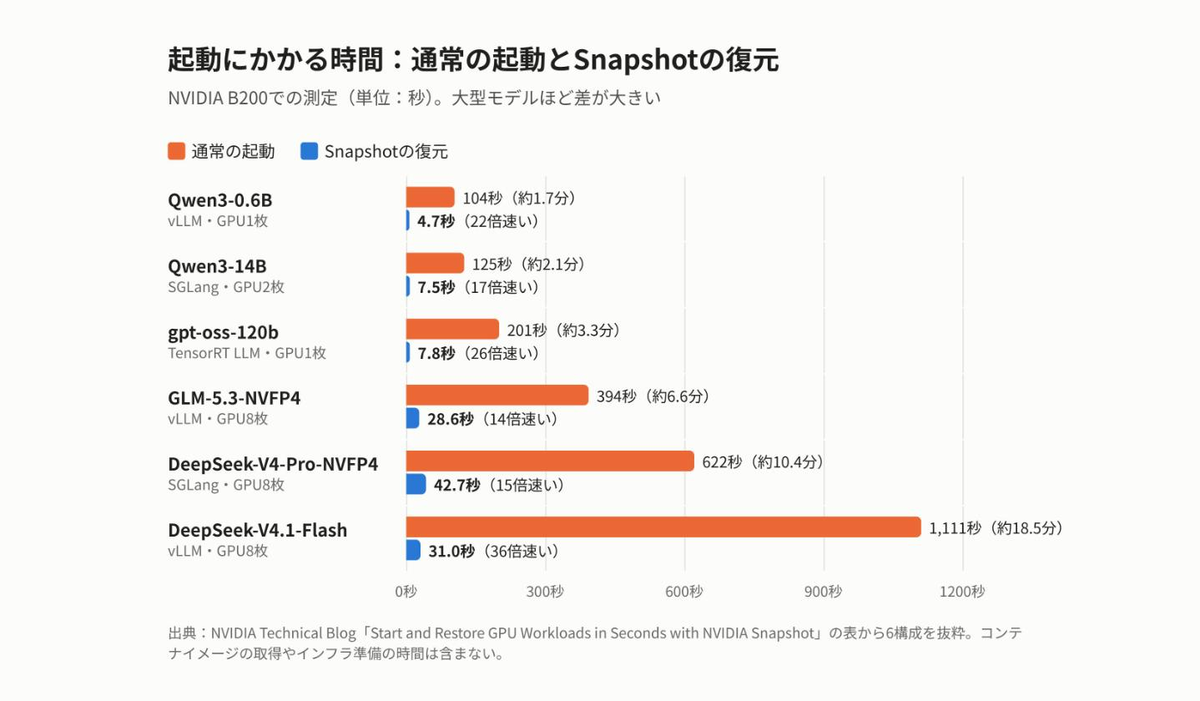
結果から読み取れることは3つあります。
- 起動に時間がかかる構成ほど短縮幅が大きい:最大の35.87倍は、通常の起動に1,110.65秒(約18.5分)かかっていたDeepSeek-V4.1-Flash(GPU8枚)で出ている
- 大型モデルでも1分以内:GPU8枚の構成でも、復元は42.7秒以内に収まった。内訳はGPU側の復元が18〜29秒、CPU側(CRIU)の復元が4.2〜10.8秒
- 保存の時間はすぐ回収できる:チェックポイントの作成には15秒〜約5.5分かかるが、構成ごとに1回だけ。測定したすべての構成で、「保存+復元」の合計が「通常の起動1回」より短かった
クラウド事業者の検証(HGX B300)でも効果が出ています。CrusoeはGLM-5.3のPodが使える状態になるまでの時間を約8分から31秒に、Saturn CloudはvLLMの起動時間を2〜8.5分から6〜34秒に短縮しました。
制約
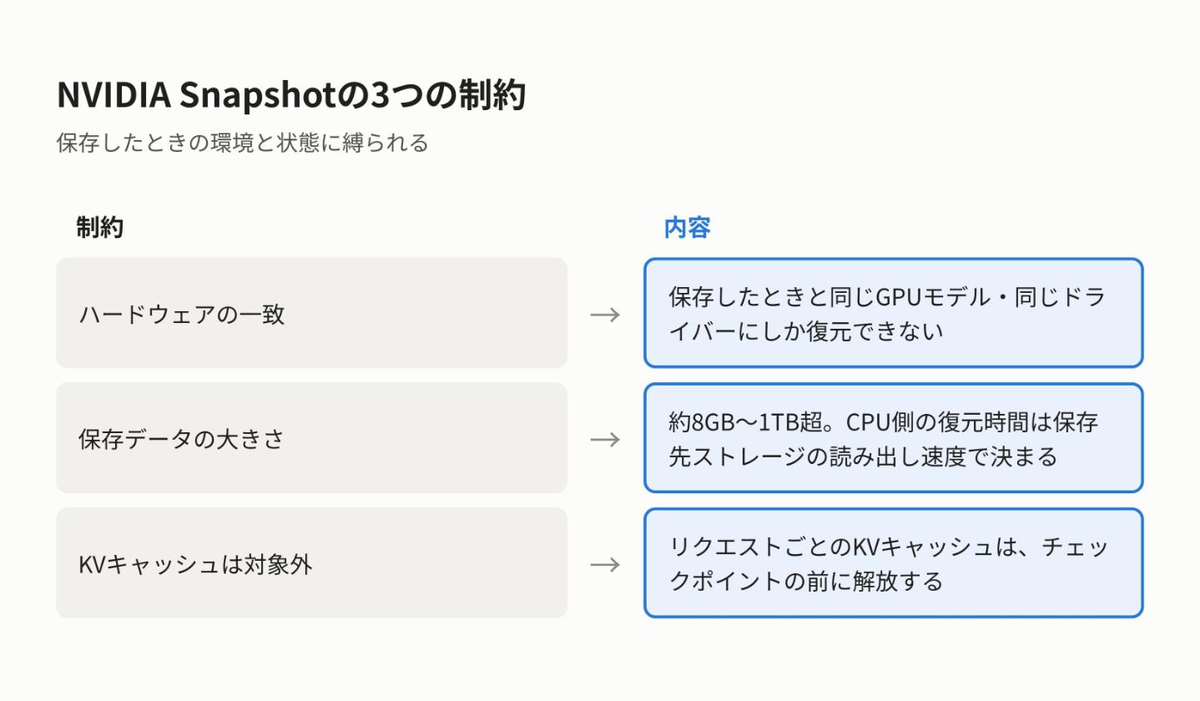
- ハードウェアの一致:保存したときと同じGPUモデル・同じドライバーのノードにしか復元できません
- 保存データの大きさ:保存データは約8GB〜1TB超になります(例:SGLangでgpt-oss-120bをTP4で動かした場合は693.89GB)。CPU側の復元時間はストレージの読み出し速度に依存し、公開されている測定は1種類のストレージ構成だけです
- 対象範囲:1ノード内の複数GPUまでが対象です。複数ノードにまたがる構成は扱われていません
- 成熟度:NVIDIA Dynamo(NVIDIAの推論基盤)との連携ガイドは「実験的」とされています
まとめ
- LLMの推論サーバーは、起動・モデル読込・初期化・最適化の4段階を毎回実行するため、起動に数分〜十数分かかる
- NVIDIA Snapshotは、準備完了時点のCPU・GPUメモリをチェックポイントとして保存し、新しいPodはそこから復元する
- 通常の起動より8〜36倍速く、GPU8枚の大型モデルでも43秒以内に回答できる状態になった
- 同じGPU・ドライバーでしか復元できず、復元時間は保存先ストレージの速度に左右される
あわせて読みたい
- ③ Dynamo:KVキャッシュをデータセンター全体で再利用する
起動した推論サーバーでKVキャッシュを再利用する仕組み - Agent Substrate:待機の長いエージェントを少数のPodで動かす
同じくPodの起動待ちを減らす、エージェント向けの仕組み - OpenShell:AIエージェントの実行環境とCNCFへの寄贈
同時に発表された部品の全体像
参考