EmbeddingGemma 2とGemma 4 12Bで作るビデオRAG
複数本の動画を横断検索して回答するビデオRAGは、オープンモデル2つ(埋め込み用のEmbeddingGemma 2、生成用のGemma 4 12B)だけでローカル環境に構築できる。Sam Witteveen氏のYouTube動画「Building a Video RAG with EmbeddingGemma2」では、約15本の動画ライブラリを対象にこの構成を実装し、200件以上のクエリで評価している。結果は、テキスト・画像・音声をまとめた融合(Fused)埋め込みが最も精度が高く、参照するチャンク数(Top-K)を増やすと正解率は最大約87%に達した。
本記事では、動画の内容を軸に、モデルの公式仕様と設計上の判断ポイントを補って構成を解説する。
Building a Video RAG with EmbeddingGemma2
ビデオRAGとは
ビデオRAGは、動画ライブラリから質問に関係する区間を検索し、その区間の情報をLLMに渡して回答を生成する仕組みである。テキストRAGとの違いは、検索対象が「話した内容」「映っている映像」「音」の3つの情報源を同時に持つ点にある。
動画には次の3つの難しさがある。
- 検索単位が決まっていない:文書には段落があるが、動画には区切りがない。どこで切るかを設計する必要がある。
- 情報源が複数ある:発話の文字起こしだけを索引にすると、話されずに画面に映っているだけの内容(スライド、図、実演)は検索できない。
- データ量が多い:1秒ごとにフレームを抽出すると、1時間の動画で3,600枚になる。ベクトルの次元数とストレージ容量の管理が必要になる。
動画で紹介された構成は、この3点をそれぞれ「文字起こし基準のチャンク分割」「マルチモーダル埋め込み」「マトリョーシカ埋め込み」で解決している。
使うモデル:EmbeddingGemma 2とGemma 4 12B
検索側をEmbeddingGemma 2、生成側をGemma 4 12Bが担う。どちらもApache 2.0ライセンスのオープンモデルで、商用利用とローカル運用ができる。
| 項目 | EmbeddingGemma 2 | Gemma 4 12B |
|---|---|---|
| 役割 | 埋め込み(検索) | 回答生成・推論・文字起こし |
| 公開日 | 2026年10月6日 | 2026年6月3日 |
| パラメータ数 | 約7.4億(740M) | 120億(12B) |
| 入力 | テキスト・コード・画像・動画・音声 | テキスト・画像・音声 |
| 出力 | 768次元ベクトル(128/256/512に縮小可) | テキスト |
| 特徴 | Gemma 4のデコーダー構造をベースにした統一ベクトル空間 | エンコーダーを持たない統合型マルチモーダル |
| 動作環境の目安 | コンシューマーGPU・CPUでオフライン動作 | VRAMまたはユニファイドメモリ16GB |
EmbeddingGemma 2は、テキスト・画像・音声などを同じ768次元の空間に配置する。テキストとコードは約2.7億パラメータのコアで処理し、画像・動画は視覚エンコーダー、音声は音声エンコーダーを経由して同じ空間に投影するモジュール構成である。テキストは最大8,192トークン、100以上の言語に対応する。前世代のEmbeddingGemma 1(約3億パラメータ、Gemma 3ベース)はテキスト専用で、コンテキスト長は2Kだった。(公式ドキュメント、開発者ガイド)
Gemma 4 12Bは、画像と音声を別エンコーダーで前処理せず、言語モデル本体で直接扱う。中規模のGemmaとして初めて音声入力にネイティブ対応し、ベンチマークでは26B MoEモデルに近い性能を、半分以下のメモリで出す。フレームと音声を同時に解析して数分の動画を理解できるため、文字起こしと回答生成の両方に使える。(Google公式ブログ)
2つのモデルはトークナイザーと音声エンコーダーの構造を共有しており、同じマシンに同居させたときの合計メモリ使用量が下がる。
パイプライン全体像
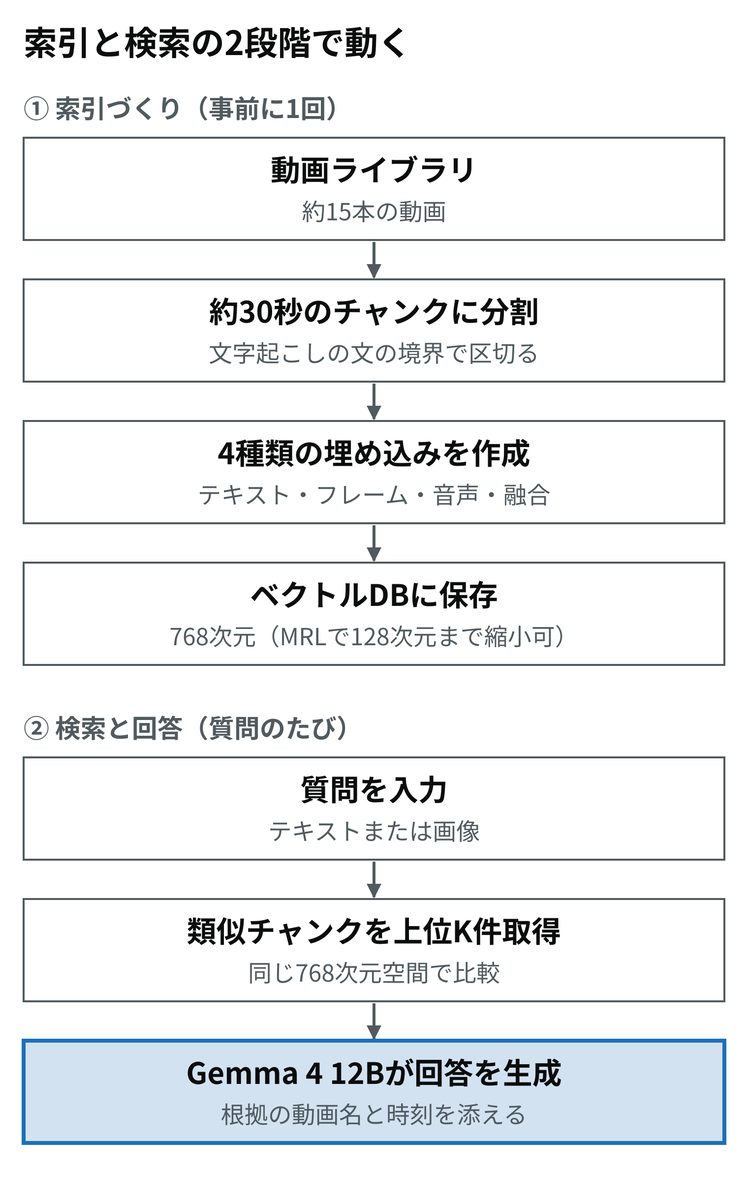
索引づくりは動画を追加したときに1回だけ実行し、質問のたびに動くのは下の3段階だけである。
チャンク分割:文字起こし基準で約30秒
動画は約30秒単位のチャンクに分割する。ただし30秒で機械的に切らず、文字起こしの文境界に合わせて切る。固定長で切ると発話が文の途中で分断され、前半と後半が別のチャンクになり、どちらも意味が通らないベクトルになるためである。
手順は次のとおり。
- 動画から音声を抽出し、WhisperまたはGemma 4で文字起こしする(タイムスタンプ付き)。
- 文の終わりのタイムスタンプを候補として、累積時間が約30秒に達した位置で区切る。
- 各チャンクに開始・終了時刻、動画タイトル、文字起こし、その区間のフレーム(1秒ごと)、音声区間を紐付ける。
30秒という長さは、検索結果として返したときに人が確認しやすく、かつ1チャンクに1つの話題が収まりやすい長さである。チャンクを長くすると複数の話題が混ざって類似度が薄まり、短くすると文脈が足りず生成時の情報が不足する。
4種類の埋め込み
1つのチャンクから4種類の埋め込みを作り、検索精度を比較する。すべて同じ768次元空間に入るため、どの種類のベクトル同士でもコサイン類似度を計算できる。
| 種類 | 入力 | 拾える情報 | 拾えない情報 |
|---|---|---|---|
| テキスト | 文字起こし+動画タイトル+キャプション | 話された内容、固有名詞 | 画面にだけ出ている内容 |
| フレーム | 1秒ごとの静止画 | スライド、図、実演の画面 | 話された説明 |
| 音声 | チャンクの音声のみ | 話し方、効果音、音楽 | 映像の内容 |
| 融合(Fused) | 上記3つを統合 | 3つの情報源すべて | ― |
フレームは1秒ごとに抽出するため、30秒チャンクなら約30枚になる。チャンク単位で1本のベクトルにするには、各フレームのベクトルを平均してから正規化する方法か、複数枚を1つの入力としてまとめて埋め込む方法をとる。
融合埋め込みの作り方も同様に2通りある。各モダリティのベクトルを重み付き平均して正規化する方法(後から重みを調整できる)と、EmbeddingGemma 2がサポートするインターリーブ入力でテキスト・画像・音声を1回の推論に渡す方法(モダリティ間の関係をモデル側で捉えられる)である。
単一モダリティの埋め込みは、それぞれ拾えない情報を持つ。融合埋め込みはこの欠落を互いに補うため、どの種類の質問にも安定してヒットする。
マトリョーシカ埋め込みと次元の選び方
マトリョーシカ埋め込み(Matryoshka Representation Learning、MRL)は、768次元のベクトルの先頭から512・256・128次元を切り出しても、それぞれが単独で使える埋め込みになるよう学習する手法である。学習時に複数の次元数で同時に損失を計算するため、重要な情報ほどベクトルの先頭側に集まる。
次元数とストレージの関係は次のとおり(float32、1ベクトルあたり)。
| 次元数 | サイズ | 768次元比 | 用途 |
|---|---|---|---|
| 768 | 3,072バイト | 1 | 精度最優先、最終順位付け |
| 512 | 2,048バイト | 2/3 | 精度と容量のバランス |
| 256 | 1,024バイト | 1/3 | 大規模ライブラリの一次検索 |
| 128 | 512バイト | 1/6 | 候補の絞り込み、エッジ端末 |
公式ドキュメントでも、MRLによりベクトルDBのストレージコストを最大6分の1にできるとしている。フレーム埋め込みのように件数が多いデータほど効果が大きい。
実運用では2段階検索が有効である。128次元で全件から上位数百件を高速に絞り込み、その候補だけを768次元で再計算して最終順位を決める。sentence-transformersでは読み込み時に次元を指定できる。
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2", truncate_dim=256)
切り出したベクトルは再正規化してからコサイン類似度を計算する。
画像クエリによるクロスモーダル検索
クエリはテキストに限らない。画像をクエリとして埋め込めば、その画像と似た内容が映っている動画区間を検索できる。動画では、レオナルド・ダ・ヴィンチの「ウィトルウィウス的人体図」を入力し、発話でその図に触れていない区間からも該当シーンを取り出している。
これが成立するのは、クエリ画像とフレームが同じ768次元空間に入っているためである。検索の組み合わせは次の4通りになる。
| クエリ | 検索対象 | 用途の例 |
|---|---|---|
| テキスト | テキスト埋め込み | 「○○について説明している箇所」 |
| テキスト | フレーム埋め込み | 「グラフが映っている場面」 |
| 画像 | フレーム埋め込み | スクリーンショットから元動画の該当箇所を特定 |
| 画像 | 融合埋め込み | 図とその解説が両方ある区間を特定 |
文字起こしだけを索引にした従来の動画検索では、画像クエリ・映像だけの内容のどちらにも対応できない。マルチモーダル埋め込みを使う最大の利点はここにある。
評価結果:融合埋め込みとTop-K
動画では200件以上のクエリで4種類の埋め込みを比較し、融合埋め込みが最も高い精度を示した。さらにLLMに渡すチャンク数(Top-K)を増やすと、正解率は最大約87%まで上がった。
この評価が測っているのは、正解のチャンクが上位K件に含まれる割合(Recall@K、ヒット率)である。Top-Kを増やすと正解が候補に入る確率は単調に上がるが、次のコストも増える。
- 生成側の入力が長くなる:K件分の文字起こしとフレームをGemma 4 12Bに渡すため、推論時間とメモリ使用量が増える。
- ノイズが混ざる:無関係なチャンクが増えると、生成モデルが誤った区間を根拠に回答するリスクが上がる。
そのためKは「検索の正解率が頭打ちになる手前」で止めるのが基本である。自前のライブラリで評価する場合は、質問と正解区間(動画ID+開始秒)の組を作り、埋め込みの種類×K×次元数の組み合わせごとにRecall@Kを測る。
アーキテクチャ:Next.js+FastAPI+2モデル
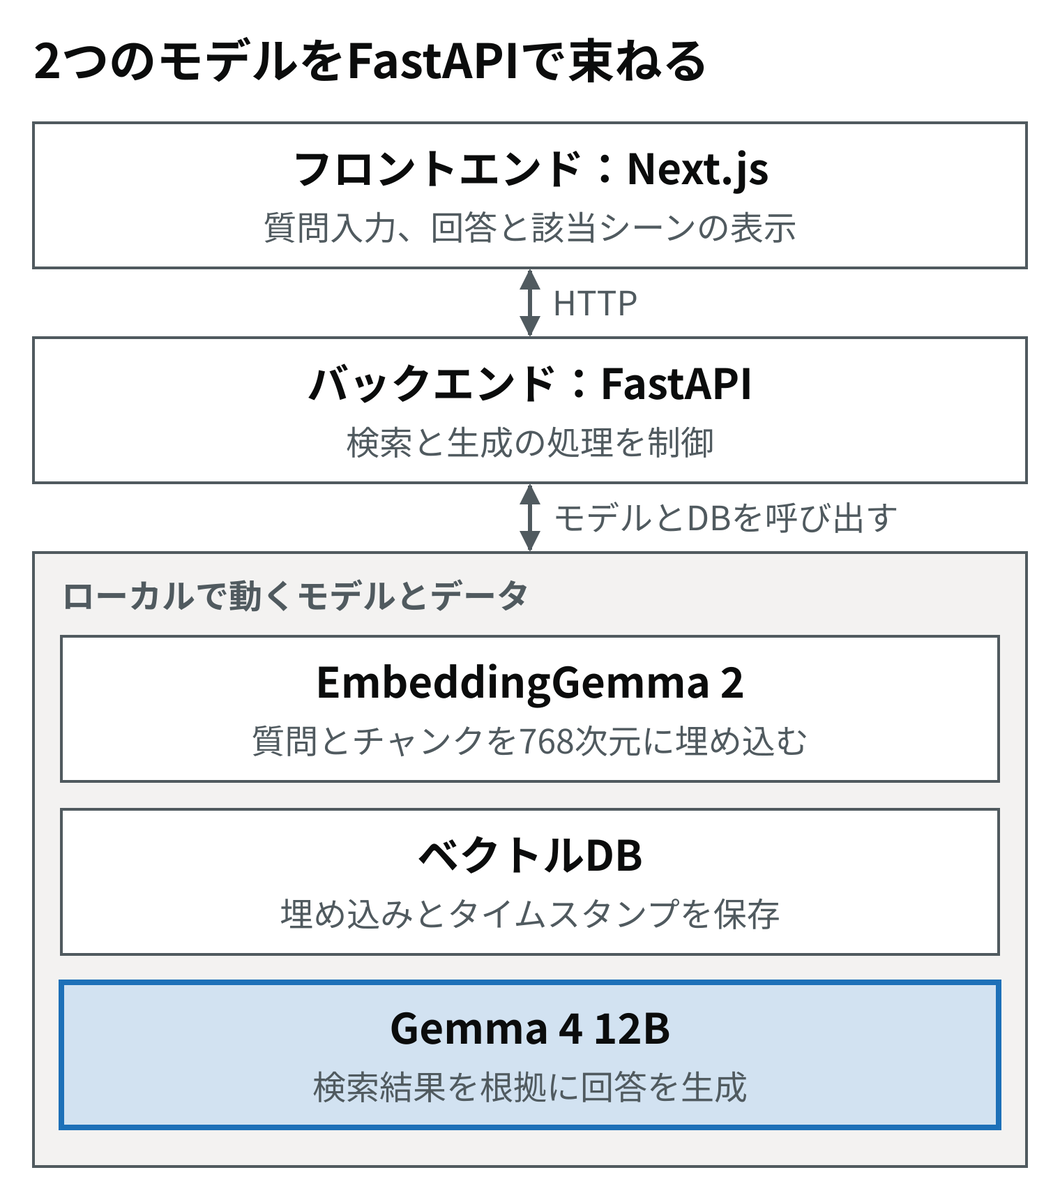
アプリケーションは、Next.jsのフロントエンドとFastAPIのバックエンドの2層で構成する。モデルの推論はPythonのエコシステム(sentence-transformers、Transformers)で行うため、バックエンドをPythonのFastAPIにすると推論コードをそのままAPI化できる。
質問1件あたりの処理は、①質問をEmbeddingGemma 2で埋め込む、②ベクトルDBから上位K件のチャンクを取得する、③チャンクの文字起こし・フレームをGemma 4 12Bに渡して回答を生成する、の3ステップである。外部APIを呼ばないため、社外に出せない動画でもデータを手元に置いたまま検索できる。
メモリの目安は、Gemma 4 12Bが16GB、EmbeddingGemma 2がその外側で約7.4億パラメータ分である。GPUが1枚しかない場合は、索引づくりと回答生成を同時に走らせず、時間を分けて実行する。
実装上の注意点
- 精度型はbfloat16かfloat32:EmbeddingGemma 2の活性値はfloat16と互換性がない。float16で動かすと埋め込みが壊れるため、対応GPUではbfloat16、それ以外はfloat32を使う。
- 不要なエンコーダーは読み込まない:EmbeddingGemma 2はvision_configとaudio_configで読み込むエンコーダーを選べる。テキストと画像だけで足りる用途なら音声エンコーダーを外してメモリを節約できる。
- ライブラリのバージョン:sentence-transformersはv6.1.0以降が必要。動画・音声入力には追加の依存(
sentence-transformers[image,audio,video])を入れる。 - タイムスタンプを必ず保持する:回答に「どの動画の何分何秒か」を添えると、利用者が元動画で根拠を確認できる。チャンクのメタデータに動画IDと開始・終了秒を保存する。
- フレームの重複を減らす:スライドが映り続ける区間では、1秒ごとのフレームがほぼ同一になる。前フレームとの類似度が閾値以上なら捨てると、件数とストレージを削減できる。
- 評価セットを先に作る:埋め込みの種類、次元数、Top-Kの最適値はライブラリの内容で変わる。構築前に質問と正解区間の組を用意しておく。
参考として、テキストと画像を同じ空間に埋め込む最小コードは次のとおり。
from sentence_transformers import SentenceTransformer
from PIL import Image

model = SentenceTransformer("google/embeddinggemma-2")

text_emb = model.encode(["人体の比率を示した図"])
image_emb = model.encode([Image.open("frame_0123.jpg")])

print(model.similarity(text_emb, image_emb))
まとめ
- ビデオRAGは、EmbeddingGemma 2(検索)とGemma 4 12B(生成)の2モデルで、クラウドAPIを使わずにローカル構築できる。
- 精度を決めるのは埋め込みの設計である。文字起こし基準の約30秒チャンクに対し、テキスト・フレーム・音声を統合した融合埋め込みを作り、Top-Kを調整すると正解率は約87%に達する。
- 768次元の空間に画像とテキストが同居するため、画像クエリで発話のない映像区間も検索でき、MRLで次元を落とせばストレージは最大6分の1になる。