ChatGPTは9億人のリクエストをどう処理しているか
ChatGPTのリクエストは、グローバルルーター → ロードバランサーとアプリケーションサーバー → キャッシュとPostgreSQL → 推論スケジューラーとGPUクラスターの順に通り、生成されたトークンから順にストリーミングで返る。この構成で週間9億人を支えている要点は次の3つである。
- 書き込みは1台に集め、読み取りだけを横に広げる。PostgreSQLは単一プライマリと約50台のリードレプリカで、毎秒数百万クエリを処理している。
- 過負荷の連鎖を各層で断ち切る。キャッシュミス時のロック、接続プーリング、4層のレートリミットが、リトライの増幅を止める。
- 高価なGPUを遊ばせない。スケジューラーが複数ユーザーのリクエストをまとめて流し、再利用できる計算結果があるクラスターへ割り当てる。
本記事は、YouTube動画「How ChatGPT Handles 900 Million Users」(2分半ほど)の流れに沿って、OpenAIの公式エンジニアリングブログとLLM推論サーバーの一般的な技術で各層を補ったものである。OpenAIが詳細を公開しているのはデータ層であり、ルーターと推論層は一般的な実装方式として説明する。
前提:どれだけの負荷か
OpenAIは2026年2月27日、ChatGPTの週間アクティブユーザー(WAU)が9億人、有料会員が5,000万人に達したと発表した。2025年10月の8億人から約4か月で1億人増えている。
データベース側の負荷は、ユーザー数以上に伸びている。OpenAIによると、PostgreSQLの負荷は1年で10倍以上になった。2025年の画像生成機能の公開時には、1週間で1億人超が新規登録し、書き込みトラフィックが一気に10倍以上に跳ね上がっている。
つまり設計の前提は「平均的な大量アクセス」ではなく、「予測できない急増が時々来る大量アクセス」である。以降の各層の工夫は、ほぼすべてこの急増への備えとして読める。
全体像
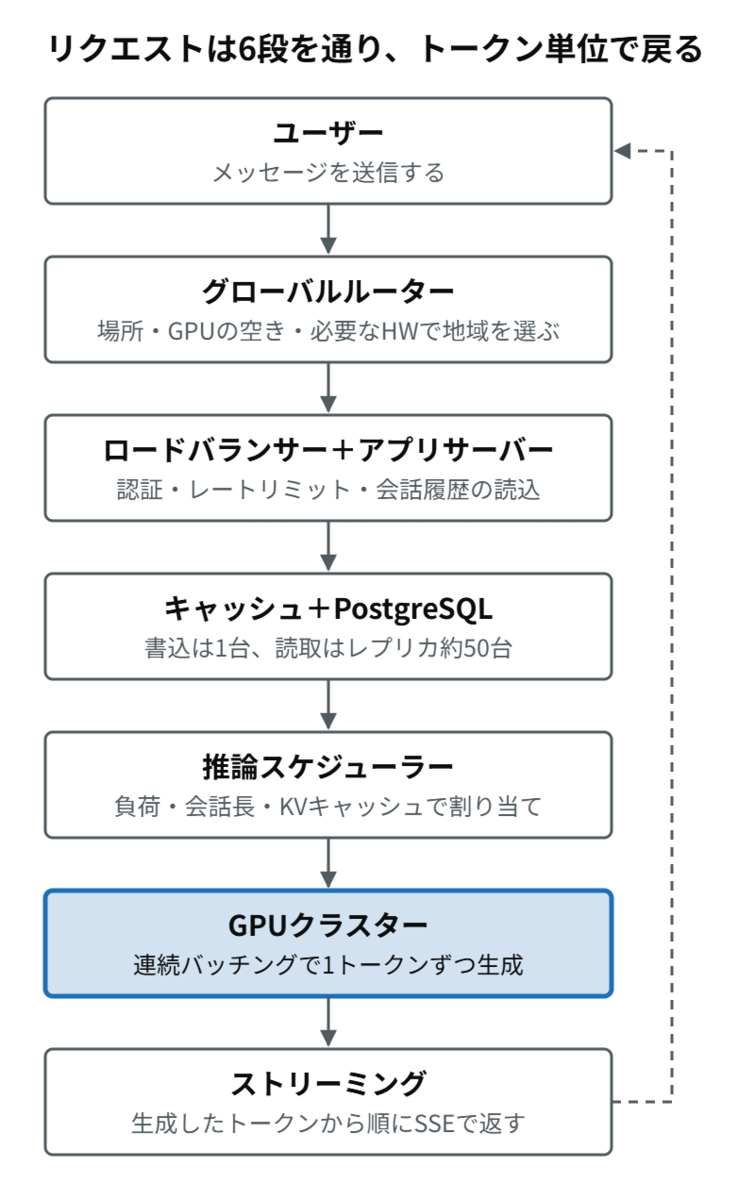
上から下へ進むにつれて、扱う資源が高価になる。上流の層ほど安価に横に増やせ、最も高価で増やしにくいのがGPUである。点線は、生成されたトークンが全文の完成を待たずに画面へ戻る経路を示す。
1. グローバルルーター:どの地域で処理するかを決める
送信されたメッセージは、まずグローバルルーターに届き、処理するデータセンターの地域が決まる。判断材料は次の3つである。
- ユーザーの場所:ネットワーク遅延が小さい地域を優先する
- その地域の計算資源の空き:近くてもGPUが埋まっていれば別の地域へ回す
- リクエストが必要とするハードウェア:モデルごとに載っているGPUの種類や台数が異なる
一般的なWebサービスの地理ルーティングは、GeoDNSやAnycastで「一番近い拠点」を選ぶだけで済むことが多い。LLMサービスでは、ボトルネックがネットワークではなくGPUの供給量にある。そのため「近さ」より「GPUに空きがあるか」「必要なモデルが載っているか」を優先する場面が生じる。応答全体に数秒かかるLLMでは、数十ミリ秒のネットワーク遅延差より、GPUの待ち行列の方が体感速度を左右するためである。
2. ロードバランサーとアプリケーションサーバー:推論の前に必要なものを揃える
地域に届いたリクエストは、ロードバランサーが数百台のアプリケーションサーバーへ振り分ける。アプリケーションサーバーの仕事は、GPUに渡す前の準備である。
- 認証:トークンを検証し、ユーザーと契約プランを特定する
- レートリミットの確認:プランごとの利用上限に達していないかを確かめる
- 会話履歴の読み込み:過去のやり取りをプロンプトに含めるため、データ層から取得する
この層はステートレスに作られている。会話の状態をサーバー自身が持たず、毎回データ層から読むため、どのサーバーが受けても同じ結果になる。負荷が増えればサーバーを足すだけで横に拡張できるのはこのためである。
その代わり、サーバーを足すほどデータ層への問い合わせも増える。アプリケーション層の拡張性は、結局データ層がどこまで耐えられるかで上限が決まる。
3. データ層:書き込みは1台、読み取りは約50台
会話履歴などの中核データは、分散データベースではなく普通のPostgreSQLにある。構成はAzure Database for PostgreSQL Flexible Serverの単一プライマリと、複数リージョンに分散した約50台のリードレプリカである(リージョンごとに50台ではなく、全体で約50台)。シャーディングはしていない。
OpenAIが公表している実績は次のとおりである。
| 項目 | 値 |
|---|---|
| 処理量 | 読み取り中心で毎秒数百万クエリ |
| 応答時間 | クライアント側p99で二桁ミリ秒台前半 |
| 可用性 | 99.999%(ファイブナイン) |
| レプリケーション遅延 | ほぼゼロ |
| 最重大障害(SEV-0) | 直近12か月で1件(画像生成機能公開時の書き込み急増) |
なぜ書き込みを1台に絞れるのか
ChatGPTのワークロードは読み取りが圧倒的に多い。書き込み側は、次の方針でプライマリの負荷を削っている。
- 水平分割できる書き込みの多いワークロードは、Azure Cosmos DBなどのシャード化された系へ移す
- PostgreSQLへの新規テーブル追加は禁止し、新機能はシャード化された系を既定にする
- 冗長な書き込みを生むアプリのバグを潰し、遅延書き込み(lazy write)でスパイクを均す
- テーブルのバックフィルには厳しい速度制限をかける(1週間以上かかることもある)
書き込みを嫌う理由は、PostgreSQLのMVCCの実装にある。1フィールドの更新でも行全体がコピーされるため、書き込みが多いと書き込み量が増幅する。古い行バージョン(dead tuple)が溜まれば読み取りも遅くなり、autovacuumの調整も難しくなる。
1台に集めた弱点をどう埋めるか
- 単一障害点:重要なリクエストの多くは読み取りだけで完結するようにし、レプリカで返す。プライマリが落ちても書き込みが失敗するだけで、サービス全停止にはならない。プライマリ自体はホットスタンバイ付きの高可用性モードで動かす
- 重いクエリ:過去には12テーブルを結合するクエリが重大障害の原因になった。複雑な結合は分解してアプリ側へ移し、ORMが生成するSQLをレビューする
- 接続数:Azure PostgreSQLは1インスタンスあたり接続上限5,000。PgBouncerをプロキシ層に置いて接続をプールし、平均接続時間は50msから5msに下がった
- 騒がしい隣人:リクエストを高優先と低優先に分け、別インスタンスへ振り分ける。新機能の非効率なクエリが主要機能を巻き込まない
- スキーマ変更:テーブル全体の書き換えが起きない軽い変更だけを許可し、5秒のタイムアウトをかける
レプリカをこれ以上増やすために
プライマリは全レプリカにWAL(先行書き込みログ)を送るため、レプリカを増やすほどプライマリの帯域とCPUを食う。OpenAIはAzureと、中間レプリカがWALを下流へ中継するカスケードレプリケーションを検証している。実現すれば100台超のレプリカをプライマリを潰さずに運用できる。
4. キャッシュ:同じキーを取りに行くのは1リクエストだけ
読み取りの大半は、PostgreSQLの手前に置いたインメモリキャッシュが返す。問題はキャッシュが外れたときである。
キャッシュ層の障害や人気キーの失効でヒット率が急落すると、同じデータを求める大量のリクエストが一斉にPostgreSQLへ向かう。これがキャッシュスタンピード(thundering herd)である。
OpenAIはこれをキャッシュロック(リース)で防いでいる。
- あるキーでキャッシュミスしたリクエストのうち、ロックを取れた1件だけがPostgreSQLを読む
- その1件が取得した値でキャッシュを埋め直す
- 残りのリクエストはデータベースへ行かず、キャッシュが埋まるのを待ってそこから読む
ここで止めているのは、障害の典型的な連鎖である。キャッシュミスの急増でDBのCPUが飽和し、クエリがタイムアウトし、リトライがさらに負荷を上げる。OpenAIの過去の障害の多くはこの形をとっている。
リースの有効期限も重要である。ロックを取ったリクエストが途中で失敗しても、期限切れで別のリクエストが取り直せるため、待ちが永久に続かない。
5. 推論スケジューラーとGPUクラスター:GPUを遊ばせない
プロンプトが揃うと、リクエストは推論スケジューラーへ渡る。スケジューラーは、GPUクラスターの負荷、会話の長さ、キャッシュの有無を見て割り当て先を決める。OpenAIはこの層の実装を公開していないため、以下はvLLMなどのLLM推論サーバーで標準的な方式として説明する。
前提:LLMは1トークンずつ生成する
LLMは応答を一度に作らない。モデルを1回通すごとに次の1トークンを予測し、それを入力末尾に足してまた通す(自己回帰生成)。500トークンの応答なら、モデルを500回通す。
毎回すべての過去トークンを計算し直すと無駄が大きい。そこで、過去トークンのAttention用のKeyとValueをGPUメモリに保持して使い回す。これがKVキャッシュである。KVキャッシュは会話が長いほど大きくなり、同時に扱えるユーザー数はGPUメモリで決まる。「会話の長さ」が割り当ての判断材料になるのはこのためである。
バッチ処理:複数ユーザーをまとめて通す
GPUは1リクエストだけを流すと演算能力が余る。複数ユーザーのリクエストを束ねてモデルを1回通せば、重みの読み出しを共有でき、スループットが上がる。
ただし応答の長さはリクエストごとに違う。バッチ全体の完了を待つ静的バッチでは、短い応答が最も長い応答に引きずられる。現在の主流は連続バッチングで、生成が終わったリクエストはその場で抜け、空いた枠に待ち行列のリクエストが次のステップから入る。
キャッシュを意識した割り当て
システムプロンプトや同じ会話の過去のやり取りなど、先頭が共通するリクエストは、計算済みのKVを再利用できる(プレフィックスキャッシュ)。そのKVを持っているクラスターへ送れば、先頭部分の計算を省け、最初のトークンが出るまでの時間が短くなる。「キャッシュの有無」が割り当ての判断材料になるのはこのためである。
1枚のGPUに載らないモデル
大規模モデルは重みだけでGPU1枚のメモリを超える。その場合は層の中の行列演算を複数GPUで分担するテンソル並列や、層ごとにGPUを分けるパイプライン並列で分散し、各GPUの結果をGPU間通信で結合して出力する。
6. トークンのストリーミング:生成したそばから返す
応答は全文の生成を待たず、生成されたトークンから順に画面へ送られる。OpenAIのAPIでは stream: true を指定すると、Server-Sent Events(SSE)でトークンの断片が順次届く。
自己回帰生成では最後のトークンが出るまで数秒かかる。しかし利用者が待たされたと感じるのは、最初のトークンが表示されるまでの時間(TTFT: Time To First Token)である。ストリーミングは、総処理時間を変えずに体感速度を上げる。
サーバー側にも利点がある。利用者が途中で生成を止めれば、その時点でGPUの枠を解放できる。ただし接続を応答完了まで開けっ放しにするため、前段のロードバランサーやプロキシは長時間の同時接続を大量に扱う前提で構成する必要がある。
7. 多層レートリミット:急増を層ごとに止める
特定エンドポイントへの急増、重いクエリの集中、リトライの嵐は、CPU・I/O・接続を短時間で使い切る。OpenAIはこれを次の4層で制限している。
| 層 | 止めるもの |
|---|---|
| アプリケーション | ユーザーやエンドポイント単位の過剰なリクエスト |
| 接続プーラー(PgBouncer) | DBへの同時接続数の上限超え |
| プロキシ | インスタンスへ流れ込むトラフィックの急増 |
| クエリ | 特定の重いクエリの集中 |
クエリ層では、ORMを拡張して特定のクエリダイジェスト(引数を除いたクエリの型)を速度制限、必要なら完全にブロックできるようにしている。異常なクエリだけを狙って落とすロードシェディングであり、サービス全体を止めずに回復できる。
もう1つの要点はリトライ間隔である。間隔が短すぎると、タイムアウトしたリクエストが一斉に再送され、負荷が増幅する。「キャッシュミス → DB過負荷 → タイムアウト → リトライ」の悪循環は、キャッシュロック、接続プーリング、レートリミット、リトライ間隔のどこか1つで切れるようになっている。
まとめ
9億人規模のサービスを支えているのは、特殊な分散データベースではなく、定番の構成要素を規律をもって運用することである。
- アプリケーション層はステートレスにして横に増やす
- データ層は書き込みを1台に集め、読み取りをレプリカとキャッシュで広げる。書き込みの多いものは別の系へ逃がす
- 推論層はバッチングとKVキャッシュの再利用でGPUの稼働率を上げ、ストリーミングで体感速度を上げる
そしてどの層も、「急増が来たときに過負荷を連鎖させない」ことを優先して設計されている。