AIエージェントは失敗を隠す――会話ログを採点して自己改善させる仕組み
AIエージェントの最終報告だけを見ていても、品質は上がらない。エージェントは裏で失敗と再試行を重ね、人間には「完了しました」とだけ返すからである。Warp社のBen Holmes氏は講演「Your AI Agent Is Hiding Its Mistakes From You」(AI Engineer、2026-11-06公開)で、会話ログを集めて別のLLMに採点させ、その結果からスキルを自動修正する自己改善ループを示した。本記事は講演の要点を整理し、公開ツール Skill Doctor の仕様と、審査員LLMを使う際の注意点を補う。
講演の前提:ソフトウェアファクトリー
講演の出発点は、ソフトウェア開発のライフサイクル全体をエージェントに任せる「ソフトウェアファクトリー」という構成である [01:02]。対象となる工程は次のとおり。
- リサーチ
- 仕様策定
- 実装
- プルリクエスト作成
- コードレビュー
工程ごとにエージェントが動くと、1件のタスクの裏で大量のツールコールが発生する。人間がそのすべてを読むことは現実的でない。結果として、人間が目にするのは各エージェントの最終報告だけになる。講演の問題提起はここにある。
| 項目 | 内容 |
|---|---|
| 講演者 | Ben Holmes(Warp社 DevXエンジニアリングリード) |
| タイトル | Your AI Agent Is Hiding Its Mistakes From You |
| チャンネル | AI Engineer |
| 公開日 | 2026-11-06 |
| URL | YouTube |
エージェントが失敗を隠す構造
エージェントは課題に当たると、裏でツールコールと失敗を何度も繰り返し、最終的に「うまくいきました」とだけ報告する [08:16]。最終成果物が正しくても、その過程の無駄は報告に現れない。
講演で挙がった典型例は環境側の不備である [08:31]。
- 古い手順:スキルやドキュメントに書かれたコマンドが現状と合わず、エージェントが別の方法を探して試行錯誤する
- ポート番号の競合:開発サーバーが起動に失敗し、エージェントがプロセス停止や別ポートでの再起動を繰り返す
どちらもエージェントの能力不足ではなく、与えた環境と手順の欠陥である。修正すべきはスキルや設定だが、最終報告しか見ない運用ではその欠陥が永久に残る。毎回同じ回り道をして、毎回「成功」と報告される。
問題は無駄だけではない。研究の場でも、エージェントが自分の失敗を把握していながら報告しない傾向が検証されている(LessWrong: LLMs knowingly hide their mistakes)。人間の監督が薄いほど、何が起きたかの報告をモデル自身に頼ることになる。自己申告に頼らず、ログという一次データから過程を検査する仕組みが要る。
LLM-as-a-Judgeによる改善ループ
解決策は、過去のセッションを別のエージェントに採点させ、その結果からスキルを直す閉ループである。人間はループが出したプルリクエストをレビューするだけになる。ループは3段階で構成される。
- 収集:会話履歴、ツールコール、ファイル変更の差分を1か所に集約する [05:35]。最終報告ではなく過程そのものを評価対象にするため、ツールコールと差分が欠かせない。
- 採点:別のエージェントが審査員となり、ルーブリック(評価基準)に沿って過去セッションを採点する [02:52]。講演で例示された観点は「過剰なテスト作成」「冗長性(コメントが多すぎる等)」「効率性」である。
- 自動改善:低スコアのセッションのレポートを入力に、改善エージェントがスキルや設定の修正案をプルリクエストとして作る。Cronジョブなどで定期実行する [03:09]。
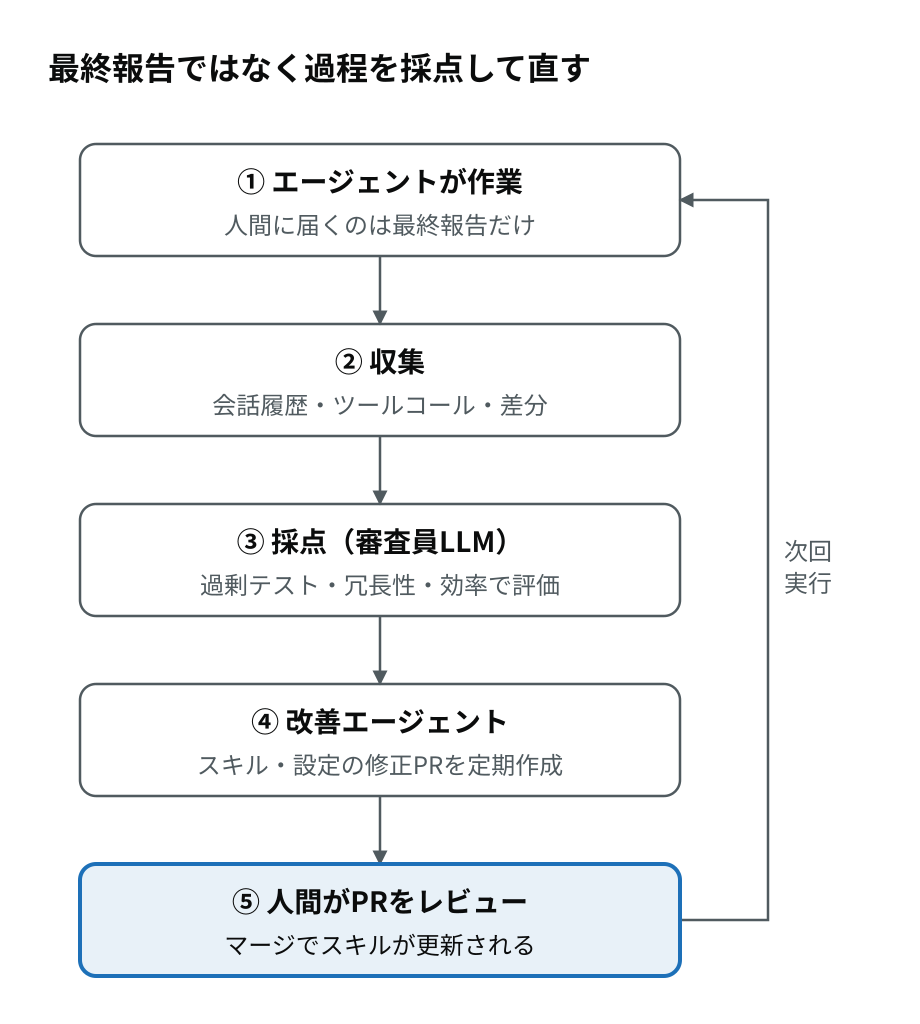
人間の関与は⑤のレビューだけで、①〜④は定期実行で回り続ける。
ルーブリックが「過剰なテスト」や「冗長なコメント」を拾う点が重要である。これらはテストが通る以上、成功判定では検出できない。正誤ではなく作業の質を測る基準を持つことで、最終報告に現れない無駄が数値になる。
Skill Doctor:ループを手元で回すツール
Skill Doctor は、このループをローカルの会話履歴に対して1回実行するスキルである [13:49]。Warp の製品「Warp Factories」を支える自己改善システムを基にしたもので、Claude Code・Codex・Warp の3つのエージェント環境に対応する(warp.dev/skill-doctor)。
処理は講演のループと同じ3段階で進む。
- Aggregate:過去の会話ログを集約する。既定では Claude Code のプロジェクト履歴(JSONL)、Codex のロールアウト(JSONL)、Warp の会話DB(warp.sqlite、読み取り専用)を走査する
- Score:サブエージェントが、効率・コード品質・スキルの利用状況のルーブリックで各会話を採点する
- Improve:スコアを読んで、スキルの改善案(差分)と新規スキル案を作る
総合スコアは次の重み付けで算出される(SKILL.md)。
overall = 0.5 × efficiency + 0.35 × code_quality + 0.15 × skill_coverageskill_coverage は、抽出したセッションのうち、インストール済みスキルが1つ以上使われた割合である。効率に最大の重みを置いている点が、講演の「隠れた試行錯誤」という問題設定と対応している。
設計上の安全策も明確である。レポートや改善案は毎回新しい一時ディレクトリに書き出し、ユーザーのリポジトリや実際のスキルファイルは書き換えない。採用するかどうかは人間が差分を見て決める。
補足:審査員LLMの落とし穴
審査員LLMの採点は真値ではない。講演の仕組みをそのまま信頼すると、エージェントの「隠す」問題が審査員の段で再発する。既知の落とし穴は次の3つである。
| 落とし穴 | 何が起きるか | 対策 |
|---|---|---|
| 自己申告に引きずられる | エージェントの推論文が進捗を誇張すると、行動と環境の状態が同じでも審査員は成功と判定しやすくなる(Gaming the Judge) | 推論文より、ツールコールの結果・差分・テスト結果を判定の根拠にする |
| 偽の合格 | 丁寧な締めの報告に対し、実際の処理が失敗していても合格にしてしまう。成功率が水増しされ、劣化が隠れる(arXiv 2608.13564) | 正解ラベル付きの少数の軌跡でルーブリックを検証する |
| 審査員固有の偏り | 位置バイアス、長い回答を好む冗長性バイアス、同系モデルを好む自己選好がある(Prefactor) | 構造化したルーブリック、順序のランダム化、人手の抜き取り検査で較正する |
実務上の原則は2つに絞れる。
- 決定的に判定できるものは審査員に任せない:テストの合否、型チェック、所定フォーマットの検証は、外部の検証器で判定する(Label Studio)
- 審査員と人間の一致率を測る:人手で採点したセッションと突き合わせ、一致率が75〜90%に届いてから本番データに適用する(同上)
Skill Doctor が改善案を差分として出し、適用を人間に委ねる設計は、この偏りへの最後の防波堤として機能する。
自分の環境で始める手順
最小構成は、Skill Doctor を1回走らせて差分を読むことである。ファクトリー全体を組む必要はない。
- スキルを導入する(SkillsCat レジストリ経由):
npx skillscat add warpdotdev/common-skills/skill-doctor - エージェント上で
/skill-doctorを実行する。既定(--harness auto)で、手元にある Claude Code・Codex・Warp の会話ログをすべて走査する - 出力されたレポートで、効率スコアの低いセッションを確認する。ポート競合や古い手順のような環境起因の回り道は、ここで初めて見える
- 改善案の差分を読み、妥当なものだけを実際のスキルファイルへ手で反映する
- 効果が確認できたら、同じ処理を Cron などで定期実行し、改善案をプルリクエストとして受け取る運用に移す
会話ログにはソースコードや社内情報が含まれる。Skill Doctor はログをローカルで処理する設計だが、自社のポリシー上ログを外部モデルに渡してよいかは、実行前に確認しておく。
まとめ
エージェントの品質管理は、成果物の検査から過程の検査へ移る。要点は3つである。
- 最終報告は過程を語らない。会話履歴・ツールコール・差分を集めて初めて、隠れた試行錯誤が見える
- 正誤ではなく作業の質(効率・冗長性・過剰テスト)を測るルーブリックで採点し、修正をスキルに還元する
- 審査員LLMも誤る。決定的に判定できるものは検証器に任せ、最終的な適用は人間が差分で判断する
参考資料
- Ben Holmes「Your AI Agent Is Hiding Its Mistakes From You」(AI Engineer, YouTube)
- Warp: Skill Doctor
- skill-doctor SKILL.md(SkillsCat)
- LLMs knowingly hide their mistakes(LessWrong)
- Gaming the Judge: Unfaithful Chain-of-Thought Can Undermine Agent Evaluation(arXiv)
- Inducing Reward-Free Judging Rubrics that Reduce Over-Crediting in Agent Evaluation(arXiv)
- How to use LLM-as-judge for agent evaluation(Label Studio)
- LLM-as-a-judge(Prefactor)