AIを吸収する制度はニューラルネットの形をとる:Evans & Weyl「In the image of their tools」
AIの便益が経済統計に現れない原因はモデルの性能不足ではなく、社会の制度がニューラルネットワークの構造と噛み合っていないことにある。James Evans(シカゴ大学、社会学・知識科学)とE. Glen Weyl(Microsoft Research)がScience誌2026年11月5日号に寄せたエッセイ「In the image of their tools」は、この不整合を解消する方法として、モデルではなく制度の側を作り替える「逆アラインメント(reverse alignment)」を提案する。
論旨は次の3点に集約できる。
- 過去の汎用技術でも、うまく機能した制度はその時代の支配的な情報処理技術と同じ構造をとっていた。
- ニューラルネットワークは「対象の表し方」「情報の統合方法」「貢献の評価方法」の3点で、従来の技術と異なる設計原理を持つ。
- 本人確認・合意形成・価値配分の3領域では、この設計原理を写した制度がすでに稼働しており、AIによる攻撃への耐性も高い。
本記事では、エッセイが前提としている経済学・機械学習・メカニズムデザインの知識を補いながら、論旨を順に追う。
AIの生産性パラドックス
米国のAIインフラ投資は、インターネットと鉄道への投資を合計した額をすでに上回っている。一方で、その技術を社会が使いこなすための制度への投資はほとんど行われていない。エッセイはこの非対称を出発点に置く。
ベンチマークは伸びるが、経済は動かない
モデルのベンチマークスコアは急伸しているが、経済全体の産出はほとんど変わっていない。MITのDaron Acemogluは論文「The Simple Macroeconomics of AI」(2024)で、AIによる全要素生産性(TFP)の押し上げを今後10年間で約0.7%と試算した。年率ではなく10年の累計で1%に届かない水準である。
TFPは、労働と資本の投入量では説明できない産出の伸びを指す。技術進歩や組織の効率化の効果はここに現れるため、AIが経済を変えているかを測る中心的な指標になる。
タスク単位の改善は合算されない
個別タスクでは大きな効果が確認されている。Brynjolfssonらのコールセンター研究では、生成AIの支援で1時間あたりの処理件数が平均14%増えた。しかしこうしたタスク単位の改善は、企業単位・経済単位の生産性の伸びに必ずしも積み上がらない。
この現象は1987年にRobert Solowが指摘した「コンピュータの時代はあらゆる場所に見えるが、生産性統計にだけは見えない」という生産性パラドックスと同じ構造をしている。Brynjolfssonらは後に、汎用技術の導入初期には業務プロセスや人材育成といった無形資産への投資が先行し、計測上の生産性が一時的に下がってから上がる「生産性Jカーブ」を示した。エッセイの立場は、このJカーブの谷を抜けるための投資の中心が、企業内の業務改革だけでなく社会制度そのものの再設計にある、というものだ。
逆アラインメントの位置づけ
通常のアラインメントは、モデルを人間の価値や目標に合わせる取り組みを指す。逆アラインメントはその反対向きで、制度・規範・技能をAIの構造に合わせて設計し直す。両者は置き換えではなく補完の関係にある。モデルは人間の目標に仕えるべきであり、その目標を定めるのは人間の制度だからだ。
エッセイはさらに踏み込み、AIを価値に合わせるための民主的な仕組みそのものが、AIが生成する偽の有権者や、複雑な価値を指定しきれない問題によって機能しなくなるおそれを指摘する。AIの便益と安全な利用の両方を制約しているのは、もはやモデルの改良ではなく制度の再設計である。
技術と制度は同じ形をとる
エッセイの中心仮説は、新しい技術を調整する制度は、その時代の情報処理基盤と同じ構造を持つほど高い成果を出す、というものだ。比較の軸は3つある。
- 表現:対象をどう識別し、記述するか
- 統合:複数の情報をどう組み合わせて判断するか
- 貢献度評価:成果に対して誰の寄与をどう認めるか
大量生産時代とインターネット時代
| 時代 | 支配的な情報処理技術 | 構造が一致した制度 |
|---|---|---|
| 大量生産 | 組立ライン、帳簿、統計集計による中央集権的な計算 | 米連邦準備制度(1913)、ブレトンウッズ体制(1944)、事業部制企業 |
| インターネット | パケット交換、階層化されたプロトコルスタック | IETF、RFCプロセス、SWIFT、ICANN、インドのデジタルID・決済基盤 |
大量生産時代の制度は階層的・標準化・事業部型で、情報を中央に集めて集計する組立ラインと帳簿の論理を再現している。事業部制はAlfred Chandlerが分析したDuPontやGMの1920年代の組織改革に由来し、本社が各事業部の数字を集約して資源を配分する。
インターネット時代の制度は階層化・相互運用・協調型である。RFC(Request for Comments)は1969年に始まった、合意を文書の積み重ねで形成するプロセスで、分散したパケット交換の思想そのものを手続きにしている。インドの「India Stack」は、デジタルID(Aadhaar)、統合決済インターフェース(UPI)などを層として重ね、民間事業者が上位層を自由に実装できる構造を持つ。
構造が一致しなかったときに起きたこと
不一致の例も示されている。戦間期の金本位制をめぐる場当たり的な通貨運営は、統合された工業経済を安定させられなかった。
より具体的なのが工場の電化である。経済史家Paul Davidの研究(1990)によれば、電動機の導入後も工場は数十年にわたって蒸気機関時代のレイアウトを維持した。1本の主軸から全機械に動力を分配する「グループ駆動」のまま電動機を据え付けたため、生産性はほとんど上がらなかった。機械ごとに小型モーターを置く「ユニット駆動」へ工場を設計し直したとき、初めて生産性が伸びた。発電そのものは送電網へ集中化していく一方で、工場内の動力は分散化した。技術の構造に合わせて組織を組み替えるまで、効果は現れなかったということだ。
一致は必要条件であり、十分条件ではない
このヒューリスティックが対象とするのは新しい基盤を調整する制度であり、すべての制度ではない。産業時代に世界政府が生まれると予測するものではない。
また技術そのものに力がなければ、構造を写しても成果は出ない。分散型自律組織(DAO)はブロックチェーンの構造を忠実に写したが、ブロックチェーンが世代を代表する技術にならなかったため、DAOも大きな成果を残さなかった。
ニューラルネットワークの3つの設計原理
ニューラルネットワークは、先の3つの軸すべてで従来の技術と異なる設計を持つ。エッセイはこれを新しい「建築文法」と呼び、AIを吸収できる制度はこの文法を社会の規模で実装しなければならないと主張する。
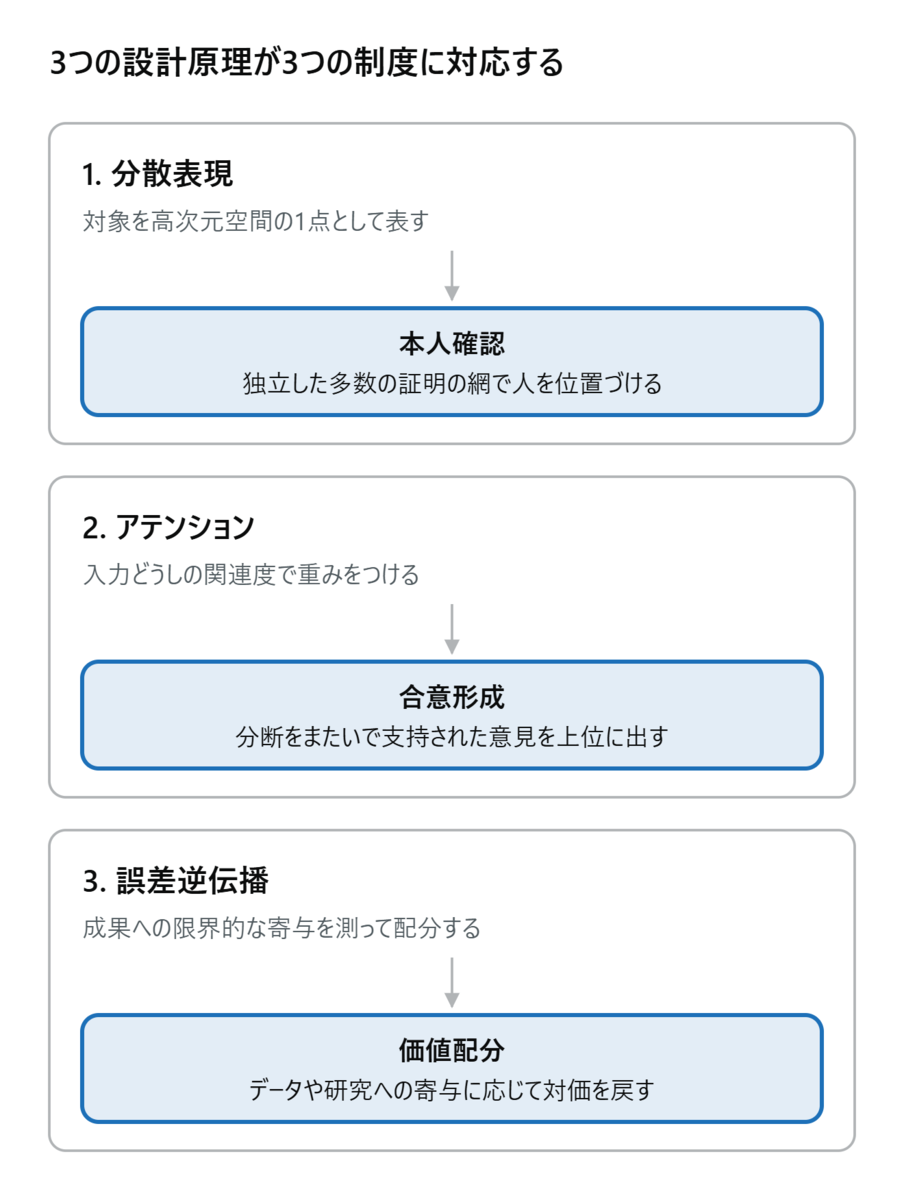
各原理の上段が工学上の仕組み、下段がそれを写した制度の領域である。
1. 分散表現(表現の軸)
従来のデータベースは、対象を属性の組で識別する。人であれば氏名・生年月日・学位・ID番号といった列の値で表す。分散表現では、対象は高次元のベクトル空間(埋め込み空間)上の1点として表される。各次元は人間が名前をつけられる属性に対応せず、元の特徴から何層もの非線形変換を経て得られる。ある1つの次元が欠けたり偽造されたりしても、対象の位置は他の多数の次元によって決まる。
2. アテンションによる橋渡し(統合の軸)
Transformerのアテンションは、各入力が他のすべての入力に対してどれだけ関連するかを重みとして計算し、その重みで情報を混ぜ合わせる。
\[ \mathrm{Attention}(Q, K, V) = \mathrm{softmax}\left(\frac{QK^{\top}}{\sqrt{d_k}}\right) V \]
単純な集計(平均や多数決)は、集団の意見を1つの値に平らにする。アテンションは入力どうしの関係を保ったまま、多様な入力が共有する部分を増幅し、それぞれの違いは保存する。エッセイの言い方では、集計は群衆を平均化し、アテンションは群衆の中の部分集団を互いに結びつける。
3. 誤差逆伝播による貢献度評価(評価の軸)
学習では、出力の誤差(損失)から各パラメータへ勾配を逆向きに伝え、損失への限界的な影響に比例して各パラメータを更新する。
\[ \theta \leftarrow \theta - \eta \frac{\partial L}{\partial \theta} \]
これは「結果に対して、どの要素がどれだけ寄与したか」を繰り返し測定し、その寄与に応じて報酬(更新量)を割り当てる仕組みである。機械学習ではこれを信用割当問題(credit assignment problem)と呼ぶ。
これは比喩ではない
エッセイは、この対応を比喩ではなく形式的な類似として扱う。AIが社会にもたらす調整問題は、ニューラルネットワークが解くために作られた問題と形式的に近い。だから工学の基盤で機能した設計は、制度の基盤でも機能する可能性が高い。ブレトンウッズ体制が1944年当時の会計・集計技術に合っていたのと同じ理屈である。逆に、単一の責任点、集計による意思決定、階層型組織といった古い文法の制度は、新しい文法の制度に劣ると予測される。
AIの脅威は不整合から生じる
エッセイは、AIの脅威の多くがこの不整合の結果だと見る。
| 軸 | 旧来の制度の前提 | AIが壊すもの |
|---|---|---|
| 表現 | 少数の資格情報(学位、社会保障番号)で人を識別 | 偽造が安価になり、技能の組み替えも速くなる |
| 統合 | 投票や市場による線形の集計 | エージェントの大量複製と視点の均質化 |
| 貢献度評価 | 論文やアルバムなど離散的な成果単位 | AIが複製でき、学習にも役立たない単位になる |
以下の3節は、それぞれの軸でどの制度がすでに新しい文法を実装しているかを見る。
本人確認:分散表現としての検証
文書・生体情報・人格の偽造コストがゼロに近づくと、単一の検証済み属性に依存する信頼の仕組みはすぐに破られる。マスターキー1本で守られた扉は、その鍵が複製されれば終わりである。
分散表現に対応する設計は、人を1本の鍵の背後に置くのではなく、多数の証明(アテステーション)の網の中に位置づけることだ。構成要素は2つある。
- パーソンフッド・クレデンシャル(personhood credentials):その人が固有の人間であることだけを証明し、それ以上の情報は開示しない。2024年にOpenAI、Microsoft、MITなどの研究者が共同で提案した概念で、ゼロ知識証明などの暗号技術を前提とする。
- 検証可能なクレデンシャル(Verifiable Credentials):W3Cが標準化したデジタル証明書の形式。発行者が署名した属性を、本人が必要な場面で提示できる。本人またはその代理エージェントが、社会的にも技術的にも互いに独立した複数のコミュニティへの所属を証明できる。
独立した複数の証明元を組み合わせることは、事実上、多要素認証を多層に重ねることに等しい。1つの証明元が侵害されても、人の「位置」は他の証明によって決まる。これは分散表現の頑健性そのものである。
資格の中身も豊かになる
この設計は安全性だけでなく、資格の実質的な価値にも効く。学位は学習者を1本の直線的な経歴に圧縮する。雇用側が求める役割横断の柔軟性を表せず、典型的でない才能を取りこぼす。
マイクロクレデンシャルは、人が持つ異質な能力の組み合わせを記録できる。こうした豊かな表現は以前は読み解くコストが高すぎたが、AIはそれを読める形にする。
エージェントにも同じ基盤が使える
AIエージェントも人と同様に関係の中に置かれる存在である。同じ証明の基盤を延長すれば、エージェント間の協働や取引での認証にもそのまま使える。
合意形成:アテンションとしてのブリッジング
多数決は数を数え、アテンションは関係に重みをつける。この違いを社会の意思決定に持ち込んだ仕組みが、すでに大規模に稼働している。共通する手順は、参加者を意見の潜在空間に埋め込み、その空間が示す分断をまたいで支持を集めた意見を上位に出すことだ。票の多さでは順位を決めない。この方式をブリッジング(bridging)と呼ぶ。
Polis
Polisは台湾の公共協議「vTaiwan」で使われてきたオープンソースの意見集約ツールである。参加者は短い意見文に賛成・反対・保留で投票する。システムは「参加者×意見」の投票行列を主成分分析で2次元に落とし、クラスタリングで意見グループを見つける。そのうえで、特定のグループだけでなく、すべてのグループから一定以上の賛成を得た意見を「合意点」として示す。台湾ではUberの規制などの議論にこの方式が使われた。
X(旧Twitter)のコミュニティノート
コミュニティノートは、投稿に付く補足説明のうち、どれを表示するかを行列分解で決める。各評価を次のようにモデル化する。
\[ r_{un} = \mu + i_u + i_n + f_u \cdot f_n \]
ここで r は利用者 u がノート n につけた評価、f_u と f_n は利用者とノートの「立場」を表す潜在ベクトル、i_n はノート固有の切片である。立場の一致で説明できる評価は f_u・f_n の項に吸収されるため、i_n が高いノートは「立場の異なる利用者からも等しく支持されたノート」になる。表示の判定にはこの i_n を使う。
エッセイによれば、ノートが表示されると誤解を招く投稿の再投稿は約61%減る。ただしノートが付くのは多くの場合、投稿の拡散がほぼ終わった後である。この方式はMeta、TikTok、YouTubeにも採用された。
政治への展開
同じ方式は大衆政治にも広がっている。エッセイは日本の新興政党チームみらい、カリフォルニア州とフィンランドの市民参加プラットフォームを例に挙げる。チームみらいは「デジタル民主主義」を党是とし、2026年2月の衆院選で11議席を獲得した。党首の安野貴博氏は、このエッセイの基になった共同声明の共著者でもある。
AIの進歩によって、ブリッジングを実行できる速度・細かさ・粒度は急速に上がっている。プラットフォームがそれを前面に出す設計になっていれば、ブリッジングは拡散(バイラリティ)より先に走れるようになる。
価値配分:誤差逆伝播としての貢献度評価
生成モデルは数百万人の人間の成果物の上に成り立っているが、データの作り手にはほとんど対価が戻らない。その結果、次のモデルが必要とする人間のデータを生み出す動機が弱まる。エッセイは、ここに信用割当の仕組みをそのまま制度として持ち込むことを提案する。
データ帰属・来歴・集中管理
構成要素は3つある。
- 帰属推定(attribution):各データ源がモデルの性能に与えた限界的な効果を推定する。機械学習では影響関数(influence functions)や、協力ゲーム理論のシャープレイ値を応用したData Shapleyなどの手法が研究されている。
- 来歴(provenance)の標準:データ源が本物であることを認証する。コンテンツの作成・編集履歴に署名を付けるC2PAのような規格がこれにあたる。
- 集中管理団体:音楽著作権の管理団体をモデルに、大規模に利用条件を交渉し、測定された貢献度に応じて対価を分配する。
科学の評価を「驚き」で測る
同じ原理は研究評価にも適用できる。学習では、モデルを最も驚かせる例、つまり予測が大きく外れて損失の大きい例が、最も大きな勾配を生み、最も多くの学習信号を運ぶ。科学も同様に、引用数や掲載誌ではなく、その発見がどれだけ驚きをもたらし、分野の信念をどれだけ変えたかで評価すべきだ、というのがエッセイの主張である。
この必要性は差し迫っている。AIを使う研究者は個人としてはより多様な先行研究を参照するようになったが、分野全体の注目はかえって一部に集中している。AI支援で生み出される論文の量は、査読が仕分けできる能力をすでに超えている。
二次資金調達とディープファンディング
驚きに重みをつけた評価を資金配分に直接実装する仕組みとして、エッセイは二次資金調達(quadratic funding)とディープファンディング(deep funding)を挙げる。
二次資金調達は、Buterin・Hitzig・Weylが2018年に提案したメカニズムで、プロジェクト p への配分額を個々の寄付額 c_i の平方根の和の2乗で決める。
\[ F_p = \left( \sum_{i} \sqrt{c_{i,p}} \right)^2 \]
100人が1ずつ出したプロジェクトは (100 × √1)² = 10,000 の配分を受け、1人が100出したプロジェクトは (√100)² = 100 にとどまる。金額の大きさより支持者の広さを評価する仕組みで、差額はマッチング資金から補う。オープンソース開発の助成プラットフォームGitcoinで実運用されてきた。
ディープファンディングは、ソフトウェアの依存関係グラフ上で各ノードの重みを推定し、上流の基盤への貢献を資金配分に反映させる仕組みである。協働や依存関係のグラフの上でこれらを動かせば、引用数には現れないデータセット、ソフトウェア、指導といった、分野を更新し続ける能力の伝達にも対価を与えられる。
最初の試験場としての科学
エッセイは、逆アラインメントを最初に試す場として科学を挙げる。
米大統領科学顧問Michael Kratsiosの報告書「Science: a New Golden Age」は、科学行政へのAIの導入と、研究資金の新しい配分方法を求めている。この報告書は基礎研究予算の大幅削減案と同時に出たため、科学者の一部は警戒している。それでもエッセイは、これを科学界が厳密さをもって応えられる課題だと位置づける。
具体的な提案は2つある。
- 従来の査読と並行して、驚きに重みをつけた配分と協働グラフに基づく配分を走らせる。 AIが認証した科学的新規性の明確な証拠を出せれば、AIを科学の中心に据えたい側も否定しにくい。
- 来歴と帰属を研究インフラとして資金化・標準化する。 モデルの学習側は、合成データの増殖や推論時の再帰によって性能が劣化する「モデル崩壊」のリスクに直面している。人間の科学者が生んだ主張の来歴が保証されていれば、学習側にとって価値のあるデータになる。
この仕組みは、近年のAI主導の大規模な数学的・科学的成果をめぐる学界の不安を和らげる効果も持つ。誰の何がその成果に寄与したかを測れるようになるからである。
防御としての制度設計と、可読性という制約
成長と防御は同じ設計から得られる
これらの設計は、成長だけでなく防御にも効く。
| 制度 | 旧来の設計の弱点 | 新しい設計が防ぐ攻撃 |
|---|---|---|
| 銀行の取引相手確認 | パスワード1つに依存 | エージェント群による資金の抜き取り |
| プラットフォームの意見表示 | 票数の集計 | 作られた合意による氾濫(立場が同じ意見は1つのノードに畳まれる) |
| 科学の評価 | 論文数・引用数 | 合成された成果物の大量投入(驚きをほとんど生まない) |
検証によって取引が遅くなるなど、安全と生産性が衝突する場面もある。構造が一致した制度であれば、その取引条件をモデルの所有者に委ねず、公衆が公開の場で比較衡量できる。
先回りできる初めての技術革命
過去の技術革命と違い、AI時代に入りつつあることには社会的な合意がすでにある。これまでの制度設計は問題が起きてから反応するしかなかったが、今回は先回りできる機会がある。
複雑さと可読性の両立
一方で、逆アラインメントには根本的な制約がある。制度はニューラルネットワークの原理を実装しながら、そこで暮らす人間にとって正統で、扱える形であり続けなければならない。
ニューラルネットワークの予測力は、対象を高密度・高次元の潜在空間に埋め込むことから生まれる。その空間ではカテゴリは流動的で、創発的で、人間には解釈できないことが多い。しかし人間は、制度の正統性を認めるために可読性(legibility)を求める。自分自身の豊かな複雑さを反映した社会構造であっても、読めなければ受け入れない。
制度の複雑さと人間にとっての可読性を橋渡しすることが、この時代の政策課題の中心である。AIの構造を吸収できる制度を意図的に設計しなければ、生産性パラドックスは固定化し、不整合が招く害に社会がさらされ、技術の可能性は実現されないまま終わる。エッセイは、逆アラインメントを理論上の議論ではなく、AIによる繁栄の前提条件だと結論づけている。
参考文献
- James A. Evans, E. Glen Weyl, “In the image of their tools”, Science, Vol. 394, Issue 6824, 2026年11月5日. DOI: 10.1126/science.aem6470
- Daron Acemoglu, “The Simple Macroeconomics of AI”, 2024.
- Erik Brynjolfsson, Danielle Li, Lindsey Raymond, “Generative AI at Work”, 2023.
- Erik Brynjolfsson, Daniel Rock, Chad Syverson, “The Productivity J-Curve”, American Economic Journal: Macroeconomics, 2021.
- Paul A. David, “The Dynamo and the Computer”, American Economic Review, 1990.
- Steven Adler ほか, “Personhood credentials”, 2024.
- Vitalik Buterin, Zoë Hitzig, E. Glen Weyl, “A Flexible Design for Funding Public Goods”, Management Science, 2019(2018年プレプリント).
- Ilia Shumailov ほか, “AI models collapse when trained on recursively generated data”, Nature, 2024.
- 共同通信「みらい、統一選候補者の擁立限定 初の党大会、足場固め重視」2026年7月18日. 熊本日日新聞掲載