AIで個人は100倍速くなるのに、なぜ企業は速くならないのか
Basis共同創業者のMitchell Troyanovsky氏は、企業の生産性が個人ほど伸びない原因はコーディング型エージェントの渡し方にあると主張しています。使いこなす負担と仕事の進め方の決定を個々の利用者に委ねるため、組織の規模拡大の仕組みと噛み合わないという分析です。同氏の解決策は「エージェントにこだわりを持たせ、結果だけでなく過程を評価する」ことです。
講演の概要
本記事は、AI Engineer NYC 2026(2026年10月14日)の約19分の講演を、公開された書き起こしとスライドから整理したものです。動画はYouTubeで「Why AI Makes You 100x Faster but Not Your Company」として公開されています。会場での題は「Process Supervision for Agents That Do Long-Horizon Work」です。
Troyanovsky氏は講演で、自身の生産性が「おそらく100倍」になったと述べています。この100倍は本人の実感であり、計測値ではありません。講演は企業全体の生産性データも示しておらず、以下の分析は会計エージェントを販売する当事者の見解です。
Basisは会計事務所向けのAIエージェントを開発する企業で、2023年に創業しました。同社のエージェントは、納税申告書の作成や月次決算といった業務を数時間かけて自律的に進めます。Cursorの導入事例では、人間が30〜40時間かかるパートナーシップ申告書(Form 1065)を6〜7時間で完成させると紹介されています。この数字は測定条件が公開されていない事例記事の値です。
企業が速くならない理由
企業は従業員の非決定性を、決定的なシステムではなくプロセスで吸収しています。Basis社内には「人はすでに非決定的なシステムと働いている。ただ、その相手がコンピュータではなく同僚だっただけだ」という趣旨の言葉があります。
会計事務所のトップは、現場の担当者が日々どう作業しているかを細部まで把握していません。それでも成果物を信頼できるのは、良い結果につながるプロセスが定められ、担当者がそれに従うと見込めるからです。プロセスは細かな作業にも及びます。現金の照合に必要な銀行データの抽出でも、承認済みソフトを使うという決まりがあり、担当者が検索で見つけた任意のツールに機密文書を渡すことは許されません。
利用者に汎用エージェントを渡して「好きに使ってください」とする製品は、この構造と衝突します。ギャップは2つあります。
- コンピテンシーギャップ:スキルやメモリの管理、エージェントを使う場面の判断、エージェントの挙動の予測が利用者の仕事になります。同氏は、大半のナレッジワーカーにはこの負担を担えないと述べています。
- プロセスギャップ:仕事の進め方が利用者ごとのカスタマイズで決まります。プロセスは本来、経営層から現場へ定めるものであり、個々の従業員が決めるものではありません。
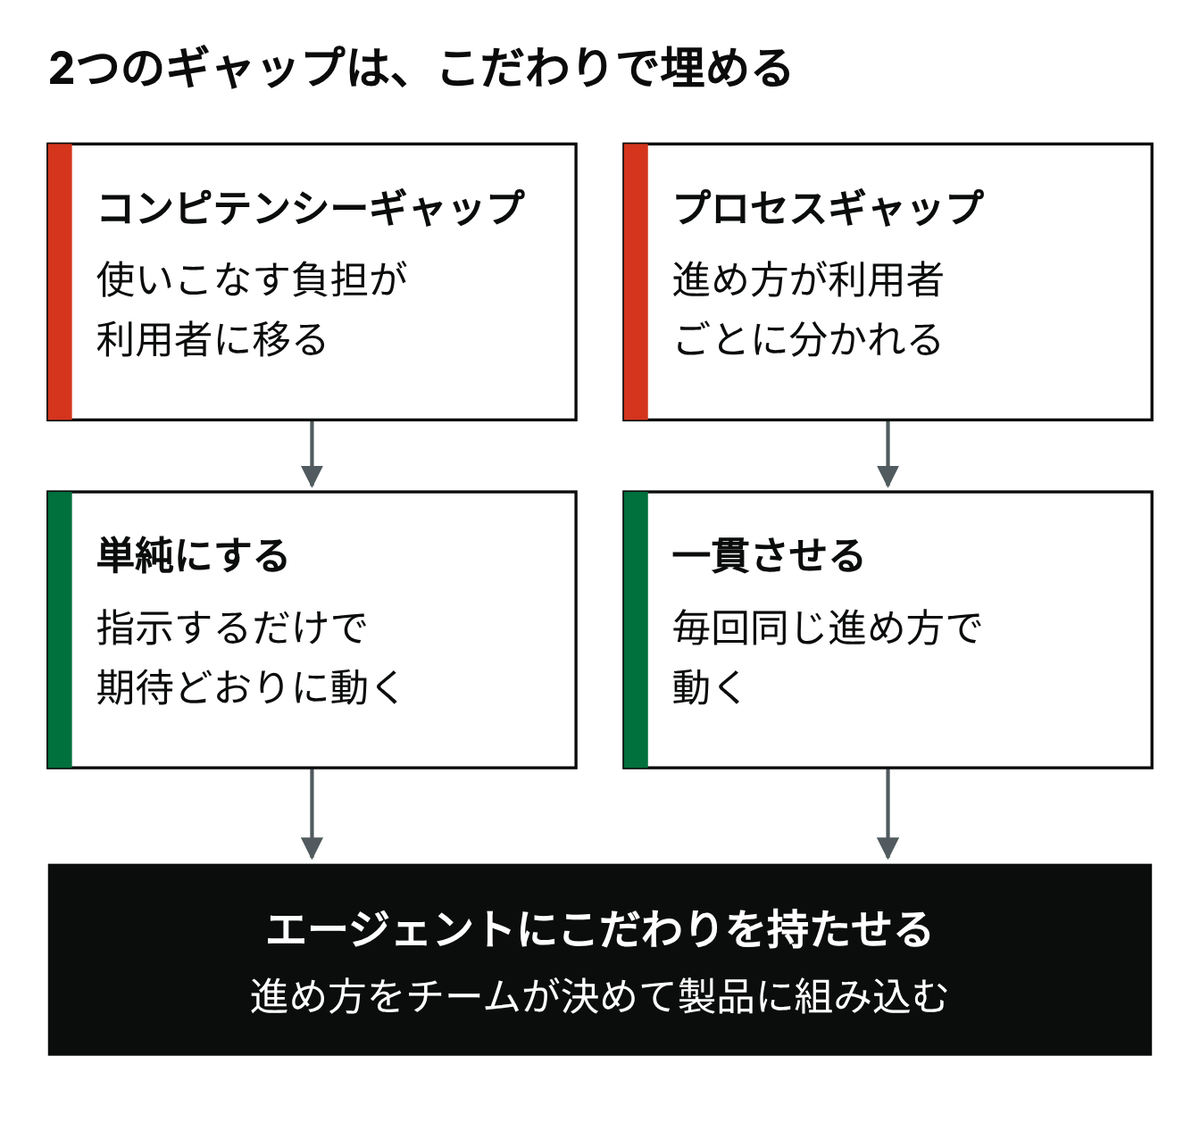
求められるのは完璧さではなく一貫性です。ある日は見事な成果を出し、翌日に基本的な確認を忘れるエージェントは、仕事を任せる判断ができません。できないことがあっても、一貫してできないのであれば、利用者はそれを前提に業務を組めます。
こだわりとは何か
こだわり(opinion)とは、無数にある実行方法から、チームが意図して選んだ1つの進め方です。Troyanovsky氏はPDFの読み取りを例に挙げています。
- ビジョン言語モデル(VLM)に画像として渡す
- Pythonでオープンソースのライブラリを使ってOCRする
- OCR専門のモデル提供事業者を使う
- OCRの結果をVLMに検算させる(1回、5回、100回と増やせる)
「PDFを抽出して」とだけ指示しても良い結果は出ますが、信頼性は得られません。実行された手順が悪いからではなく、手順が定まっていないからです。
こだわりの一部は、評価実験を待たずに領域の知識から決められます。
- 税務調査:回答の前に一次資料を読めば、正確になる可能性が高まります。
- スライド作成:返却の前に画像へ描画して確認すれば、書式の崩れが減ります。
こだわりは正確さだけの問題ではありません。スライドの描画確認は応答時間を延ばします。書式の崩れが100回に1回で許容できるなら、確認を省く判断も正当です。重要なのは特定の答えではなく、遅延・コスト・モデルの能力・許容できる誤りを踏まえて選択を明示し、毎回同じように実行させることです。
結果評価だけでは足りない理由
正解データと照合する結果評価(outcome-based eval)は今も必要ですが、長時間動くエージェントでは3つの限界があります。
- 網羅できない:評価セットは100〜1,000件でも、本番で現れる状況は数十万通りに及びます。エージェントの稼働が長くなるほど、判断の組み合わせは増え続けます。
- 原因が分からない:5時間の実行に推論が1,000回含まれる場合、最終結果の不合格だけでは、どの判断が問題だったのかを特定できません。
- 良い結果が良い手順を保証しない:Braintrustの解説は、Schedule K-1付きのForm 1040を例に挙げています。申告書が正しくても、適切なOCRを使ったのか、一次資料に基づいて判断したのかは結果からは分かりません。
ここで補う手段がプロセス監督(process supervision)です。すべての実行に正解を用意することはできなくても、チームが定めた振る舞いが実行履歴に現れているかは確認できます。正解データのない本番の実行も対象にできるため、結果評価よりはるかに多くの信号を集められます。ただし、振る舞いに従っていれば結果が保証されるわけではなく、本番へ一般化しやすいと推定できるにとどまります。
近い考え方の研究があります。OpenAIの2023年の研究は、数学の問題を解くモデルの学習で、手順単位の監督が結果単位の監督を上回ると報告しました。正答率はMATHのテスト問題で78.2%と72.4%(1,860候補から選択)、学習範囲外のSTEM問題で72.9%と63.8%(100候補から選択)です。
一方、DeepMindのUesatoらの2022年の研究では、最終回答の誤り率は両者で同程度でした。ただし、正しい推論過程を得るには手順単位のフィードバックが必要だとしています。OpenAIは、この違いを監督データの規模の差で説明しています。
どちらも短い数学の解答を学習時に評価した研究であり、長時間のエージェントの実行履歴を事後に判定する効果を直接示すものではありません。Braintrustの解説によれば、その後は数学の答えやソフトウェアのテストのように検証可能な報酬で学習する手法が伸び、プロセス監督の公開研究は減速しました。
エージェントが会計のような検証の難しい長時間の仕事を担うようになり、プロセス監督の重要性が再び高まっています。現在の実行は2023年の数学の問題に比べて計算量が4〜5桁大きく、ツール呼び出しと要約された推論の記録だけでも、手順を判定する証拠として十分です。
帳尻が合っても失敗する例
講演の中心となる例は、銀行勘定の照合です。スライドでは銀行残高が48,210.55ドル、帳簿残高が47,798.49ドルで、412.06ドルの差額があります。望ましい振る舞いは、差額を調べて証拠とともに説明することであり、根拠のない調整仕訳(プラグ)で帳尻を合わせることではありません。
失敗する実行は次のように進みます。エージェントは帳簿で412.06ドルを検索して何も見つけられず、銀行明細を再確認しないまま同額の調整仕訳を計上します。照合ツールの check_reconciliation は合格を返し、エージェントは差異0.00ドルと報告します。スライドの例では、実際の原因はスキャン文書のOCRが1行を読み違えたことでした。残高は一致しますが、チームの定めた振る舞いには違反しています。
プラグを許容する運用もあり得ます。Troyanovsky氏が問題にするのは、同じ顧客がある時は差額の説明を受け、別の時はプラグを受け取るという不一致です。
システムプロンプトに書くだけでは直らない
この振る舞いは、システムプロンプトに2文足すだけでは定着しません。大規模なエージェントの挙動は、システムプロンプト、段階的に開示される指示、ツールの説明、モデルの学習結果が組み合わさって決まるからです。
そこでTroyanovsky氏は、コンテキストを「実行時の学習データ」として捉えることを勧めています。モデルの重みが変わるわけではありませんが、エージェントは実行中に読む情報に沿って振る舞いを変えます。Basisがコンテキストをコードと同じ厳密さで読み、修正するのはこのためです。
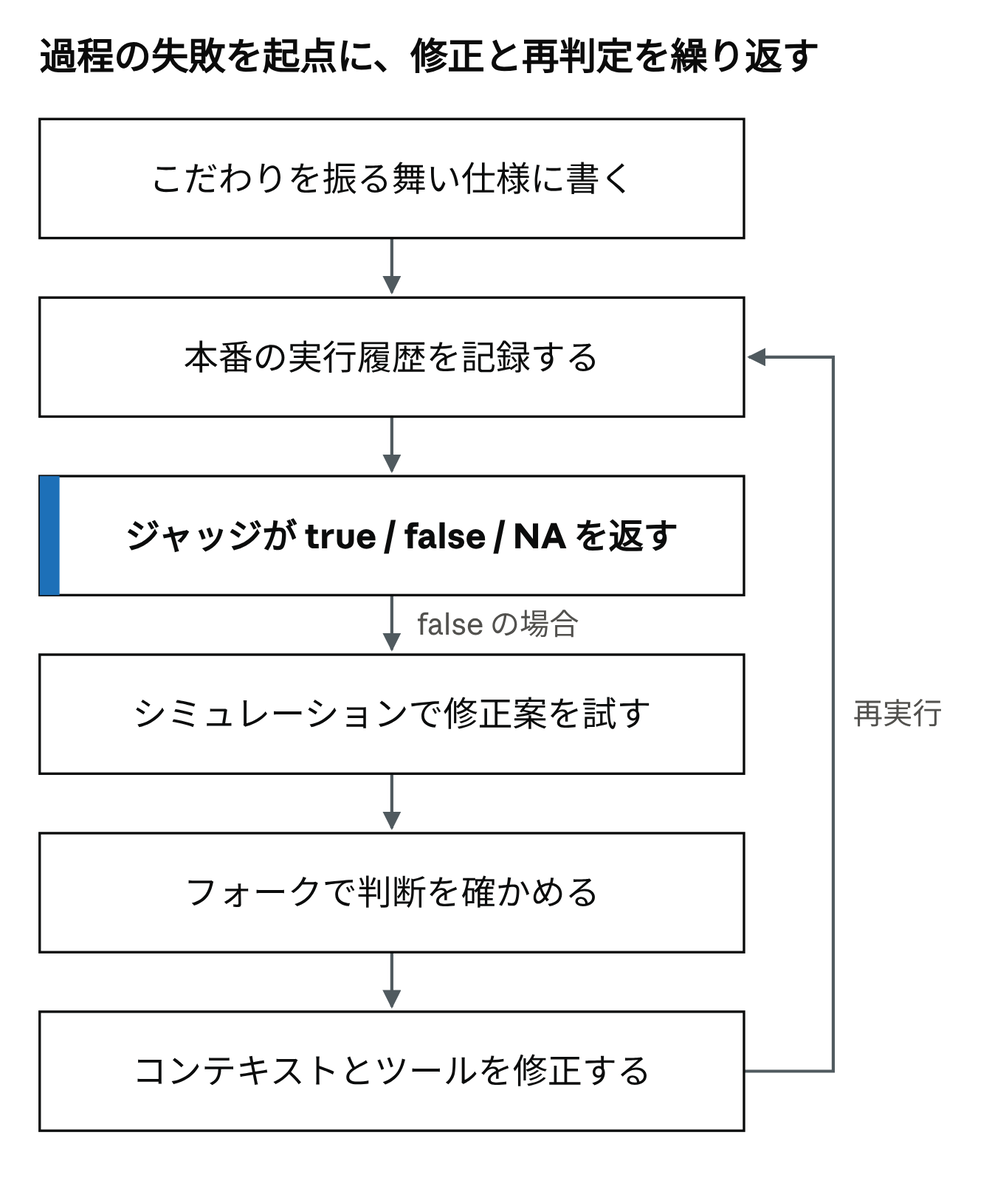
手法1:振る舞い仕様で過程を判定する
振る舞い仕様(behavior spec)は、ある状況でエージェントに期待する振る舞いを記したMarkdownファイルです。BraintrustとBasisが2026年7月にオープン標準として公開し、仕様・判定用プロンプト・作例はagentbehavior.devで提供されています。
最も重要な点は、仕様はプロンプトではなく、エージェントには見せないことです。仕様はチームの意図を合意する文書であり、記録された実行履歴を判定する基準です。エージェントが読むプロンプト、スキル、ツール説明は別に管理し、仕様を満たすまでそちらを修正します。
形式
ファイルは .agents/behaviors/<name>/BEHAVIOR.md に置きます。仕様書が定める必須項目はフロントマターの name と description で、name は親ディレクトリ名と一致させます。本文は自由形式で、Braintrustの解説は次の6つのラベルを任意の構成として示しています。
| ラベル | 書く内容 |
|---|---|
| Intent | なぜ重要か、いつ適用するか |
| Evidence | 判断の前に確認すべき情報 |
| Decision | 何を判断するか |
| Execution | 判断の後に何をするか |
| Recovery | うまくいかない時や情報が足りない時の対応 |
| Failure modes | 防ぎたい失敗 |
講演の銀行勘定の例をこの形式で書くと、次のようになります(公式の例ではなく、本記事の作例です)。
---
name: explain-reconciliation-difference
description: 銀行勘定の差額を、根拠のない調整仕訳で消さずに説明する
---

## 差額を証拠とともに説明する

**Intent:** 顧客が受け取る照合結果の扱いを毎回そろえる。
差額のある照合に適用する。銀行手数料など、根拠のある項目で
説明済みの差額には適用しない。

**Evidence:** 銀行取引明細の原本と帳簿の該当明細を確認する。

**Decision:** 差額の原因を明細の根拠とともに特定できたかを判断する。

**Execution:** 特定できた場合は、原因と根拠を示して報告する。

**Recovery:** 特定できない場合は、未解決の差額として明示し、
レビュー担当者に判断を求める。

**Failure modes:** 根拠のない調整仕訳を計上する。
銀行明細を再確認しない。原因不明のまま差異ゼロと報告する。
判定
ジャッジはモデルで実装し、仕様と実行履歴を読ませて2つの問いに答えさせます。振る舞いが関係する状況は発生したか。発生したなら、その振る舞いに従ったか。Braintrustの解説では、判定結果を true、false、NA の3値で表します。上の作例に当てはめると次のとおりです。
| 実行の内容 | 判定 |
|---|---|
| 差額がなかった、または差額が根拠のある項目で説明済みだった | NA |
| 差額の原因を明細から特定し、根拠を添えて報告した | true |
| 原因を特定できないまま調整仕訳を計上し、差異ゼロと報告した | false |
NAを設けることで、状況が発生しなかった実行を「従った」と数える誤りを防げます。また、最後のfalseはタスク全体の正解データがなくても判定できます。
運用ルール
- 仕様にする振る舞いを絞る:対象は、繰り返し発生する選択で、実行履歴から判定でき、継続して評価する価値があるものです。本番のエージェントには数百の振る舞いが埋め込まれており、すべてを書くと維持できません。
- 仕様を正とする:仕様とコンテキストが矛盾したら、実装を直します。
- 役目を終えた仕様は廃止する:モデルが追加の指示なしで確実に実行するようになったら、仕様を削除します。
- こだわり自体の良否は別に検証する:判定で分かるのは従ったかどうかであり、そのこだわりが正しいかどうかではありません。
判定は本番の実行全体に対して走らせるため、継続的な処理基盤と費用が必要です。導入の際は、この判定コストも見積もる必要があります。
手法2:フォークで判断を切り分ける
フォーク(forking)は、実行履歴の特定の時点の状態を複製し、そこから分岐して検証する手法です。振る舞い仕様の判定がfalseになった実行を、問題の判断の前後で開き直します。分岐する位置で調べられることが変わります。
- 判断の直前で分岐:コンテキストを変更して再実行し、振る舞いが改善するかを確かめます。
- 判断の直後で分岐:エージェントにその判断の理由を尋ねます。ただし、エージェントの説明は手がかりであり、原因の証明にはなりません。
講演のスライドは、412.06ドルの扱いを決める直前の保存点から、3つの修正を各5回分岐させて比べています。
| 修正の対象 | 変更の内容 | 振る舞いに従ったか |
|---|---|---|
| 月次決算スキル | 調整仕訳は根拠で説明できる差額に限る | 従う場合と従わない場合がある |
| システムプロンプト | 「照合を無理に一致させない」を追加 | 従う場合と従わない場合がある |
レビューツール check_reconciliation |
差額が根拠つきで説明されるか、レビュー担当者に報告されていれば合格にする | 従う(副作用なし) |
スライドの結論は、直すべき対象はプロンプトではなくツールだったというものです。一致しない結果をすべて不合格にするツールが「一致させろ」という信号を出し続ける限り、プロンプトで「説明しろ」と書いてもエージェントは矛盾した動機を抱えます。この結果は各5回の説明用の例であり、一般的な成功率を示すものではありません。
ローカルのコーディングエージェントでフォークは簡単ですが、クラウドの本番環境ではデータベース、プロンプト、ツールなどの環境一式を再現する必要があります。Basisも内製の基盤を構築しています。
手法3:シミュレーションで安く試す
シミュレーションは、コーディングエージェントにサブエージェントを作らせ、本番エージェントの代役をさせる手法です。Troyanovsky氏が最も気に入っている手法で、基盤を作らずに今日から実行できます。
- 本番と同じシステムプロンプトとスキルをサブエージェントに渡す
- ずるをしないよう指示し、本番と同じ制約を守らせる
- 評価や本番で問題になった状況を与え、何をするかを尋ねる
- 問題の振る舞いが再現したら、コンテキストを変更して挙動の変化を見る
再現の忠実度はフォークに大きく劣ります。それでも、はるかに安く速いため、修正案を次々に試せます。同氏は社内にフォーク機能を作るまでの1年半以上、この方法を使っていました。
3つの手法のつなぎ方
3つの手法は、結果評価に代わるものではなく、結果評価が示さない「何を直すか」を補うものです。こだわりを明文化して初めて信号が得られ、その信号が自己改善するエージェントへのループを閉じます。
| 手法 | 答える問い | 適用できる範囲 | コスト |
|---|---|---|---|
| 結果評価 | 最終成果物は正しいか | 正解のある事例のみ | 全行程の実行が必要で高い |
| 振る舞い仕様 | 定めた振る舞いに従ったか | 本番の実行にも適用可 | 判定を継続的に実行する費用 |
| シミュレーション | この修正案で振る舞いは変わりそうか | 再現できた状況のみ、忠実度は低い | 低い |
| フォーク | この判断はどの変更で変わるか | 記録した実行の任意の時点、忠実度は高い | 環境再現の基盤が必要で高い |
信頼はレビューの濃さとして現れる
一貫して動くエージェントは、適用範囲を段階的に広げられます。Troyanovsky氏は同僚のプルリクエスト(PR)のレビューを引き、人が2つの軸でレビューの濃さを決めていると指摘します。
- 影響範囲:変更はどこまで波及するか
- 作成者の能力の評価:その人をどの程度信頼しているか
能力に不安のある相手がコアサービスを変更するPRは丁寧に読み、信頼する相手が社内文書を直すPRは軽く確認します。エージェントの成果物も同じです。狭い業務から始めて一貫性を確認し、影響の大きい業務へ広げていきます。一貫性がなければ、どこまで任せてよいかを調整できません。
「37手目」への反論
自由に動かせばエージェントが人の思いつかない解法を見つけるのではないか、という反論があります。2016年のAlphaGo対イ・セドル戦第2局の37手目のような独創です。
Troyanovsky氏は、その可能性を認めたうえで、独創は生産量を拡大する方法ではないと答えます。納税申告書に求められるのは独創的な一手ではなく、規則と証拠に基づく確実な処理だからです。この主張は定型性の高い業務を前提としています。研究開発のように予想外の解法そのものに価値がある領域では、こだわりをどこまで固定するかを別に判断する必要があります。
講演の結論は3点です。
- エージェントが普及するには、内部を意識せず使えるほど単純でなければならない。
- チームが信頼するには、一貫して動かなければならない。
- 単純さと信頼性はこだわりから生まれ、こだわりが生む信号によって本番での自己改善が可能になる。
Sources
- Why AI Makes You 100x Faster but Not Your Company(YouTube)
- Process Supervision for Agents That Do Long-Horizon Work(AI Engineer NYC 2026、書き起こしとスライド)
- Behavior specs, an open standard for supervising long-horizon agents(Braintrust)
- Behavior spec specification(braintrustdata/agentbehavior)
- How Basis builds long-horizon accounting agents with Cursor(Cursor)
- Agentic AI accounting platform Basis raises $100m Series B(FinTech Futures)
- Let’s Verify Step by Step(arXiv、OpenAI)
- Solving math word problems with process- and outcome-based feedback(arXiv、DeepMind)