誰がソフトウェアファクトリーを検証するのか:1日3万マージ時代のコードレビュー
AIエージェントによる開発の律速段階は、コード生成から検証に移った。解決策は人間のレビュー増員ではなく、機械が検証証拠を生成し、人間の承認を変更リスクに応じて配分する多層検証である。
本記事は、2026年10月14日のAI Engineer New Yorkで行われたセッション「How Anthropic Merges 30,000 Code Changes a Day」の要点を、公開資料で補って整理したものである。登壇者はSonarのManish Kapur氏(VP of Product Marketing & DevRel)とAnthropicのAddy Osmani氏(Member of Technical Staff)である。
検証がボトルネックになった
AIは書く工程を速くしたが、本番に届く変更は同じようには増えていない。登壇者は「コード生成は解決済み、検証は未解決」と位置づけた。スライドに示されたSonarの新しい調査(回答者1,026人、公開前の先行値)では、85%の組織がすでにコーディングエージェントを使っている。一方で、76%の開発者は検証できる速度を超えてAIコードを生成し、53%はコードを書くよりレビューに多くの時間を使っている。
公開調査の数字も同じ方向を示す。
| 指標 | 値 | 出典 |
|---|---|---|
| CIワークフローの平均スループット(前年比) | 59%増 | CircleCI |
| mainブランチのスループット(中央値のチーム、前年比) | 7%減 | CircleCI |
| mainブランチのワークフロー成功率 | 70.8%(推奨水準は90%) | CircleCI |
| コミットされたコードに占めるAIの割合 | 42%(2027年は65%の見込み) | Sonar |
| AIコードの機能的な正しさを完全には信頼していない開発者 | 96% | Sonar |
| コミット前に必ず確認する開発者 | 48% | Sonar |
| AIコードのレビューは人のコードより労力がかかると答えた開発者 | 38% | Sonar |
信頼していないのに確認しない。この96%と48%の差が、AWSのWerner Vogels氏が「検証負債(verification debt)」と呼ぶものの実体である。なお、CircleCIはCI、Sonarはコード検証の事業者であり、どちらの数字も自社の領域の重要性を示す立場から公表されている。CircleCIのデータは2025年9月の28日間の計測値である。
ライトファクトリーとダークファクトリー
ソフトウェアファクトリーの実態は、スコープ定義、実装、検証、出荷を回し続けるループである。両者の違いは、そのループのどこに人間が入るかにある。
| 観点 | ライトファクトリー | ダークファクトリー |
|---|---|---|
| 人間の位置 | 各工程で判断と好みを反映する | 例外時だけ呼ばれる |
| 品質の根拠 | 機械の検証と人間の判断の併用 | 仕様、シナリオ、自動検証 |
| 主な人間の仕事 | レビュー、承認、方向づけ | ファクトリー自体の設計と監視 |
動画によれば、多くのチームは両者の中間にいる。段階を測る物差しには、Dan Shapiro氏の5段階モデルが使える。自動運転のレベル分けに倣ったモデルで、レベル0から数えるため実際は6段階ある。
| レベル | 名称 | 人間の役割 |
|---|---|---|
| 0 | 高機能な補完 | 自分で書き、補完を受け入れる |
| 1 | コーディングインターン | 定型部分を任せ、全量レビューする |
| 2 | ジュニア開発者 | ペアプログラミングし、全行レビューする |
| 3 | 開発者 | コードの大半をAIが書き、人間はレビューに専念する |
| 4 | エンジニアリングチーム | 仕様と計画を協議し、実装は任せる |
| 5 | ダークファクトリー | 仕様を入れるとソフトウェアが出てくる |
レベル5の公開事例がStrongDMのAIチームである。人間はコードを書かず、レビューもしないという規則で、3人のチームが運用している。検証は次の2つで成り立つ。
- シナリオ:エンドツーエンドのユーザーストーリーを、コードベースの外に置く。機械学習のホールドアウトセットと同じ発想で、実装側のエージェントがテストに合わせ込むことを防ぐ。
- デジタルツイン:Okta、Jira、Slackなど外部サービスの振る舞いを複製する。本番のレート制限や費用を気にせず、障害系を含む大量のシナリオを実行できる。
ただし、このチームは人間のエンジニア1人あたり1日1,000ドルのトークン消費を目安に挙げている。また、スタンフォード大学ロースクールのブログCodeXの論考は、同種の技術が書いて判定もする循環を問題視している。レベル5は到達目標というより、検証基盤にどこまで投資できるかで決まる選択肢である。
Anthropicの実例:読む作業を機械に移す
Anthropicはレビューをやめたのではなく、読む作業の大半を機械に移し、人間の注意をリスクの高い変更に集めた。
数字は2つの対象を分けて読む必要がある。
| 対象 | 公表値 | 期間 |
|---|---|---|
| 全社のモノレポ | 1日のマージ数が約2,500件から30,000件超へ | 2026年5月→9月 |
| Claude Codeのリポジトリ | マージ済みPRが2倍超、リバート率が40%超低下 | 2026年6月→9月 |
| Claude Codeのコード | 約90%をClaudeが記述 | 2026年10月時点の公表 |
この規模ではgitも限界に達し、Anthropicはモノレポを自社開発のバージョン管理システムScionへ移した。コードレビュー基盤Antiqueも併せて構築している。
動画で語られた検証フロー
要点は、人間が読む前にエージェントへ「動く証拠」を出させることである。
- Claudeが初回レビューを実行する。
- ブラウザで実際に動作させ、E2Eテスト、リント、静的解析を走らせる。
- 動画やスクリーンショットを検証証拠として残す。
- フックが編集ごとに差分を確認し、PRを修正するループを回す。
- チームの基準は
CLAUDE.mdなどの共有ファイルに書き、レビュー側が参照する。
6層の構成
同チームは10月15日のエンジニアリング記事で全体像を公開した。
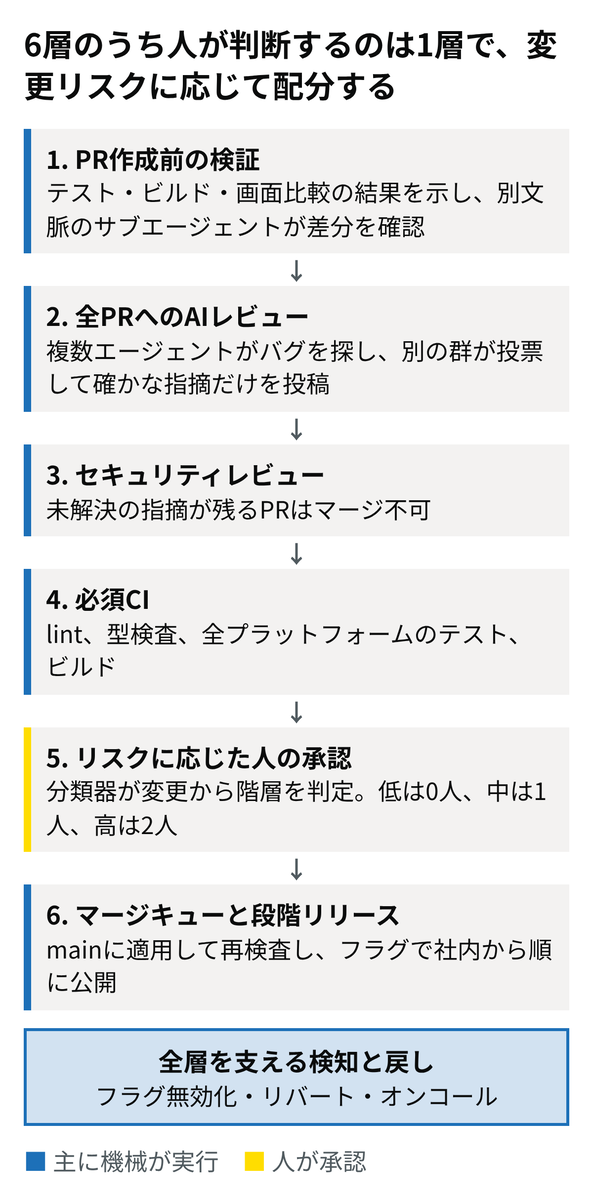
第5層の階層は作者ではなく変更内容で決まる。低リスクはドキュメント、社内限定機能、フラグ付きの追加変更などで、自動検査が通れば人間の承認は不要である。一方、オーナーが機微と指定したパスとCIワークフローのファイルは、常に人間の承認を要する。軽い承認経路を使えるのは、リポジトリの信頼済みリストに載る作者だけである。エージェントの承認は人間の承認に数えず、信頼できない新しいコミットが積まれれば承認はやり直しになる。
自動レビューは収束させる設計が要る
作者もエージェントの場合、細かな指摘は即座に次のコミットと次のレビューを生む。Anthropicでは1つのPRが一晩で50回超のレビューと修正を繰り返した。指摘箇所をgit blameで調べると、約59%は初回レビュー時から存在したコードだった。新しいバグではなく、古いバグを毎回少しずつ見つけていたことになる。対策は次の4つである。
- 3回を終えたら、作者に方針の再考を促す
- 数回目以降は新しい差分だけを見る
- 個別の箇所ではなくバグの種類を指摘し、全箇所を直させる
- 投稿済みの指摘を繰り返さない
社内PRでは、1回のレビューと修正で通る割合が65%から78%に上がり、5回以上かかる割合は8.9%から1.5%に下がった。
数字の読み方と未解決の点
- マージ数は投入量の指標である:30,000件という数字は品質を示さない。Anthropic自身も、人間の所要時間を測り、リバート率とインシデント率をガードレールに置いている。
- 自社公表値である:公式記事はリバートの実数や比較の基準を載せていない。PR数が2倍超なら、率が下がってもリバートの総数は増えた可能性がある。
- 自動の遮断機構がまだない:指標の悪化に応じて承認を厳しくする仕組みは未整備だと、チーム自身が認めている。
- 全体を把握する人がいない:チームは必要な部分の解説をClaudeに書かせれば足りるとする。これには、難しいバグの調査で頼れる理解が人間に残らないとの批判がある。
多層検証:性質の違う検査を重ねる
Kapur氏は検証を「ゼロトラストかつ多層で、すべてのループに組み込むもの」と位置づける。人間が書いたかAIが書いたかを問わず、どのコードも信頼せず、性質の違う層で確かめる。スライドは決定的検証とエージェント的検証の2区分で、依存関係の解析(SCA)を決定的検証に含める。ここではサプライチェーンを分けて3層で示す。
| レイヤー | 検出するもの | 強み | 限界 |
|---|---|---|---|
| 決定的 | SQLインジェクション、バッファオーバーフロー、規約違反 | 同じ入力に同じ結果を返し、安価に全量へ適用できる | ルールに書けない論理の誤りは検出できない |
| エージェント的 | ロジックの誤り、PRの意図とのズレ | リポジトリ全体と意図を踏まえて判断できる | 結果が揺れ、誤検知と推論費用が発生する |
| サプライチェーン | 既知の脆弱性(CVE)、悪意のあるパッケージ | 自社コードの外から入るリスクを扱える | 依存関係の情報と検知の鮮度に左右される |
重ねる理由は2つある。第1に、決定的な検査はLLMとは独立に動くため、StrongDMの節で挙げた「同種の技術が書いて判定する」循環の外に立てる。第2に、機械的に判定できる問題を先に除けば、エージェントのレビューを論理や意図の確認に集中させられる。
なお、登壇者の所属するSonarは検証製品の事業者で、スライドにも「SONAR POV」と明記されている。同社は2026年5月にAIコードレビューのGitarを買収し、SonarQubeと組み合わせて提供している。この枠組みは同社の製品戦略と重なる。ただし、性質の違う検査を重ねる考え方自体は、Anthropicの6層とも共通する。
ガバナンス:暴走より先に権限を決める
エージェントの導入で先に決めるのは、モデルではなく権限と実行環境である。同じ調査の先行値では、承認済みのエージェントはあるが共通の統制が少ない状態が28%、エージェントが自律的に動くソフトウェアファクトリーは5%にとどまる。2026年1月公表のSonarの調査でも、35%の開発者が会社承認ではない個人アカウントでAIツールを使っている。
- サンドボックス:エージェントの実行環境を本番や機密情報から分離する。
- 権限管理:エージェントに固有の識別子を与え、操作できる範囲を最小にする。操作の記録も残す。
- ガードレール:触ってよい範囲、実行してよいコマンド、人間に戻す条件を先に定める。
- 信頼できない入力の扱い:レビュー対象のコード自体がプロンプトインジェクションの経路になる。Anthropicの公開セキュリティレビューも、READMEで信頼できるPRにだけ使うよう明記している。
PRにAI作成のラベルを付ける運用は、短期的には監査と責任の明確化に有効である。ただし、ラベルは責任者の代わりにはならない。Anthropicも、誰がコードを打ったかによらず、変更ごとに責任を負う人間を置いている。
導入の順序:AIレビューは最初に入れない
最初に整えるのは、AIレビュアーではなくテスト、CI、切り戻しである。この基盤がなければ、検証の根拠も失敗時の逃げ道もない。Anthropicが公開した手順をもとに、費用の低い順に並べ直すと次のようになる。
- エージェントが実行できる検証を渡す:テスト、ビルド、リンターのコマンドを短い
CLAUDE.mdに書き、結果の提示を完了条件にする。 - CIを必須にする:PRテンプレートに、テスト方法、リスク、切り戻し方法の欄を設ける。
- 切り戻しを1手順にする:マージキュー、機能フラグ、段階リリースを用意する。
- AIレビューを1リポジトリで試す:数週間かけて指摘の基準を調整し、レビュー回数の上限を設けてから広げる。
- リスク階層を定義する:最初は厳しく設定し、実績を見て緩める。認証、課金、CI、インストーラーは常に人間の承認を要するものとする。
- 指標を固定する:人間の所要時間を最適化の対象、リバート率とインシデント率をガードレールとする。インシデントは評価データに加え、レビュアーを再評価する。
リスク分類器やエージェント間の投票は構築の費用が高い。小規模なチームが先に取り入れるなら、短いCLAUDE.md、コードオーナーが書くレビュー基準、回数上限、リバート率の可視化が費用の低い候補である。問うべきは「人間が全行を読んだか」ではなく、「この変更はどう壊れ得るか、どの検査がそれを捕まえるか」である。
参考資料
- How Anthropic Merges 30,000 Code Changes a Day(AI Engineer)
- How the Claude Code team does code review(Anthropic)
- Anthropic Says Nobody Needs a Mental Model of Claude Code(InfoQ)
- State of Code Developer Survey プレスリリース(Sonar)
- 5 key takeaways from the 2026 State of Software Delivery(CircleCI)
- The Five Levels(Simon Willison)
- How StrongDM’s AI team build serious software(Simon Willison)
- Built by Agents, Tested by Agents, Trusted by Whom?(Stanford Law School CodeX)
- Sonar: AI Code Verification Leader Acquires Gitar(Pulse 2.0)