AI・GPUワークロードのPrometheus監視:gpu_utilの先を見る
GPU監視の要点は3つです。gpu_util だけで負荷を判断しない。系列数は保存前に減らす。推論のアラートはTTFT・トークン間レイテンシ・エラー率に置く。本記事は Sagar Utekar 氏のPromCon 2026の講演「Pushing the Limits: Scaling Prometheus for High-Performance AI & GPU Workloads」の要点に、NVIDIAとPrometheusの一次情報、設定例を加えて整理します。
CPU中心の監視では、1台のGPU不調を見つけられない
GPUクラスタの主な障害要因はハードウェアです。MetaのLlama 3論文によると、最大16KのH100を使った事前学習では、54日間に466回のジョブ中断が発生しました。計画外の419回のうち、約78%はハードウェアに起因するもの、またはその疑いがあるものです。
同期型の学習では、1基の異常がジョブ全体に波及します。
- 停止する故障:1基のGPU障害で、ジョブ全体の再起動が必要になる場合がある
- 動き続ける不調:遅いGPUやノード(ストラグラー)が全体の進行を遅らせる。死活監視には現れず、検知が難しい
ノード単位のCPU・メモリのグラフでは、この2つを区別できません。監視の単位をGPU 1基まで下げ、同じジョブ内のGPU同士を比較する必要があります。
gpu_util は「実際の負荷」を示さない
DCGM_FI_DEV_GPU_UTIL が高くても、GPUの計算資源を使い切っているとは限りません。この値は、サンプル期間中にカーネルが動いていた時間の割合に近い指標です。短いカーネルでも使用中と数えられ、GPU内部のどの資源がどれだけ動いたかは分かりません。
収集には2つのエクスポーターを使い分けます。DCGM ExporterはGPUのハードウェアカウンタを、Keplerはハードウェアの電力計と/proc・/sysの情報をもとにワークロード別の消費電力を、それぞれPrometheus形式で公開します。KeplerのGPU電力の監視は実験的な機能です。
負荷の判断には、DCGMのプロファイリング指標を組み合わせます。
| 指標(フィールドタグ) | Field ID | 測るもの | 読み方 |
|---|---|---|---|
gr_engine_active |
1001 | グラフィックス/コンピュートエンジンが稼働していた時間の割合 | 定義は GPU_UTIL に近い。単独では負荷の深さを判断できない |
sm_active |
1002 | SMで1つ以上のwarpが稼働していた時間の割合 | 0.8以上は有効活用の必要条件で、十分条件ではない。0.5未満は非効率の可能性が高い |
tensor_active |
1004 | Tensor Coreのパイプが稼働していたサイクルの割合 | AI処理でTensor Coreを使えているかを確認する |
dram_active |
1005 | デバイスメモリとのデータ転送があったサイクルの割合 | 実用上の上限は約0.8。上限付近ならメモリ帯域の制約を疑う |
定義はNVIDIA DCGMのドキュメントによります。gr_engine_active と GPU_UTIL の関係はNVIDIA開発者フォーラムの回答を参照しました。warpはメモリ待ちでも「active」と数えられるため、NVIDIAは1つの指標だけで律速要因を断定せず、関連指標とスループットを突き合わせるよう案内しています。
導入時は次の3点を確認します。
- 指標名はバージョンで異なる場合がある。DCGM 4.6のドキュメントは
DCGM_FI_PROF_TENSOR_UTIL_RATIOのような名前を載せており、Exporterの解説ではDCGM_FI_PROF_PIPE_TENSOR_ACTIVEが広く使われている。実環境の/metricsで確認する - 対応する指標はGPU世代で異なる。
dcgmi profile --listで確認する - 同時に収集できない指標は多重化され、高頻度で収集するとゼロが返ることがある
ストラグラーは「低い値」ではなく「ばらつき」で探す
ストラグラーは死活監視に現れないため、同じジョブ内のGPU同士を比較します。指標が高低どちらに振れるかを決め打ちせず、平均からの乖離を両方向で検出します。
abs(
  DCGM_FI_PROF_SM_ACTIVE{namespace="training"}
  - on (namespace) group_left ()
  avg by (namespace) (DCGM_FI_PROF_SM_ACTIVE{namespace="training"})
) > 0.2
namespace はジョブを識別するラベルに、0.2は通常時のばらつきを見て決めた値に置き換えます。候補が見つかったら、DCGM_FI_DEV_SM_CLOCK、DCGM_FI_DEV_GPU_TEMP、DCGM_FI_DEV_XID_ERRORS を確認し、サーマルスロットリングとハードウェアエラーを切り分けます。
メトリクス爆発は、保存する前に止める
Prometheusの系列数は、ラベルの組み合わせの数だけ増えます。request_id のように値が際限なく増えるラベルを1つ入れると、リクエストごとに新しい系列が生まれます。対策は上流から順に4段階あります。
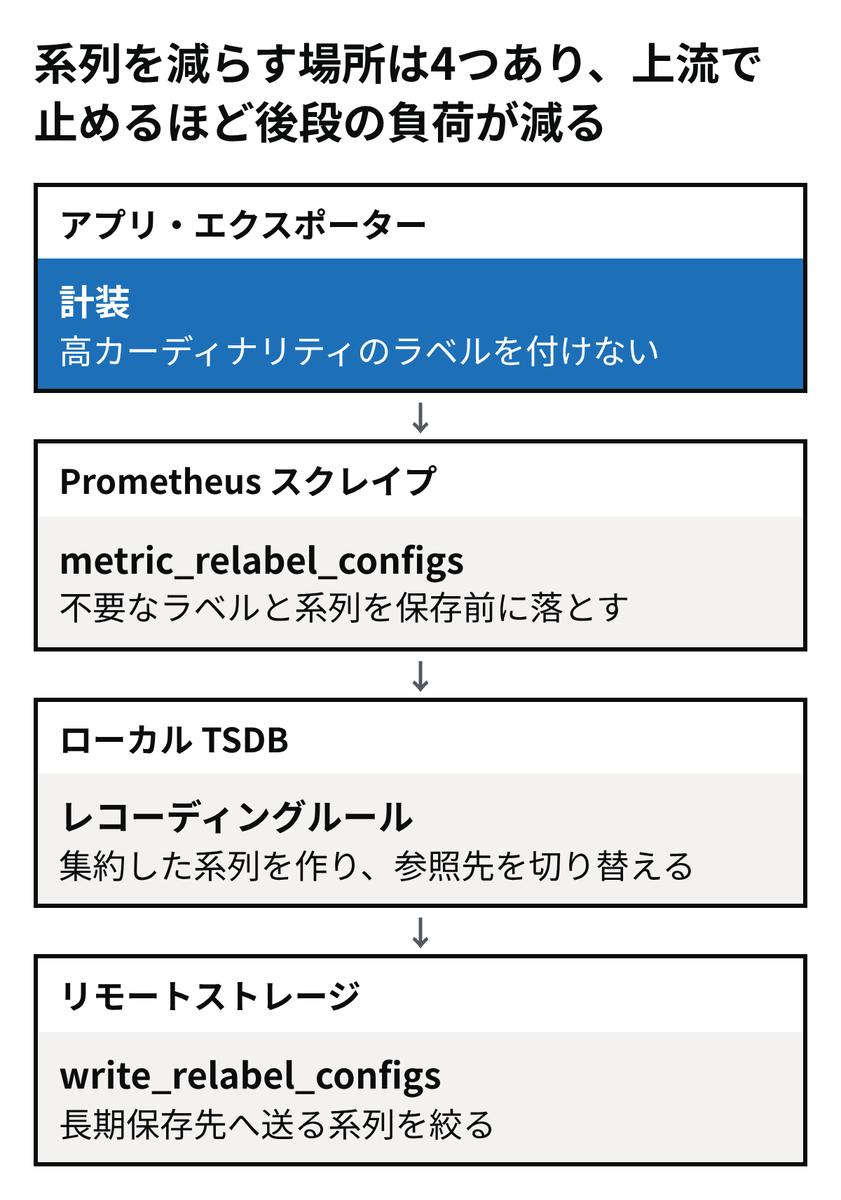
1. 計装:高カーディナリティのラベルを付けない
上流で止めるほど、後段の負荷を減らせます。リクエスト単位の追跡はログやトレースに任せ、メトリクスのラベルは model_name のように値の種類が限られるものに絞ります。
2. スクレイプ後:metric_relabel_configs で落とす
scrape_configs:
  - job_name: inference
    metric_relabel_configs:
      - action: labeldrop
        regex: request_id
      - action: drop
        source_labels: [__name__]
regex: debug_.*relabelの適用タイミングは設定ごとに異なります。relabel_configs はスクレイプ前に対象を選ぶ設定で、取得したメトリクスのラベルには使えません。取得後のメトリクスには metric_relabel_configs を、リモート送信の直前には write_relabel_configs を使います。
labeldrop の後も、系列はラベルで一意に識別できる必要があります。request_id だけが系列を区別していた場合は衝突するため、計装側の修正が必要です。
3. 集約:レコーディングルールで事前計算する
groups:
  - name: gpu_aggregation
    rules:
      - record: namespace:gpu_sm_active:avg
        expr: avg by (namespace) (DCGM_FI_PROF_SM_ACTIVE)
ダッシュボードとアラートは集約後の系列を参照します。長期保存先には集約後の系列を送り、GPU単位の生データはローカルで短期間だけ保持します。
4. ヒストグラム:ネイティブヒストグラムで系列を減らす
クラシックヒストグラムは、バケットごとに _bucket 系列を作ります。たとえば20バケットのレイテンシ指標を50 Podで公開すると、_bucket だけで1,000系列です。ネイティブヒストグラムは、1サンプルにカウント、合計、バケットをまとめて持ちます。
global:
  scrape_native_histograms: true

remote_write:
  - url: https://remote-write.example.com/api/v1/push
    send_native_histograms: true
Prometheus v3.8.0で安定機能になりましたが、v3系では明示的な有効化が必要です。計装側がネイティブヒストグラムを公開していない場合は、スクレイプ設定の convert_classic_histograms_to_nhcb: true で、クラシックヒストグラムをカスタムバケット形式(NHCB)に変換して取り込めます。scrape_native_histograms を有効にするとスクレイプはprotobuf形式が優先されるため、適用前にCPU負荷も確認します。NHCBに変換すると _bucket 系列は取り込まれなくなるため、_bucket を参照する既存のクエリも見直します。
推論のアラートは3つのSLIに置く
GPU使用率はキャパシティ判断の材料で、利用者の体感は示しません。推論サービスのアラートは、次の3指標に置きます。
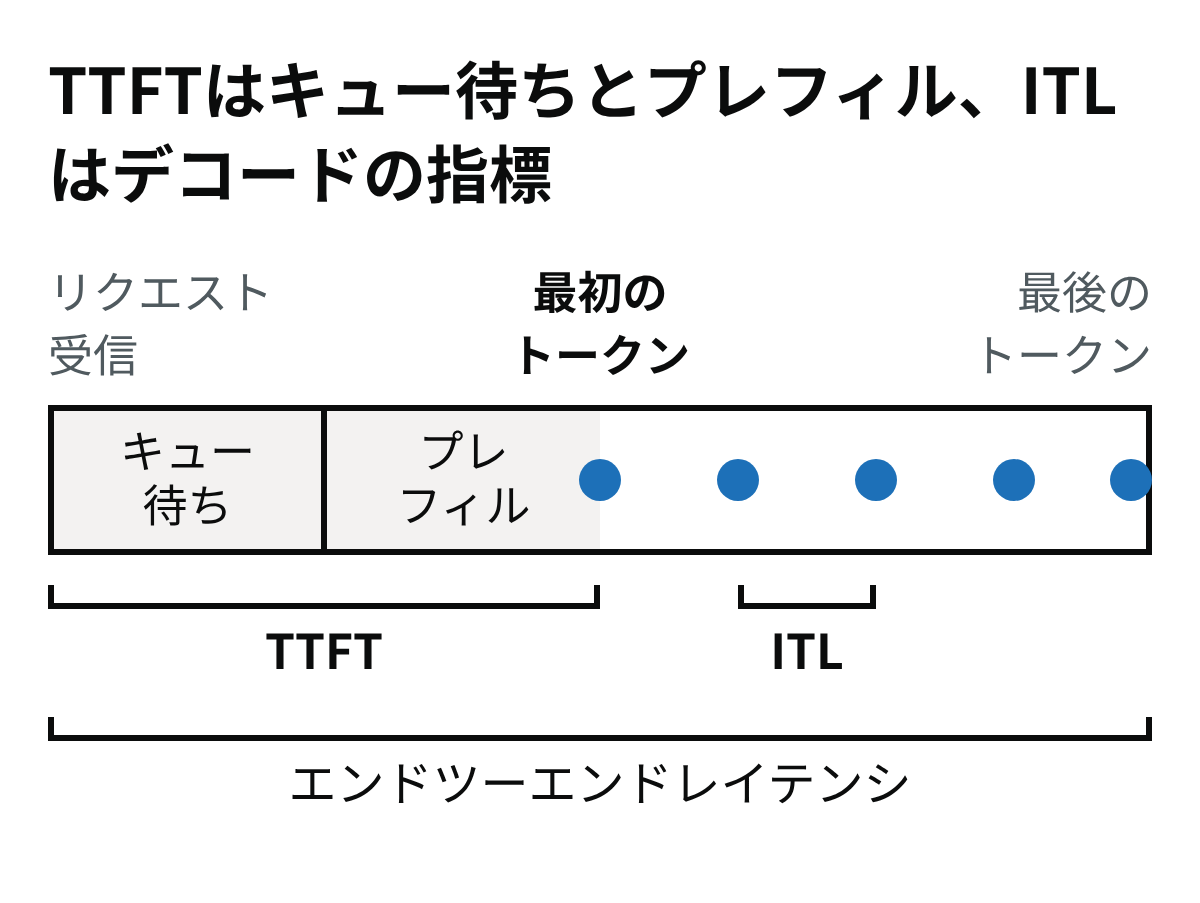
| SLI | 利用者から見た意味 | 悪化時にまず見る箇所 |
|---|---|---|
| Time to First Token(TTFT) | 応答が始まるまでの待ち時間 | キュー長、プロンプト長、KVキャッシュ |
| Inter-Token Latency(ITL) | ストリーミングの滑らかさ | 同時実行数、GPUの飽和、プリエンプション |
| Error Ratio | 失敗したリクエストの割合 | ゲートウェイの5xx、タイムアウト、OOM |
vLLMの場合、TTFTとITLはPrometheusヒストグラムとして公開されています。平均値はテールの悪化を隠すため、パーセンタイルで評価します。vLLMのITLは連続する出力の間隔を測る指標で、1出力に複数トークンが入る場合はトークン間の時間と一致しません。
# TTFT p95
histogram_quantile(0.95,
  sum by (model_name, le) (rate(vllm:time_to_first_token_seconds_bucket[5m])))

# ITL p95
histogram_quantile(0.95,
  sum by (model_name, le) (rate(vllm:inter_token_latency_seconds_bucket[5m])))

# 2.5秒以内に最初のトークンを返したリクエストの割合
sum by (model_name) (rate(vllm:time_to_first_token_seconds_bucket{le="2.5"}[5m]))
/
sum by (model_name) (rate(vllm:time_to_first_token_seconds_count[5m]))
エラー率は推論エンジンの外側で測ります。vLLMの vllm:request_success_total は、finished_reason ラベルで完了理由を区分するカウンタです。エンジンに届く前の失敗も捉えるため、ゲートウェイのHTTPメトリクスを使います。
sum(rate(http_requests_total{job="llm-gateway", code=~"5.."}[5m]))
/
sum(rate(http_requests_total{job="llm-gateway"}[5m]))
メトリクス名と2.5秒のしきい値は例です。TTFTはプロンプト長に、ITLはモデルと同時実行数に左右されるため、目標値はモデルごとに実測して決めます。
導入は利用者に近い指標から始める
- ゲートウェイと推論エンジンから、TTFT、ITL、エラー率を取得してアラートを設定する
- DCGM Exporterを導入し、
sm_active、tensor_active、dram_activeをGPU単位で可視化する promtool tsdb analyzeとTSDBステータス画面で系列数の多い指標を特定し、計装とrelabelで削減する- レコーディングルールで集約し、長期保存先へ送る系列を絞る
- ジョブ内のばらつき、クロック、温度、XIDエラーでストラグラーの検知を追加する
関連記事
自社運用のGPU基盤で推論を賄う事例は、次の記事で整理しています。
オープンモデル自社運用でAIコーディング費用を1/10に:Revolutの事例と他社比較
1トークンあたりの計算量を変えるモデルの仕組みは、次の記事で解説しています。
NVIDIA Dory 1.0 4Bの仕組み:ループ型Transformerはパラメータを増やさず計算量を増やす
AIファクトリーの全体像は、GTC Berlin 2026の基調講演まとめで整理しています。
NVIDIA GTC Berlin 2026基調講演まとめ|DSX POD・OpenShell・フィジカルAIの発表を解説
参考資料
- Sagar Utekar「Pushing the Limits: Scaling Prometheus for High-Performance AI & GPU Workloads」(PromCon 2026 Munich)
- The Llama 3 Herd of Models(Meta)
- Profiling — NVIDIA DCGM Documentation
- GPU utilization — NVIDIA Developer Forums
- Kepler
- Kepler Re-architected — CNCF
- Native Histograms — Prometheus
- How relabeling in Prometheus works — Grafana Labs
- Metrics design — vLLM
- vLLM dashboard — SigNoz