NVIDIA Dory 1.0 4Bの仕組み:ループ型Transformerはパラメータを増やさず計算量を増やす
NVIDIA Dory 1.0 4Bは、36層のうち中央の20層を1トークンの生成中に1〜4回繰り返す、40億パラメータのオープンモデルである。同じ重みのままループ数だけを変え、精度と計算量を調整できる。
要点は次の3つである。
- 計算量の軸が1本増える:パラメータ数や出力トークン数を増やさず、1トークンあたりの計算を増やす。実行される層数は1ループの36層から、4ループで96層になる
- 伸びる領域と伸びない領域が分かれる:SWE-bench Verifiedは50.3から61.8へ、AA-LCRは63から73へ伸びる。一般知識のAA-Omniscienceは約10のまま動かない
- メモリ増は抑えられるが、計算は増える:
last_loopモードならKVキャッシュは1ループ分で済む。一方で1トークンあたりの計算は減らない
本記事はNVIDIAのモデルカードを一次資料とする。ベンチマークの数値は、公表値1つを除きNVIDIA自身の計測である。
概要
DoryはNemotron Labsの名前で2026/10/16に公開された。モデルカードは商用・非商用のどちらの利用も可としている。
| 項目 | 内容 |
|---|---|
| パラメータ数 | 4B(40億) |
| アーキテクチャ | ループ型(latent-recurrent)のnormalized-GPT。sliding-window attentionとfull attentionの層を織り交ぜて配置 |
| 層構成 | 入力8層、再帰20層、出力8層 |
| コンテキスト長 | 最大256Kトークン |
| 対応言語 | 英語(学習データには43のプログラミング言語を含む) |
| ライセンス | OpenMDW-1.1 |
| 形式 | BF16、MXFP8、NVFP4、Q5_K_M(GGUF) |
| 事前学習 | 6Tトークン(最初の約4.5TをNVFP4、残りをBF16)+コンテキスト拡張300Bトークン |
| 事後学習 | 教師ありファインチューニング、GRPOによる強化学習 |
| 学習データの収集期間 | 2013年〜2025年12月 |
特徴的なのは、NVFP4という4ビット浮動小数点形式で事前学習の大半を行った点である。学習後の量子化ではなく、低精度のまま学習している。ただしDoryのベンチマークの数値はBF16版のものである。
アーキテクチャ
Doryは層を入力・再帰・出力の3群に分け、再帰ブロックだけを繰り返す。通常のTransformerは各層を1回ずつ通すため、層を増やすと重みも比例して増える。Doryは同じ重みを再利用するので、実行する層数を増やしても重みは増えない。
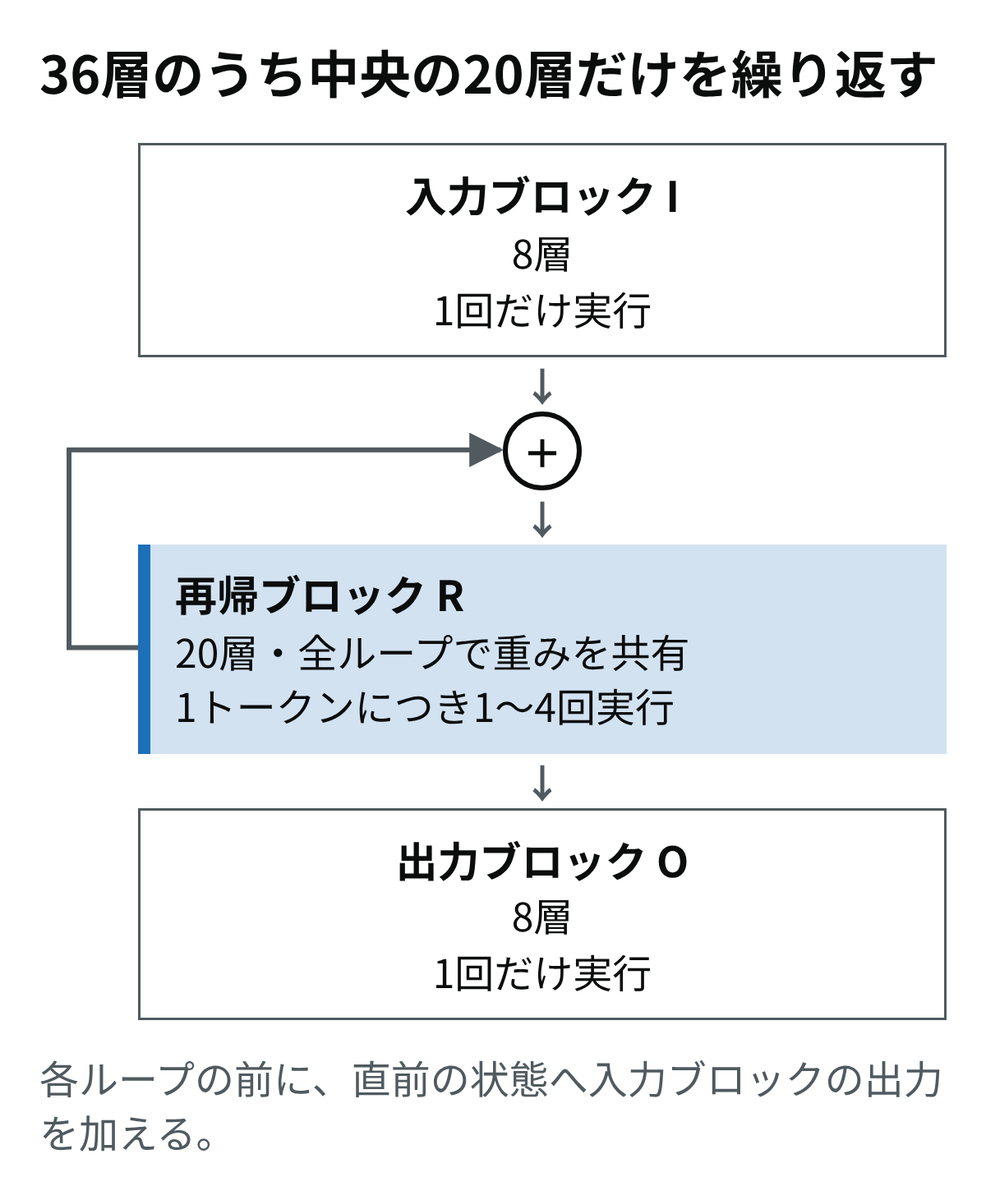
Doryの層構成。NVIDIAモデルカードの構成図をもとに作成
再帰ブロックに入るたびに入力ブロックの出力が加わる。繰り返しの中でも入力への接続を保つ構造である。
ループ数をLとすると、1トークンの生成で実行する層数は 8 + 20 × L + 8 である。
| ループ数 | 実行する層数 | 1ループ比 |
|---|---|---|
| 1 | 36 | 1.00倍 |
| 2 | 56 | 1.56倍 |
| 3 | 76 | 2.11倍 |
| 4 | 96 | 2.67倍 |
この倍率は層数から求めた概算であり、実測の処理時間ではない。sliding-window attentionとfull attentionでは1層あたりの計算量が異なる。
計算の増やし方の比較
ループは、パラメータ数と思考トークンに続く第3の調整軸である。
| 増やし方 | 増えるもの | 重みのメモリ | 出力トークン | 切り替え方法 |
|---|---|---|---|---|
| パラメータ数 | 層数や幅 | 増える | 直接は増えない | モデルの入れ替え |
| 思考トークン | 生成するトークン数 | 増えない | 増える | プロンプトや推論設定 |
| ループ数 | 1トークンあたりの層の実行回数 | 増えない | NVIDIAの計測では減る | 設定値の変更 |
先行研究との関係
ループ型Transformerの系譜はUniversal Transformers(2019年)にさかのぼる。近年は数十億パラメータの言語モデルに適用されている。次の表はLoopie論文とCDB論文の記述、およびDoryのモデルカードによる。
| モデル | パラメータ数 | ループ数 | 繰り返す範囲 |
|---|---|---|---|
| Huginn | 3.5B | 32(学習時) | 前後の2層ずつを除く中央の4層 |
| Ouro | 1.4B、2.6B | 4 | 全層をまとめて繰り返す |
| Loopie | 20B-A2B、6B-A0.6B | 2 | 各層をその場で繰り返す |
| Dory | 4B | 1〜4(推論時) | 前後の8層ずつを除く中央の20層 |
Loopie論文は、パラメータ数だけの比較に疑問を示している。N回ループして事前学習すれば学習の計算量もN倍になるため、同じ計算予算の非ループモデルと比べるべきだという主張である。Doryのモデルカードには学習時のループ数の記載がなく、計算量をそろえた比較も載っていない。後述の4ループのDoryとQwen3.5-9Bの比較も、計算量をそろえたものではない。
KVキャッシュ:per_loopとlast_loop
ループ型モデルのメモリ問題は重みではなくKVキャッシュにあり、Doryはlast_loopモードでこれを1ループ分に抑える。
KVキャッシュは、プロンプトと生成済みトークンのキーとバリューをattention層ごとに保存する仕組みである。保存しておけば、過去のトークンを再計算せずに参照できる。重みを共有していても、ループごとに別のキャッシュを持てばメモリはループ数に応じて増える。
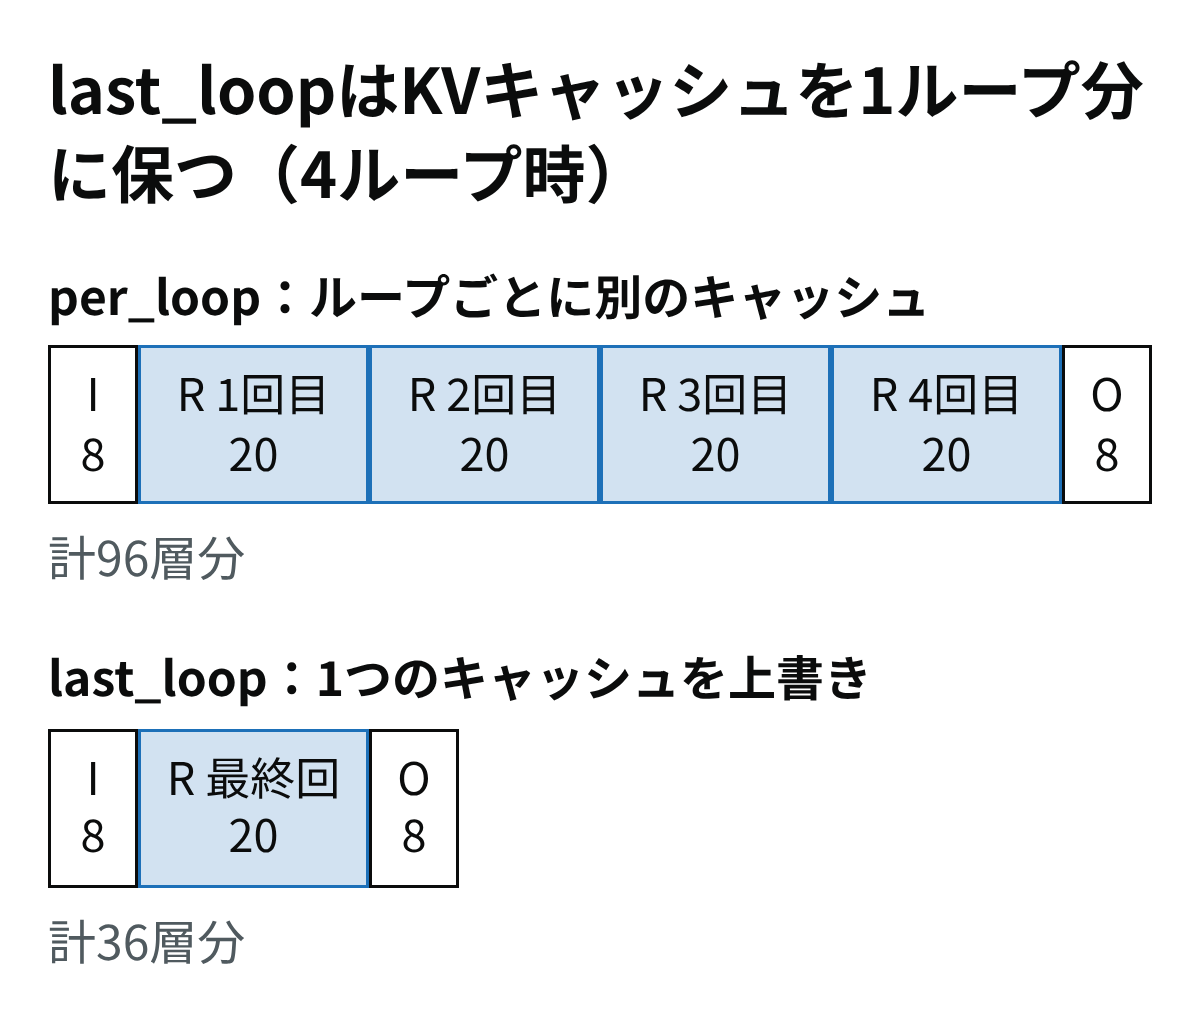
KVキャッシュのモード別の持ち方。幅は層数に比例し、実際のメモリ量はattentionの種類で異なる
| モード | 動作 | キャッシュの量 |
|---|---|---|
per_loop |
再帰層のキャッシュをループごとに別々に保持する | ループ数に応じて増える |
last_loop |
再帰層ごとに1つだけ保持し、各ループが上書きする。最終ループの値だけが残る | ループ数によらず1ループ分 |
last_loopで空いたメモリは、より長いコンテキストや同時リクエスト数に回せる。したがってKVキャッシュがループ数で増えないのは、last_loopを有効にした場合である。モデルカードの起動例はどちらもper_loopを指定している。
精度への影響はモデルに依存する
NVIDIAは、last_loopの精度はper_loopに近く、出力長もほぼ変わらないと述べている。ただしモデルカードに具体的な数値はない。
他のループ型モデルでは、この種の共有の影響がモデルごとに大きく異なる。CDB論文のGSM8Kの結果は次のとおりである。
| キャッシュの持ち方 | Ouro 1.4B(4ループ) | Huginn 3.5B(16ループ) |
|---|---|---|
| ループごとに別々 | 78.09% | 30.93% |
| 全ループで1つを共有 | 0.23% | 32.52% |
Ouroは大きく低下し、Huginnはほぼ変わらない。どちらもKV共有向けの学習はしていない。Ouroの著者らは共有時に78.85%と報告しているが、CDB論文の著者は再現できず、プロンプト処理の違いを候補に挙げつつ断定していない。CDB論文によれば、Ouro論文の報告ではプロンプト処理まで共有した場合の低下は約10ポイントであり、上の表の低下はそれより大きい。Dory自身についても、llama.cppのPR #30306は、last_loopは個別キャッシュと予測が変わり、プロンプト処理の分割サイズの影響も受けると記している。Doryでlast_loopを使う場合は、自分のワークロードでper_loopと比較してから採用する。
ベンチマーク
4ループのDoryは10項目中3項目で比較モデルの最高値を取る一方、推論と一般知識の3項目では同じ4BのQwen3.5-4Bを下回る。太字は各行の最高値である。
| 項目 | Dory 1ループ | Dory 2ループ | Dory 4ループ | Qwen3.5-4B | Qwen3.5-9B | Gemma 4 26B A4B | Qwen3.6-35B-A3B |
|---|---|---|---|---|---|---|---|
| SciCode | 27.3 | 34.94 | 35.11 | 25.82 | 28.21 | 40.32 | 37.24 |
| SWE-bench Verified | 50.3 | 59.5 | 61.8 | 54.7 | 61 | 57.4 | 73.4† |
| Terminal-Bench 2.1 | 12.5 | 18.1 | 22.2 | 15 | 24 | 35 | 43 |
| τ³-bench (Banking) | 11.6 | 12.89 | 14.69 | 5.03 | 7.22 | 13.66 | 9.54 |
| GDPval-AA-V2(Elo) | 815 | 946 | 967 | 424 | 546 | 751.6 | 987 |
| GPQA Diamond(ツールなし) | 69.19 | 72.41 | 72.16 | 77.71 | 80.93 | 80.43 | 85.35 |
| HLE(テキストのみ、ツールなし) | 8.25 | 10.89 | 10.43 | 11.31 | 15.43 | 17.79 | 19.18 |
| IFBench | 74.29 | 77.94 | 79 | 53.83 | 59 | 77.89 | 57.44 |
| AA-LCR | 63 | 71 | 73 | 64.7 | 68.4 | 64.6 | 68.5 |
| AA-Omniscience(正答率) | 10.03 | 10.08 | 10.03 | 15.02 | 18.05 | 21.13 | 19.95 |
†は公表値で、それ以外はNVIDIAが同一の評価環境で計測した値である。AA-LCRは修正版の解答に旧版の判定モデルを組み合わせるなど、AA系の項目はArtificial Analysisの公式値と異なる場合がある。A3B、A4Bは、トークンごとに動くアクティブパラメータ数を示す。
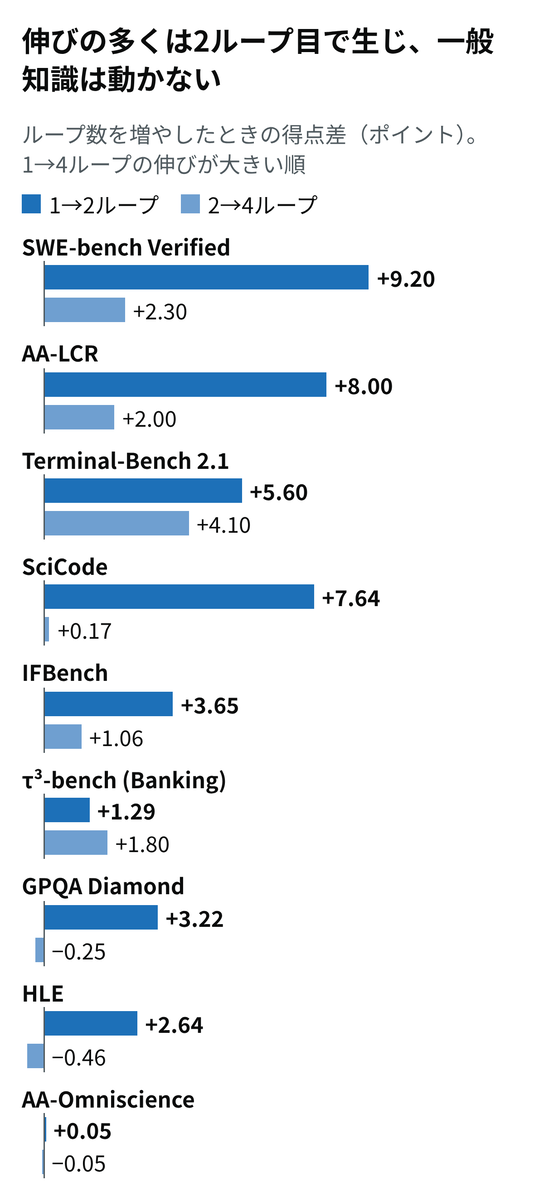
NVIDIAモデルカードの得点から算出。Elo表記のGDPval-AA-V2は除く
数値から読み取れることは次の4点である。
- ループ数で順位が変わる:Qwen3.5-4Bとの比較は、1ループでは4勝6敗、4ループでは7勝3敗である。Qwen3.5-9Bには4ループで6勝4敗となる
- 伸びは2ループ目に集中する:SWE-bench Verifiedは2ループ目で+9.20、以降は+2.30である。例外はTerminal-Bench 2.1とτ³-benchで、2→4ループの伸びが大きく、τ³-benchでは1→2ループを上回る。推論系のGPQA DiamondとHLEは2ループで+3.22、+2.64伸び、4ループではわずかに下がる
- 長文脈と指示追従に強い:AA-LCRとIFBenchでは、2ループの時点で4つの比較モデルすべてを上回る。ただしIFBenchの差はGemma 4に対して0.05である
- 知識はループで増えない:AA-Omniscienceは10.03〜10.08で横ばいである
知識の結果は、計算を増やしても重みに保持できる情報は増えないという解釈と整合する。これは得点からの推定であり、NVIDIAが原因を示したものではない。
Doryの得点はすべてNVIDIAによるBF16版の計測であり、量子化版の得点はモデルカードに載っていない。本記事の調査範囲では、第三者による再現結果を確認していない。
トークン効率
ループを増やすと出力トークンは最小で0.40倍まで減るが、層数で換算した総計算量は、計測のある4項目とも1ループを下回らない。NVIDIAの主張は「同じタスクを少ないトークンで解く」であり、総計算量には触れていない。
次の表は、1ループを1としたときの値である。出力トークン比はNVIDIAのモデルカードのグラフの値(1試行あたり)である。総計算量は、出力トークン比に層数比(56/36、96/36)を掛けた本記事の概算である。
| 項目 | 出力トークン比(2ループ) | 出力トークン比(4ループ) | 総計算量の概算(2ループ) | 総計算量の概算(4ループ) |
|---|---|---|---|---|
| GDPval-AA-V2 | 0.66 | 0.40 | 1.03 | 1.07 |
| Terminal-Bench 2.1 | 0.72 | 0.50 | 1.12 | 1.33 |
| SWE-bench Verified | 0.79 | 0.74 | 1.23 | 1.97 |
| τ³-bench (Banking) | 0.80 | 0.77 | 1.24 | 2.05 |
項目によって費用対効果は大きく異なる。GDPval-AA-V2は総計算量1.07倍でEloが815から967に上がる。SWE-bench Verifiedは総計算量1.97倍で50.3から61.8に上がる。2→4ループに限ると約1.6倍の計算で+2.30である。
この概算には次の項目を含めていない。
- プロンプト処理の計算
- attentionの種類による1層あたりの計算量の差
- 成功率の向上で再試行が減る効果
- 1トークンあたりの待ち時間の増加
NVIDIAも、ループ数は実際のワークロードでエンドツーエンドの遅延とコストを測って選ぶよう勧めている。
動かす
ループ数とKVキャッシュのモードは、モデルカードの手順ではサーバー起動時に指定する。2026/11/03時点で、vLLMの対応PR #60149はマージ済み、llama.cppの#30306はドラフトである。次のコマンドはモデルカードの記載どおりで、vLLMはリリース版の対応状況を確認して導入方法を選ぶ。
vLLM
VLLM_USE_PRECOMPILED=1 pip install "git+https://github.com/vllm-project/vllm.git@refs/pull/60149/head"

vllm serve --model nvidia/NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 \
    --hf-overrides '{"n_recurrent_loops": 2, "recurrent_kv_cache_mode": "per_loop"}' \
    --max-model-len 262144 \
    --max-num-seqs 128 \
    --enable-prefix-caching \
    --async-scheduling \
    --reasoning-parser nemotron_v3 \
    --tool-call-parser qwen3_coder \
    --enable-auto-tool-choice
llama.cpp
llama.cppではGGUF版(dory-q5_k_m.gguf、3,673,288,864バイト)を使う。モデルカードの手順はApple Silicon向けで、PR作者のフォークを固定のコミットでビルドする。ビルド手順はモデルカードにある。
./build/bin/llama-server \
    -m ./dory-q5_k_m.gguf \
    --alias dory \
    --host 127.0.0.1 --port 8080 \
    -ngl 999 \
    --ctx-size 4096 --parallel 1 \
    --batch-size 512 --ubatch-size 512 \
    --cache-type-k f16 --cache-type-v f16 \
    --flash-attn off \
    --no-context-shift \
    --jinja --reasoning on \
    --temp 1.0 --top-p 0.95 --top-k 0 --min-p 0 --repeat-penalty 1 \
    --override-kv "dory.num_loops=int:2,dory.recurrent_kv_cache_mode=str:per_loop"
設定項目
| 設定 | vLLM | llama.cpp |
|---|---|---|
| ループ数 | n_recurrent_loops |
dory.num_loops(1〜4) |
| KVキャッシュ | recurrent_kv_cache_mode |
dory.recurrent_kv_cache_mode |
| 指定場所 | --hf-overrides |
--override-kv |
推奨のサンプリング設定はTemperature 1.0、Top_P 0.95である。コーディングエージェントで使う場合は、APIのchat_template_kwargsにforce_nonempty_content: trueを指定する。
量子化版の速度
DGX Spark(バッチサイズ1)でのBF16比の速度向上は次のとおりで、NVFP4は2倍以上になる。ただし量子化版の精度はモデルカードに載っていない。
| 入力長 / 出力長(トークン) | MXFP8 | NVFP4 |
|---|---|---|
| 2,560 / 300 | 1.69倍 | 2.17倍 |
| 128 / 1,024 | 1.84倍 | 2.44倍 |
制約
- 言語:対応言語は英語のみで、日本語は対応言語に含まれない
- 動作環境:公式の対応はNVIDIA Hopper / Blackwell、OSはLinuxである。Apple Silicon向けの手順はローカルの参考構成として示されている
- llama.cpp:PR #30306は、Metalが未検証で、長文脈の検証とCIが未完了であり、5ループ以上に対応しないことを制限事項に挙げている
- リクエスト単位の切り替え:vLLMでは、ドラフトのPR #63150がリクエストごとのループ数指定を提案している。未マージである
- トークン単位の切り替え:トークンごとに深さを変える機能はモデルカードにない。この方式はCDB論文などが研究している
用途別の設定指針
初期値は2ループとし、英語の指示追従、長文脈、エージェント用途で評価する。標準、計算量最小、エージェント用途のループ数はNVIDIAの推奨により、それ以外は本記事の整理である。
| 用途 | ループ数 | KVキャッシュ | 根拠 |
|---|---|---|---|
| 標準 | 2 | まずper_loopで基準を測る |
伸びの大半が2ループ目で得られる |
| 1トークンあたりの計算量を最小にしたい処理 | 1 | どちらでも同じ | 1トークンあたりの計算が最小になる |
| エージェント、コーディング | 4を比較 | 比較して決める | Terminal-Bench 2.1は4ループまで伸びる |
| 長文脈、多数の同時リクエスト | 2〜4 | last_loopを比較 |
空いたメモリを文脈長と同時実行数に回せる |
| 一般知識の回答 | Doryは不向き | ー | AA-Omniscienceはループで伸びず、比較モデルすべてを下回る |
評価では、正答率に加えて次の3点を同時に測る。
- 1タスクあたりの総トークン数
- 1タスクあたりのエンドツーエンド遅延
- 使用するループ数とモードでのピークメモリ
関連記事
オープンモデルの自社運用の実例は、Revolutの事例で整理しています。
オープンモデル自社運用でAIコーディング費用を1/10に:Revolutの事例と他社比較
推論基盤の監視指標は、次の記事で解説しています。
AI・GPUワークロードのPrometheus監視:gpu_utilの先を見る
NVIDIAの発表全体は、GTC Berlin 2026の基調講演まとめで整理しています。
NVIDIA GTC Berlin 2026基調講演まとめ|DSX POD・OpenShell・フィジカルAIの発表を解説