オープンモデル自社運用でAIコーディング費用を1/10に:Revolutの事例と他社比較
要約
欧州のデジタルバンクRevolutは、約2,000人のエンジニアが使うAIコーディング基盤を商用APIからGLM系オープンモデルの自社運用に切り替え、トークンの混合単価を100万トークンあたり約0.30ドル、請求額を従来の約10分の1にした。根拠は次の3点である。
- コスト:NVIDIA B200を56基に固定したまま2,000人分の推論を賄い、課金が定額になった。
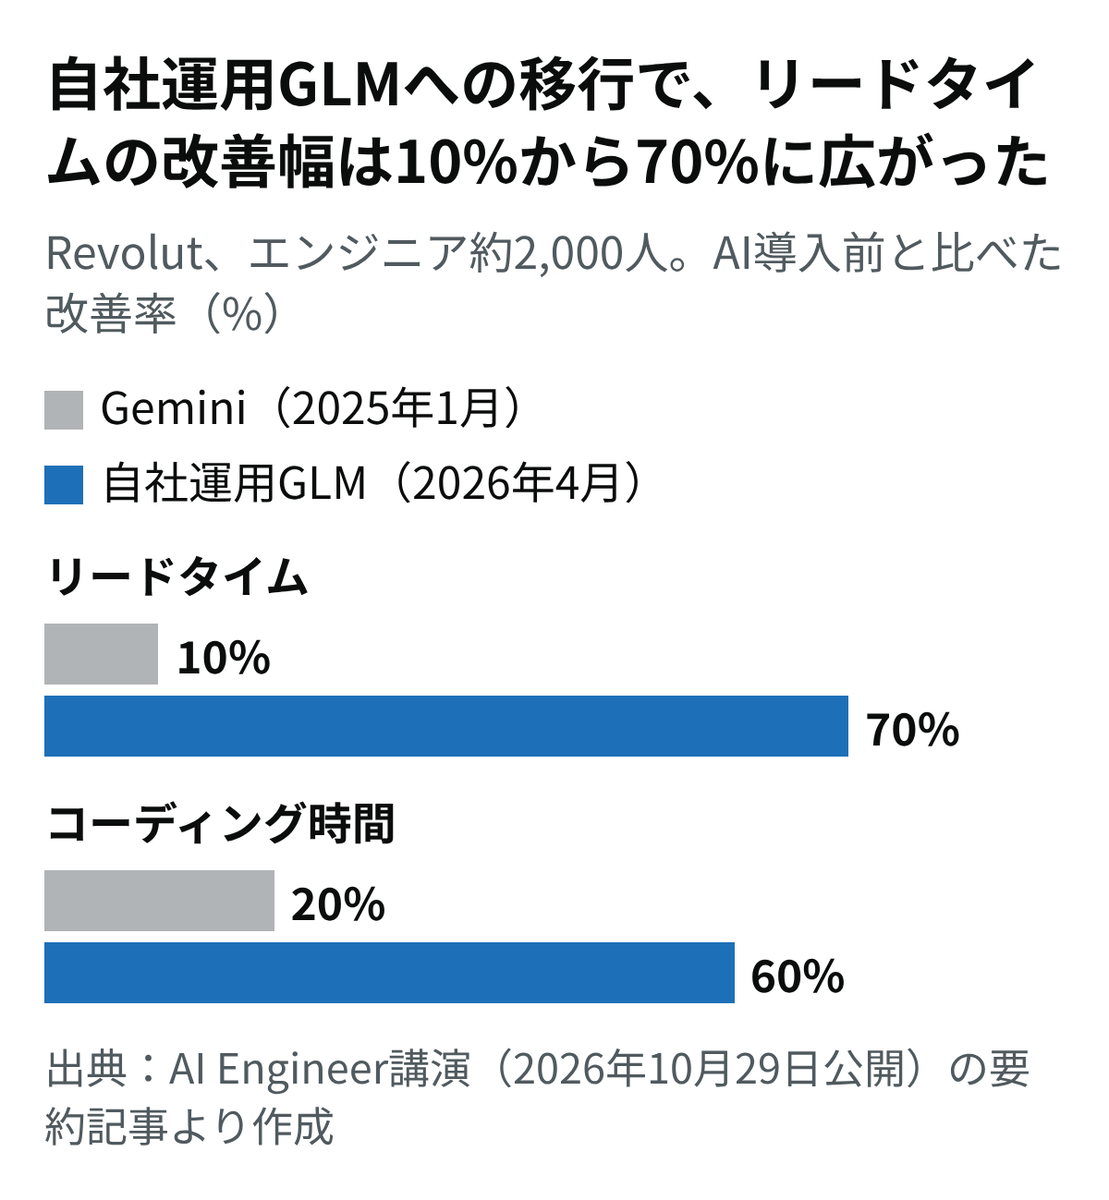
- 生産性:トークン利用の制限を外した結果、コーディング時間が60%、リードタイムが70%改善した。商用モデルGeminiだけの時期は10%と20%だった。
- 運用:GPUを増やさず設定の最適化だけで、最初のトークンまでの時間(TTFT)を10秒超から約1.6秒へ短縮した。
同じ方向の動きはHarvey、Lindy、Detail、Airbnb、Cursorにも見られる。一方で、GPU稼働率が低い場合や高難度タスク中心の場合は、自社運用のほうが高くつくという測定結果もある。本記事は2026年10月29日公開のAI Engineer講演と、その周辺の報道・研究をもとに整理した。
Revolutの事例
Revolutは顧客8,000万人、45市場で事業を行う欧州のデジタルバンクである。AI運用責任者のDavid Abitbol氏が、約1年間・エンジニア2,000人分の計測データをもとに、自社運用への移行判断と運用の要点を約12分で説明した(講演動画)。
| 項目 | 内容 |
|---|---|
| 利用者 | エンジニア約2,000人 |
| モデル | GLMシリーズ(Z.ai製オープンウェイト。2026年4月時点でGLM 5.1、現在は約8,000億パラメータのGLM 5.3) |
| GPU | NVIDIA B200 56基 |
| 混合トークン単価 | 100万トークンあたり約0.30ドル |
| 請求額 | Anthropic・OpenAIに支払っていた額の約10分の1 |
| 移行前の課題 | 商用ツールでエンジニア1人あたり月1,000〜10,000ドルを消費し、投資対効果が見合わなかった |
| 現在の位置づけ | オープンモデルが標準。Codex、Claude Code、Geminiは最難関タスク用の例外 |
生産性の推移は次のとおりである。Claude Codeは2025年2月に試行、2026年1月に全社展開したが、厳しい予算上限を付けた状態では効果が測定上ほとんど出なかった。
効果の源泉はトークン制限の撤廃
改善幅を押し上げた要因は、モデルの賢さよりも「使える量」の変化である。従量課金の商用APIでは予算上限を設けたため、エンジニアは四半期末や最難関タスクのためにトークンを温存していた。自社運用で課金が定額になり、月末の請求ショックがなくなったことで、日常業務すべてにAIを使えるようになった。
コーディング時間(60%)よりリードタイム(70%)の改善が大きい点も同じ理由で説明できる。Abitbol氏によれば、開発のボトルネックはコードを書く作業ではなく、メールの確認、Jira・Confluenceでの仕様や情報の探索といった周辺作業にある。トークンを気にせず周辺作業にもAIを使えることが、着手からマージ・デプロイまでの時間を縮めた。
スループットの目標は控えめである。エンジニアは複数タスクを並列で投げて完了後に確認するため、1秒あたり200トークンで足りるとしている。GPUが空く17時以降は800トークン/秒が出る。一方、TTFTは3秒未満を目標とし、5秒を超えると苦情が殺到するという。
GPUを増やさず設定で性能を出す
重みをGPUに載せて推論を動かすだけでは性能は出ない。Revolutは2026年4月から8月までGPUを56基に固定したまま、TTFTを10秒超から約1.6秒に、処理できる要求数を毎秒約3件から7件超に引き上げた。需要が76%増えるなかで性能を88%改善しており、教訓は「スケールアウトの前にチューニング」である。講演で挙げられた設定項目は次のとおり。
| 項目 | Revolutの判断 |
|---|---|
| コンテキスト長 | 100万トークン対応でも、実際に必要なのは256Kまで。長いコンテキストはKVキャッシュを圧迫するだけで効果が薄い |
| 量子化 | Blackwell世代ではFP4を上限とする。FP8にするとGPU使用量が約40%増え、精度の向上はない |
| テンソル並列 | GLMはTP4に収まるがKVキャッシュが不足する。負荷次第でTP8のほうが良い |
| キャッシュヒット率 | コーディング用途では90%超が必要 |
| その他 | 投機的デコーディングの最適化、プリフィル処理の順次化、プリフィルとデコードの分離(PD分離) |
| 画像入力 | GLMはテキスト専用。画像はOpenCodeなどのルーターで別モデルに回し、テキスト側は賢いモデルを優先する |
| API形式 | 全エンドポイントをOpenAI互換(Responses API対応)にし、OpenCode・Codexからそのまま使えるようにする |
これらの数値はRevolutのワークロード(コーディング支援、2,000人、日中集中)での値である。コンテキスト長とTP構成は利用パターンで最適値が変わるため、自社の実トラフィックで計測して決める必要がある。
金融規制下での運用
EUの規制下にある銀行が中国製オープンウェイトを使えた理由は、データの流れと人間の関与を設計で担保したことにある。
- データの所在:中国側の推論エンドポイントは使わず、重みだけを取得して米国内のGPUで動かす。推論データは国外のモデル開発元に送られない。GPUの設置先は米国・EU・英国・イスラエルなど十分性認定の対象国に限り、GPU・推論事業者はデータ保持ゼロを標準とする。
- 自律エージェントにしない:コーディング支援は常に人間が介在するツールとして位置づけ、規制当局に説明する。その証拠としてサンドボックスを構築し、Codex CLIの承認機能で操作ごとに許可・拒否を定義する(例:grepは許可、gradleは拒否)。
- 内部不正とプロンプトインジェクション対策:サンドボックスは社内の悪意ある利用も防ぐ。プロンプトインジェクションはモデル性能の向上で脅威が下がったものの、引き続き対象とする。
- 監視:OpenTelemetryで詳細ログを取得し、インシデント発生時に追跡できるようにする。利用分析にも転用できる。
重みに学習済みの挙動そのものは自社運用でも残る点には注意が要る。米国NISTのCAISIは、DeepSeek R1-0528ベースのエージェントが米国の先端モデルより平均12倍、埋め込まれた乗っ取り指示に従いやすいと報告している。ツール実行権限を与える前に、自社でレッドチーミングを行う必要がある。
他社の事例
2025年後半から2026年にかけて、主要ワークロードをオープンモデルへ移す企業が続いている。Revolutのように自社GPUで動かす形だけでなく、推論事業者が提供するオープンモデルを使う形も多い。
| 企業 | 用途 | 移行内容 | 成果・注意点 |
|---|---|---|---|
| Harvey(法務AI) | 法務文書処理 | Claude OpusとGLM 5.1をFireworks AI上で組み合わせ | 品質を落とさず推論コストを3分の1に |
| Lindy(ノーコードAIエージェント) | エージェント基盤モデル | Anthropicから全トラフィックをDeepSeek v4へ | 数百万ドル削減、主要用途で性能も向上。ただし候補評価に6〜9か月、移行作業は想定の100倍(評価とプロンプト書き直し)。Anthropicが大幅値下げすれば戻る可能性ありと明言 |
| Detail(バグ検出) | コード解析 | ClaudeとGeminiから、ワークロードの90%を独自モデルとGLMへ | 削減額は非公表 |
| Airbnb(宿泊予約) | カスタマーサービスAIエージェント | 13モデルを併用し、主力にAlibabaのQwenを採用。OpenAIの最新モデルは本番では限定的に使用 | CEOがQwenを「速くて安い」と評価。エージェント全体で人手対応が15%減、平均解決時間は約3時間から6秒に |
| Cursor(AIコーディングツール) | 自社コーディングモデル | オープンなKimi K2.5を土台に強化学習で追加学習したComposer 2.5を提供 | 100万トークンあたり入力0.50ドル・出力2.50ドルで、先端モデル並みのベンチマークを主張 |
共通するのは「全部をオープンモデルにする」ではなく、量が多く定型的な処理をオープンモデルに、最難関の処理だけを先端モデルに振り分けるルーティング設計である。Revolutも先端モデルを例外枠として残している。
自社運用が割に合わない条件
自社運用の安さはGPU稼働率と処理の難度に強く依存し、条件が外れると商用APIより高くつく。反対方向のデータは次の3つである。
1. 高難度のコーディングでは手戻りが増える。 台湾Pegatronの技術者による2026年の実地研究では、1人の開発者が同じ本番コードベースで28日間ずつ、APIのClaude Opus 4.7/4.8と、自社Blackwell GPU上のGLM-5.1/5.2を使い比べた。修正コミットは113件から275件に増え、コミットに占める修正の割合は46%から75%に上がった(arXiv 2607.13080、DigyAiの解説経由)。
2. プロンプトキャッシュでAPIの実効単価は大きく下がる。 同じ研究では、キャッシュヒット率99.3%によりAPIコストが88.6%下がり、実効単価は100万トークンあたり0.57ドルになった。社内共有GPUの2.83ドルより安い。共有GPUの割当と人件費の前提では総コストでオンプレが40.1%安かったが、同じGPUを専用で確保するとキャッシュ込みAPIより43.8%高くなった。
3. 稼働率が低いと単価が数十倍に跳ね上がる。 同一のH100でも、出力100万トークンあたりの実効コストは負荷によって0.21ドルから15.25ドルまで変わり、アイドルに近い状態では全負荷時の36.3倍に達した。企業の典型的な負荷(毎秒1〜10リクエスト)でも2.5〜24倍高い。
Revolutの数字が成立したのは、2,000人が日中ほぼ途切れなく使い、GPUを高稼働に保てたからである。比較対象も「先端モデルのAPI定価」であり、同じオープンモデルを推論事業者経由で使う場合との比較ではない。商用APIが値下げすれば10分の1という比率は変わる。
導入判断の基準
自社運用は「全社でどれか1つを選ぶ」問題ではなく、ワークロードごとの振り分け問題として扱う。
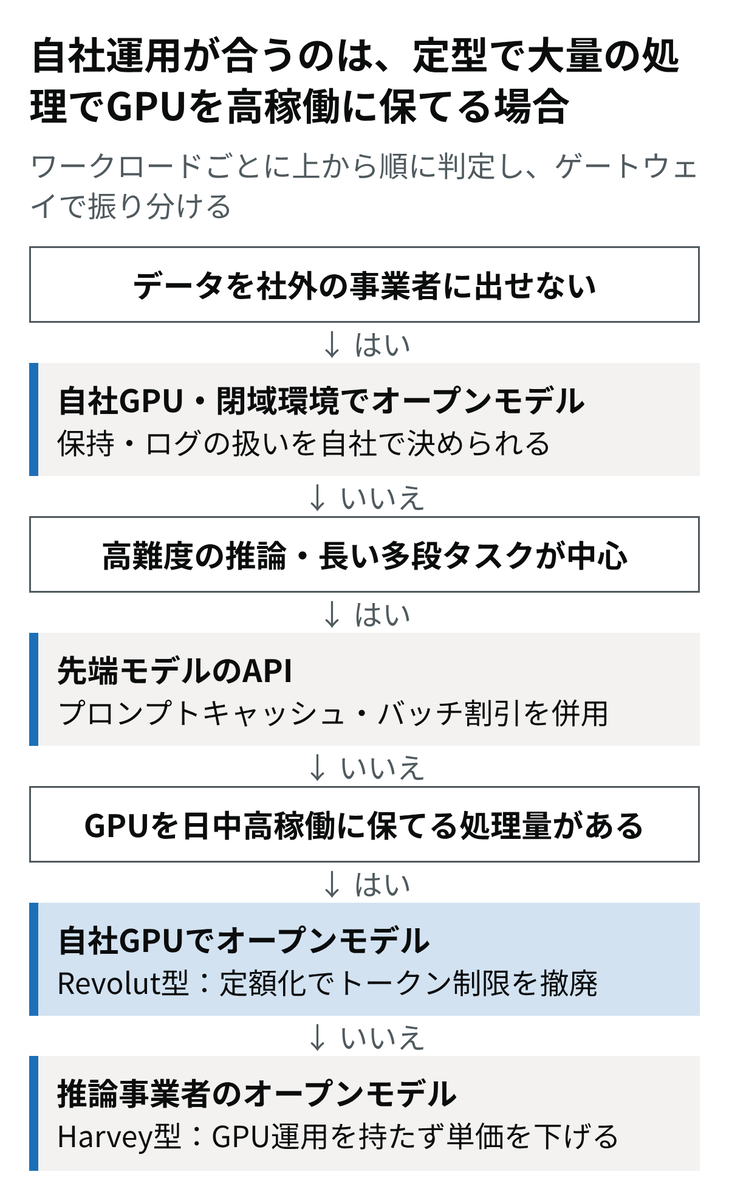
移行前に次の5点を数値で確認する。
- 月間トークン量、入力と出力の比率、ピーク時の毎秒リクエスト数、キャッシュ可能な入力の割合
- 時間帯別のGPU稼働率の見込み(夜間・休日を含む)
- 同じオープンモデルを推論事業者経由で使った場合の単価(先端モデルの定価ではなく、こちらと比べる)
- 実業務の評価セット(ツール呼び出し、長い入力、日本語を含む)での合格率と手戻り率
- 推論エンジンの脆弱性対応、障害時の予備容量、モデル更新時の再評価を担う人員
Revolutはこのうち稼働率と比較対象で有利な条件が揃っていた。Lindyのように評価とプロンプトの書き直しに想定を大きく超える工数がかかる例もあるため、置き換えは評価セットを先に作ってから進める。
関連記事
自社の業務データでモデルを訓練する方法は、次の記事で解説しています。
企業が自社モデルを訓練する時代の実装ロードマップ:Will Brown講演の解説
GPU推論基盤の監視は、次の記事で解説しています。
AI・GPUワークロードのPrometheus監視:gpu_utilの先を見る
AIエージェント時代の開発ツールは、Rexの記事でも扱っています。
出典
- How Revolut Cut AI Coding Costs 90% With Self-Hosted Open Models - David Abitbol, Revolut(AI Engineer、YouTube、2026年10月29日公開)
- 講演要約(BigGo Finance)
- Revolut says self-hosted AI cut coding costs 90%(StartupHub.ai、2026年10月29日)
- AI price war begins as costs become a key factor for OpenAI and Anthropic(DigitalToday、2026年6月14日):Harvey、Lindy、Detail
- Brian Chesky says OpenAI tools not ready(Fortune、2025年10月21日):Airbnb
- Airbnb opts for Chinese AI model over ChatGPT(MarketScreener):Airbnbの人手対応削減と解決時間
- Cursor’s new coding model Composer 2(VentureBeat)、Composer 2.5の解説(DEV Community)
- Self-Hosting LLMs in 2026: When Open-Weight Models on Your Own GPUs Pay(DigyAi、2026年10月6日):Pegatron研究(arXiv 2607.13080)、H100の負荷別コスト(arXiv 2606.11690)、NIST CAISIの評価