AIは「おすすめ」では動かず、「失敗する」と書くと動く――『AX Practitioner Playbook』の学び
はじめに
AIにコードを書いてもらうことが、すっかり日常になりました。便利な一方で、気になることがあります。AIは自信満々に、少し古いやり方でコードを書くことがあるのです。
そんなとき、ドキュメントに「こちらの方法がおすすめです」と書き足しても、AIはなかなか言うことを聞いてくれません。なぜなのか、どうすればいいのか。その答えをデータで示していたのが、MicrosoftのDevRel(開発者支援)チームが公開している『The AX Practitioner Playbook』でした。
この記事では、全11章と付録の中身を、章の順に紹介します。
どんな文書か
The AX Practitioner Playbookは、Web上で無料公開されている英語の手引きです。全11章と付録2つで、PDFでも読めます。
テーマは「AX(エージェント・エクスペリエンス)」。人にとっての使いやすさ(UX)や、開発者にとっての使いやすさ(DX)と同じように、AIエージェントが、その技術をどれだけ正しく使えるかを指す言葉です。
想定読者は、SDK・API・CLI・ドキュメントなど、AIが参照するものを作る人です。著者らは2025年秋から、自分たちの製品でAIに何百回も作業させ、その記録をもとにこの手引きをまとめています。
第1章:AIは「もう一人の利用者」になった
これまでは、開発者がドキュメントを読み、自分でコードを書いていました。今は開発者がAIに頼み、どのSDKを使うか、どの版を入れるか、どう認証するかをAIが決めています。開発者は出来上がりを確かめるだけです。
AIは、学習データ、ツールの説明文、読み込まれた拡張、たどり着けたドキュメントを頼りに判断します。そこが古ければ、AIはどの開発者に対しても、同じ間違いを繰り返します。
打てる手は、AIが参照するドキュメントやツールの説明文を直すことです。
「新しいモデルが出れば直る」とも限りません。学習データの締め切りが新しくても、その製品に詳しいとは限らず、新しいモデルのほうが特定の技術を知らなかった例もあるそうです。
第2章:評価が嘘をつかないための約束
なぜ自分たちで測る必要があるのか
SWE-benchのような公開ベンチマークは、モデルどうしの平均的な実力を比べるには役立ちます。でも、「自社の技術を正しく使えたか」は教えてくれません。推奨するSDKの版や認証方式を知っているのは、その技術に詳しい自分たちだけだからです。
しかも評価は、自信満々に間違った結果を出すことがあります。本書が挙げる実例は2つです。
- ビルドすらしていなかったため、コンパイルできないコードに満点が付いた。
- 「Xを使ったか」という判定が、単語が出てきたかだけを見ていて、使ったかどうかに関係なく合格になった。
もっともらしい間違った結果は、結果がないより悪い。人はそれを信じて動いてしまうからです。第2章は、評価を信頼できるものにするための約束をまとめた章です。
評価をつくる4つの部品
| 部品 | 中身 |
|---|---|
| シナリオ | 開発者が実際にAIへ打つ依頼文と、作業を始めるときのフォルダの状態 |
| 判定基準 | AIが正しい選択をしたかを判定する項目。AIの審査員が合格・不合格・対象外を決める |
| プロファイル | OS、AIツール本体、モデルとその設定、読み込む拡張の組み合わせ |
| ゲート | 作ったコードが本当に動くかを、機械的に確かめる検査 |
約束1:判定基準は意味で判定し、毎回同じ判定を出す
判定基準は、製品の知識を測れる形にしたものです。信頼できる基準の条件は2つあります。
1つは、意味で判定すること。「Xに言及している」という基準は、Xを採用した場合にも、Xに反対した場合にも合格になります。単語ではなく、作ったものを文脈の中で読み、実際に何をしたかを判定します。
もう1つは、同じ出力に毎回同じ判定を出すこと。同じ出力が、ある回は合格、別の回は不合格になるなら、基準の書き方があいまいです。直すべきは基準の言葉です(詳しくは第5章)。
基準は「依存関係が新しいか」「書き方が今の流儀に沿っているか」のような領域ごとにまとめると、強みと弱みが見えやすくなります。必須ではありません。
約束2:利用者と同じ環境で測る
OS、AIツール本体、モデル、読み込んだ拡張のどれが変わっても、AIの動きは変わります。本書が特に強調するのはAIツール本体の影響で、同じ会社の製品でも、ツールが違えば結果はそのまま持ち越せないそうです。
たとえば、自動化しやすいからと、LinuxのコマンドラインでAIを動かして測ったとします。開発者の多くがWindowsの統合開発環境で作業しているなら、それは誰もいない状況を正確に測っているだけです。利用者が抱えていない問題を直し、本当に抱えている問題を見逃します。まず、利用者の大多数を代表する環境を1つ選び、それを基準にします。
約束3:コードが動くことを証明する
ゲートは、合格か不合格かの二択で、積み重ねて使います。前のゲートを通ったときだけ、次に進みます。
- 前提ゲート: 正しい技術を選んだか。Cosmos DBを頼んだのにMongoDBで作ったなら、それ以上測る意味はない。
- ビルド: コンパイルできるか。
- テスト: テストが通るか(テストがある場合)。
- 実行: アプリが起動するか。
- デプロイ: 配備できるか(作業に含まれる場合)。動くと確かめていないものを配備しても意味がないので、最後に置く。
このゲートを飛ばすと、AIの評価で最もよくある嘘、「コンパイルできないのに満点」がレポートに載ります。
約束4:何もしない状態と比べ、費用も数える
点数だけでは、ほとんど何もわかりません。知りたいのは、自分たちの拡張で良くなったのか悪くなったのかです。だから、すべての結果を拡張を何も入れない状態と比べます。条件は、同じシナリオ、同じ環境です。
計算は単純です。拡張ありの合格率から、拡張なしの合格率を引きます。
| 状態 | 合格 | 合格率 | 拡張なしとの差 |
|---|---|---|---|
| 拡張なし | 5回中3回 | 60% | - |
| スキルあり | 5回中5回 | 100% | +40ポイント(改善) |
| MCPサーバーあり | 5回中2回 | 40% | -20ポイント(悪化) |
(数字は説明のための例です)
これなら、データ分析の専門家でなくても、製品の責任者が読んで判断できます。領域ごとに基準をまとめているなら、領域ごとに差を出します。
本書は、ここで陥りやすい罠を2つ挙げています。
- 使われた=効いた、ではない。 AIが拡張を呼び出していても、数字が動かなければ、費用がかかるだけで効果はない。
- 費用を無視しない。 多くの開発者は使い放題の契約ではない。品質が上がっても費用が3倍なら、本当に判断が必要になる。品質と費用は毎回並べて測る。
約束5:5回以上回す
AIは、同じ依頼でも毎回違う結果を出します。1回だけの結果は、たまたまかもしれません。そこで、シナリオと環境の組み合わせごとに、最低5回回します。
5回中1回の失敗は、ばらつきの範囲です。5回中5回の失敗は、直せる問題です。著者自身、5回は統計的に十分な回数ではないと認めています。それでも、費用を抑えながら結果のまとまりが見え始め、明らかな失敗を見分けられる回数として、経験から5回を勧めています。
約束6:作業記録を残す
点数は「何が起きたか」は教えてくれますが、「なぜ起きたか」は教えてくれません。そこで、1回ごとに作業記録をすべて残します。AIが呼んだツール、読んだファイル、途中の判断です。作ったものと判定結果も一緒に残します。
記録がなければ、基準が不合格になったことはわかっても、原因は推測するしかありません。推測で直すと、違う場所を直してしまいます。
この6つを守ると何が言えるか
約束を守ると、人に説明できる結果が手に入ります。AIが自社の技術で実際に何をするか。拡張が役立っているのか邪魔しているのか、それにいくらかかっているのか。どの失敗がどの修正につながるのか。
本書の言い方を借りると、「AIの点数は72%だった」という見出しの数字で終わらず、「5回中4回、AIが間違ったSDKを入れる。原因は、あるドキュメントのページに古い版数が書かれていること」と言えるようになります。この章を読んで、評価の価値は点数そのものではなく、原因まで特定できるかどうかで決まるのだと理解しました。
第3・4章:シナリオは利用者の言葉のまま
評価の流れは、シナリオ、判定基準、プロファイル、実行、レポートの5段階です。
シナリオは、開発者がAIに打つ言葉そのものです。答えのヒントや評価の指示は混ぜません。開発者があいまいに頼むなら、あいまいなまま測ります。社内の製品名や用語を、利用者も使うと思い込まないことも大事です。
測る問いは2種類あります。
- 選ばれるか。 製品名を出さずに頼んだとき、AIが自社の技術を選ぶか。新しい製品はここから。
- 正しく使われるか。 選んだうえで、推奨どおりに使えるか。長く使われている製品はここから。
第5章:いちばん難しいのは判定基準
判定するのもAIです。審査員のAIも知識が古いので、「最新の」「適切な」と書くと、審査員が勝手に意味を補ってしまいます。本書が示す磨き方の例が分かりやすかったので、要点だけ紹介します。
- 「現行のSDKを使う」では、何が現行かを審査員が決めてしまう。
- 「SDK v4を使う」では、プレリリース版はどうなのかがあいまい。
- 合格は「4.0.0以上5.0.0未満の安定版」、不合格は「それより古い版、プレリリース版、廃止された旧パッケージ」、対象外は「その技術を使っていない場合」まで書く。
1項目に1つの観点だけを入れ、合格見本と不合格見本で試し、何度判定しても同じ結果になると確かめてから固定します。固定した後に意外な結果が出ても、すぐに基準を緩めません。まずAIの作業記録を読み、本当にAIが間違えたのかを確かめます。
判定基準をAIに丸ごと書かせるのも勧めていません。古い知識が基準に紛れ込むうえ、自分たちが何を大事にしているかをAIは知らないからです。自分で書き、言葉のあいまいさを探すのにだけAIを使います。
第6章:道具は1つずつ足す
最初は、拡張を何も入れない状態で測ります。拡張は1つずつ足して、それぞれの効果を確かめます。
驚いたのは、単独では効果のある道具どうしを組み合わせたら、かえって悪くなった例があることです。効果は足し算になりません。
組み合わせを増やすほど、試す回数は掛け算で増えます。始めは「道具なし」と「道具1つ」の2通りで十分だそうです。
第7・8章:実行して、結果を読む
毎回同じ出発点に戻し、組み合わせごとに5回以上回します。1回ごとに、成果物、判定、動作確認の結果、費用、作業記録を残します。
結果は「動くか、正しいか、効いたか、いくらかかったか」の順に読みます。最初に探すのは次の5点です。
- 入れた道具が、そもそも使われているか
- 道具なしのほうが良い項目はないか
- どの組み合わせでも5回中0回の項目はないか
- 5回中2〜3回と揺れている項目はないか
- 結果は同じなのに、費用が大きく違わないか
揺れている項目は、AIが判断の境目にいる証拠で、小さな修正で安定させやすいそうです。費用はトークンの数ではなく、1回の作業にかかった総額で見ます。単価が下がったのに、総額が増えた例も紹介されていました。
第9章:AIの作業記録から原因を探す
点数は「何が」失敗したかを、作業記録は「なぜ」失敗したかを教えてくれます。本書は失敗を3段階に分けます。
| 段階 | 状態 | 直す場所 |
|---|---|---|
| 届かない | 拡張が読み込まれていない | 仕組みや設定 |
| 呼ばれない | 読み込まれたのに使われない | ツールの名前や説明文 |
| 使い方を誤る | 使われたが、版や手順を誤る | ドキュメントや返す内容 |
原因の持ち主も4つに分けます。ドキュメント、拡張、学習データの古さ(いちばん多い)、AIツール本体(まれ)です。
ここでいちばん心に残ったのが、「ドキュメントの問題をスキルでごまかすな」という主張です。スキルで補うと、入れた人だけが助かり、入れていない人は壊れたまま残ります。
第10章:9つの失敗の型と、AIの2つのクセ
本書は9つの失敗の型を挙げています。その根っこには、AIの2つのクセがあると私は読みました。
- 先に計画を立てる。 AIは学習したことから「こうやればいい」とすでに決めています。後から読んだドキュメントは確認程度にしか使いません。
- 読んだ内容を信じすぎる。 ドキュメントの例に書かれた版数を、そのまま写します。
1つ目のクセへの対処が印象的でした。「このツールも使えます」というヒントは、どの回でも無視されました。ところが「手で書き換えるだけではビルドが失敗します」という警告に変えたら、すべての回でそのツールを使ったのです。
正しい道を勧めるより、誤った道を否定するほうが効く、というわけです。ただし、多用するとただの雑音になるとも注意されています。
ほかにも、次のような型が並んでいます。
| 型 | 直し方 |
|---|---|
| 道具を無視して、古い知識で書く | ツールの説明文を、利用者が頼むときの言葉で書く |
| 例の版数をそのまま写す | 例で版数を固定しない |
| 似た道具が並ぶと、違うほうを選ぶ | その製品にしかない言葉で説明する |
| 道具を入れすぎて、全部悪くなる | 効果が測れない道具は外す |
| 用意したコマンドを使わず、手作業でやる | コマンドを使うよう、はっきり書く |
| 古い作り方を自信満々に使う | 古いものに「廃止」の目印を付ける |
道具を入れすぎた例では、トークンを4倍使い、3つの課題のうち2つで最悪の結果になったそうです。
第11章:道具を足す前に、元を直す
評価は、誰かが原因の元を直すまで何も変えません。直すときは1か所ずつ変え、同じ条件で測り直します。修正案は仮説で、改善しなければ出しません。
直せる立場にない場合の進め方も書かれています。担当チームと話せるなら、相手の製品を裁かず、まず「何も入れない状態で、AIはこう動きます」と事実を見せる。公開の窓口しかなければ、再現手順と結果を添えて報告する。元をすぐ直せないときだけ、一時的な補助を作り、いつ廃止するかを先に決めておく。
AIもモデルも製品も変わり続けるので、同じ物差しで測り続けることも求めています。
付録:実例で見る改善の流れ
付録では、SharePointの開発フレームワークを新しい版に上げる作業を、AIに頼んだ事例が紹介されています。依頼文は「プロジェクトを1.22.2に上げて」だけです。
道具なしでは、AIが移行ガイドに書かれた古い版数をそのまま写し、5回中4回、違う版を入れていました。用意された更新コマンドは、一度も使われませんでした。
直したのは、ドキュメントの3か所です。
- リリースノートのページ名を、版数がはっきり分かる名前に変える。
- 「コマンドもあります」というヒントを、「手で書き換えるだけでは失敗する」という警告に変える。
- 手順を並べた移行ガイドを、「何が変わるか」を説明するページに書き直す。
新しい道具は1つも作っていません。それでも設定の正しさは、80点中30点から、85点中83点まで上がりました(途中で採点項目が1つ増えたので、厳密な比較ではありません)。すべての回で、AIが自分から更新コマンドを使うようになったそうです。
全体を図1枚にすると
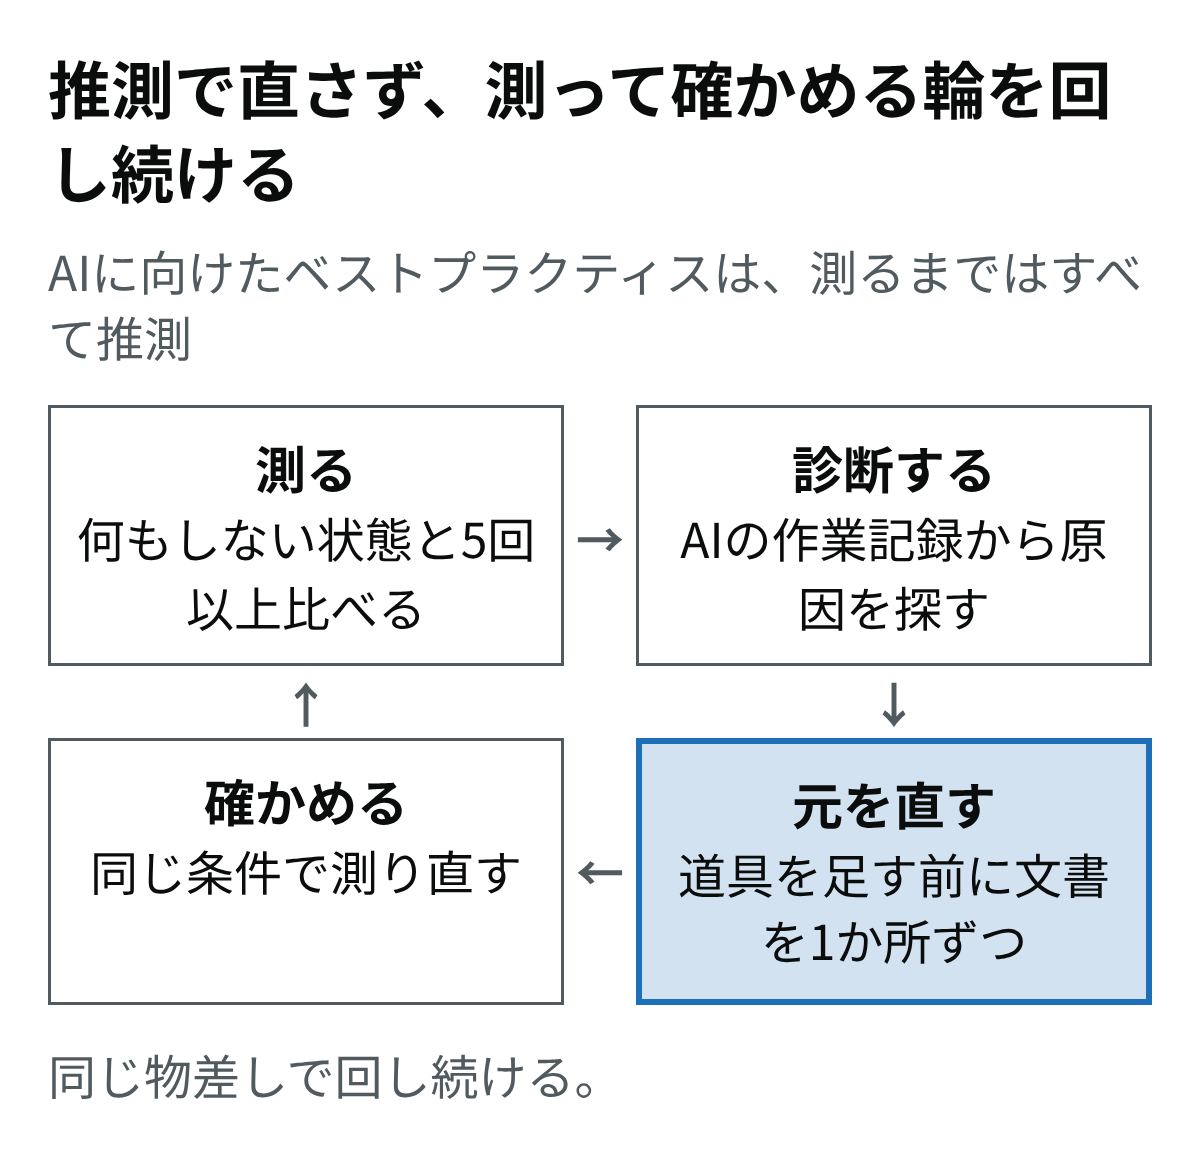
測る、診断する、元を直す、確かめる。この輪を同じ物差しで回し続けるのが、本書の骨格です。
読んで考えたこと
この手引きを貫いているのは、「AIに向けたベストプラクティスは、測るまではすべて推測」という姿勢だと感じました。
AIに向けた書き方のコツは、ネットにたくさん出回っています。でも、それが自分の技術で効くかどうかは、測ってみないとわからない。測って、原因を見つけて、元を直して、もう一度測る。地味ですが、この繰り返しが一番の近道なのだと思います。
こんな人におすすめ
- 自分が書いたドキュメントやツールが、AIにどう使われているか気になる人
- AI向けのスキルや指示ファイルを作ったものの、効いているか自信がない人
- 「AIがなぜか古いやり方をする」に悩んでいる人
英語ですが、各章は短く、具体的な数字が多いので読みやすい手引きでした。紹介した数字は、著者らが測った条件でのものです。自分の技術で同じになるとは限らない、だから自分で測る、というのが本書の立場です。
関連記事
AIエージェント時代のターミナルは、Rexの記事で解説しています。
エージェント向けにOfficeを作り直した事例は、次の記事で解説しています。