AIエージェントのハーネスを自動で改良する方法|機能と安全性を両立させる「Harmony Harness」論文を解説
AIエージェントに自分の仕組みを自動で改良させるとき、「機能」と「安全性」を合算せずに低い方の指標を基準に改良を続け、部品を「汎用部分」と「環境固有部分」に分けて管理すると、初めての課題でも安全性が崩れにくくなる。それが今回読んだGoogle Cloud AI Researchなどの論文「Harmony Harness」(2026年10月10日公開)の結論です。
この記事で分かることは3つです。
- AIエージェントの「ハーネス」とは何か、なぜそれを自動で鍛える研究が増えているのか
- 「1つの点数だけで鍛える」と何が起きるのか、この論文はどう解いたのか
- 数字をどこまで信じてよいか(点数稼ぎの実例と、読むときの注意点)
AIエージェントのハーネスとは:自己進化の前提
AIエージェントの実力は、モデルそのものだけでなく「ハーネス」で大きく変わります。ハーネスとは、LLM(大規模言語モデル)を包む周りの仕組み全体のことです。
具体的には、次のような部品が含まれます。
- システムプロンプト(最初に渡す指示書)
- 道具(ファイルの読み書き、コマンド実行など)
- 作業の繰り返し手順(考える→道具を使う→結果を見る→また考える)
- 検証の関門(テストを通すまで完了としない、など)
- 全体の段取り(どの工程をどの順で動かすか)
Meta-Harnessの論文は、同じLLMでもハーネス次第で性能に6倍もの差が出ると指摘しています。それなのに、ハーネスはほとんど人間が手で作ってきました。
そこで出てきたのが「自己進化」です。モデルの中身はそのままに、AI自身が実行結果を見てハーネスを改造していきます。ここ数年の主な研究は次のとおりです。
| 研究 | 発表 | 何を改良するか | 主な結果 |
|---|---|---|---|
| ADAS | 2024年8月 | メタエージェントが新しいエージェントをコードで書き、過去の発見を書庫に貯める | 作られたエージェントが別分野・別モデルでも強さを保った |
| Darwin Gödel Machine | 2025年5月 | コーディングエージェントが自分のコードを書き換え、全世代を保存 | SWE-benchで20.0%→50.0%、Polyglotで14.2%→30.7% |
| GEPA | 2025年7月 | プロンプトを、失敗の振り返りと問題ごとの最良案の集合を使って進化 | 強化学習(GRPO)より平均6ポイント高く、試行回数は最大35分の1 |
| Meta-Harness | 2026年3月 | 過去の全候補のコード・点数・実行ログを読んでハーネス全体を書き換え | TerminalBench-2で人手の最良ハーネスを上回った |
どれも成果を上げていますが、共通して「1つの点数(主にテスト合格率)」を上げるために鍛えています。今回の論文が問題にしたのは、まさにそこです。
問題:1つの点数で鍛えると、機能と安全性が両立しない
既存手法は、鍛えた課題では安全性が上がっても、初めての課題ではその伸びの大半を失いました。論文はその原因を2つ挙げています。
弱点1:機能と安全性のトレードオフを扱えない
コードを書くAIには、「動くこと(機能)」と「攻撃に強いこと(安全性)」の2つが求められます。一見、同じ方向を向いているように見えます。
しかし、ハーネスを変更すると、一方を上げると他方が下がる関係(トレードオフ)が生じることがあります。たとえば検証を緩めるとテスト合格率は上がりますが、脆弱なコードも通過します。検証を厳しくすると安全性は上がりますが、本来必要な処理まで拒否してしまいます。
2つの指標を足し合わせて1つの点数にすると、このトレードオフが合計点に隠れてしまいます。安全性が下がっても、機能がそれ以上に上がって合計点が増えれば、その変更は採用されます。また、「安全性は一定値以上」という条件を課す方式では、条件を満たした時点で、それ以上安全性を高める変更が評価されなくなります。
弱点2:汎用的な改良と環境固有の改良が区別されない
既存手法の多くは、ハーネスを一つの塊として丸ごと書き換えます。すると、汎用的な工夫と、その試験だけで効く工夫が、同じコードの中に区別なく混ざります。
論文の例です。「コンテナの中でコードを動かして確かめる」のはどこでも使える工夫です。一方、「どのイメージを使うか、いつ片付けるか」はその試験の作法次第です。長いログを短く切り詰めるのも汎用的ですが、どこを捨ててよいかはログの種類で変わります。
両者を同じ点数で区別せずに改良すると、評価に使った課題でだけ点数が高いハーネスができあがります。機械学習でいう過学習と同じ状態です。
Harmony Harnessの全体像
Harmony Harnessは、この2つの弱点に3つの仕組みで対応します。全体の流れは次のとおりです。
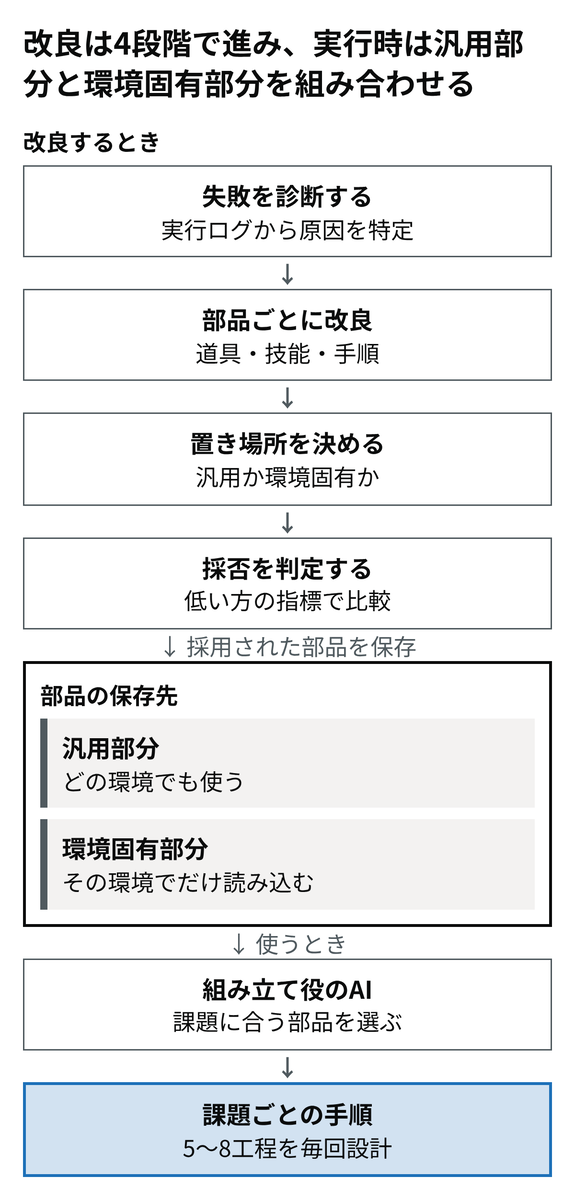
仕組み1は「採否を判定する」段階、仕組み2は「部品ごとに改良」「置き場所を決める」段階と部品の保存先、仕組み3は「使うとき」の組み立てにあたります。
仕組み1:多目的最適化で、低い方の指標を基準に候補を比べる
Harmony Harnessは、機能と安全性を合算せず、2つのうち理想値から最も離れている指標で候補を比べます。そのため、低い方の指標を改善しない変更は採用されにくくなります。
まず「パレート最適」
指標が2つあると、「一番良い案」は1つに決まりません。機能は高いが安全性は低い案と、その逆の案があるからです。
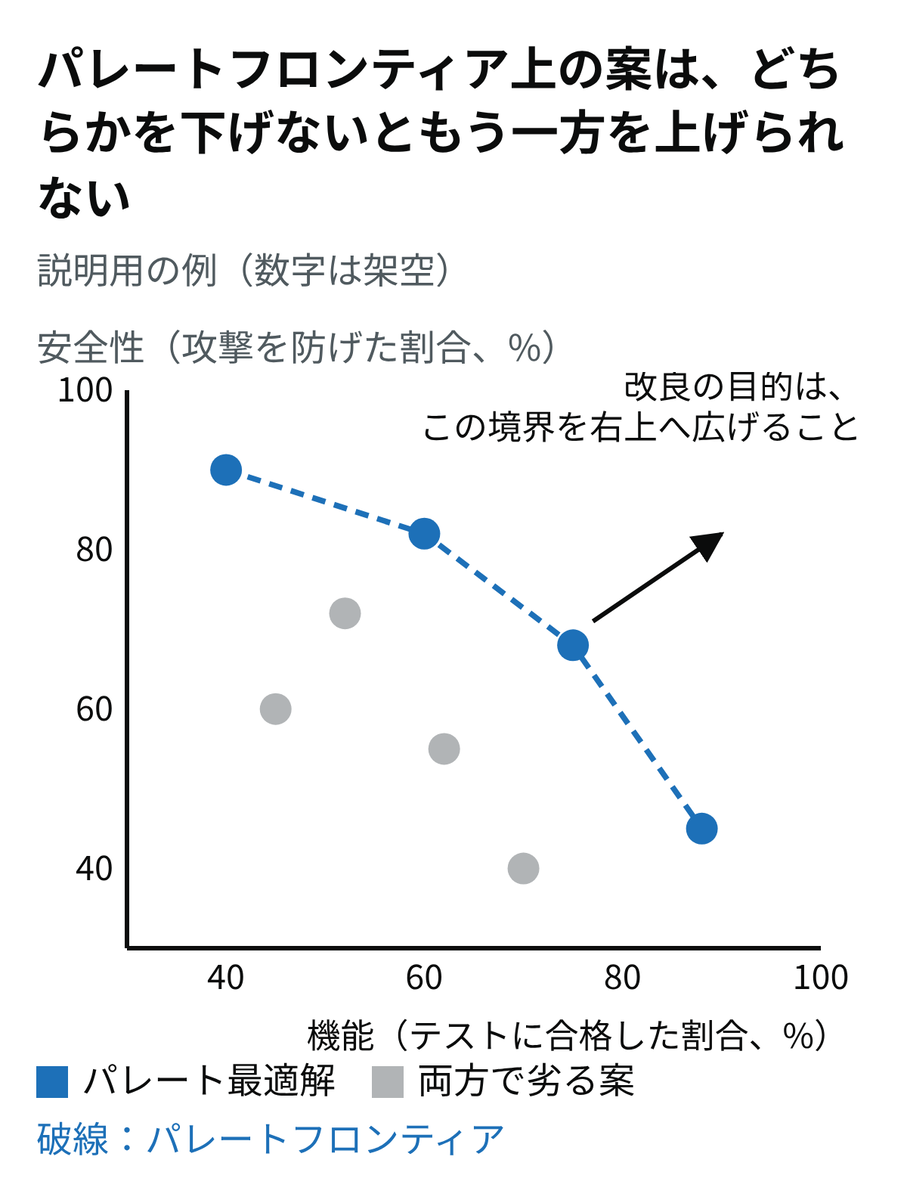
そこで、「どちらかの指標を下げない限り、もう一方を上げられない案」の集合をパレート最適解と呼び、その集合が作る境界をパレートフロンティアと呼びます。両方の指標で他の案を下回る案は、パレート最適解に含まれません。自己進化の目的は、パレートフロンティアをより高い性能の側へ広げることです。
平均で比べる方法と、低い方の指標で比べる方法の違い
2つの指標の平均で比べると、一方が大きく下がっても、もう一方が十分に上がれば高く評価されます。低い方の指標で比べると、一方を犠牲にした案は高く評価されません。後者の比べ方を重み付きチェビシェフ法といいます。
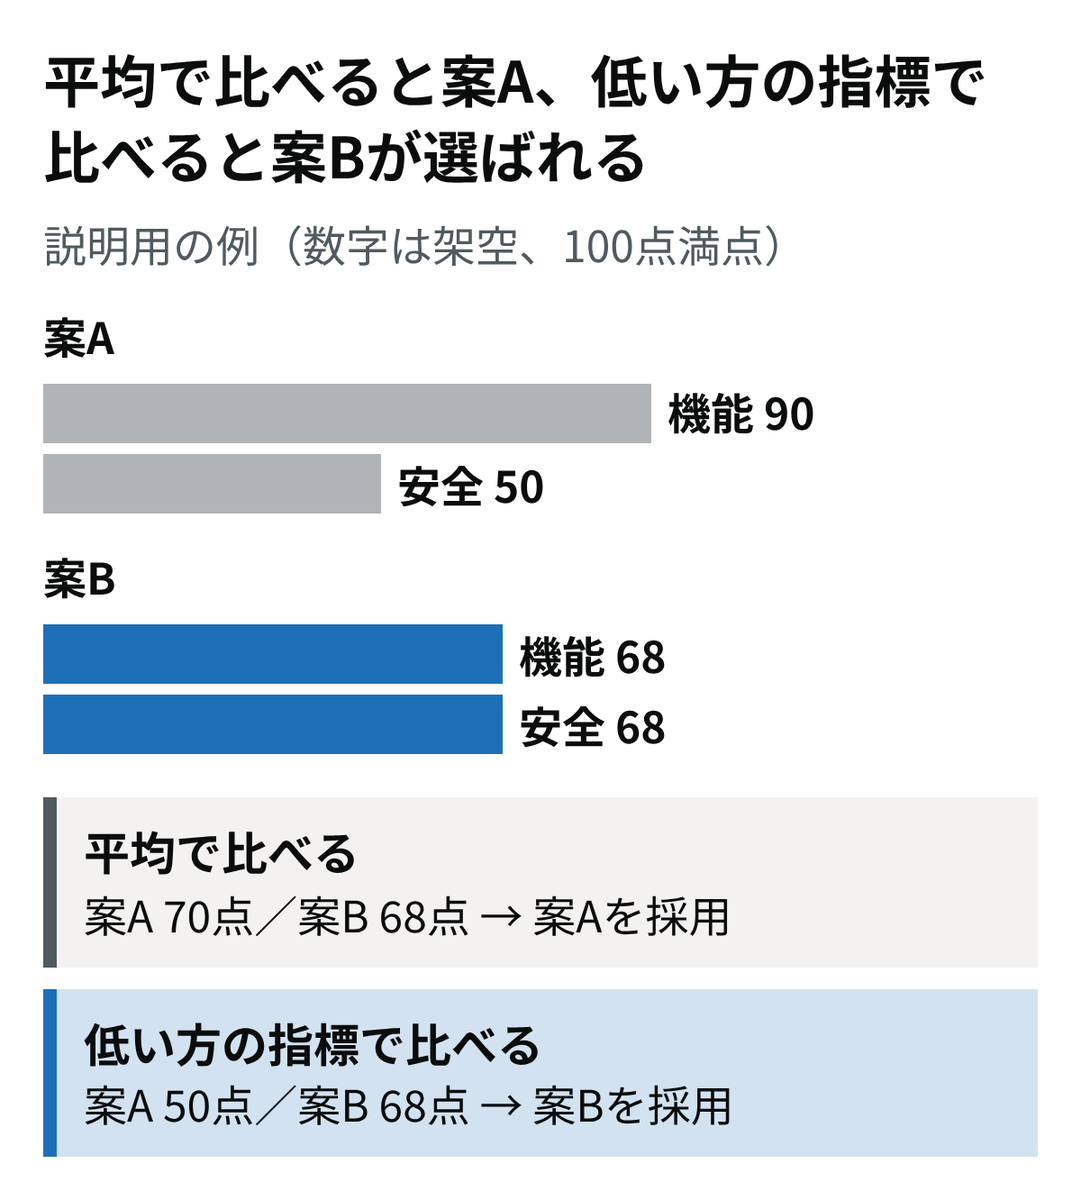
平均で比べると安全性の低い案Aが選ばれ、低い方の指標で比べると両方が同水準の案Bが選ばれます。論文の実験でも、平均点方式(重み付き和)は安全性73.3%で頭打ち、この方式は93.3%まで伸びました。
重みの異なる部分問題に分けて探索する(MOEA/D)
土台は、2007年にZhangとLiが発表した多目的の進化計算「MOEA/D」です。最適化ライブラリOptunaにも実装がある定番の方法です。
やり方はこうです。
- 機能と安全性の重みの組み合わせ(機能重視から安全性重視まで)を5〜6通り用意し、それぞれを1つの部分問題とする
- 各部分問題は、その重みで現時点の最良のハーネスを1つ保持し、それを改変した新しいハーネスを作る
- 新しいハーネスが優れていれば、重みが近い部分問題の最良ハーネスも置き換える(最大2つまで)
- 最後に、生成したすべてのハーネスの中から、低い方の指標が最も高いものを1つ採用する
部分問題ごとに重みが異なるため、保持される候補も重みに応じて異なるものになります。他の進化手法は「コードがどれだけ違うか」で多様性を測りますが、ハーネスではその物差しが効きません。論文の分析では、コードの差と点数の差の相関は+0.03で、ほぼ無関係でした。
保持する候補の数が部分問題の数に限られることも利点です。改良を行うAIに渡す履歴が増え続けることを防げます。
仕組み2:汎用部分と環境固有部分を分けて管理する
Harmony Harnessは、改良した部品を、どの環境でも使える「汎用部分」と、特定の評価環境でだけ使う「環境固有部分」に分けて保存します。これにより、新しい課題でも性能が落ちにくくなります。
環境固有の情報が汎用部分に混ざると、別の環境ではその情報が誤りとなり、性能を下げる原因になります。
部品を3種類に分けて、担当外は触らせない
ハーネスの改良は、次の3種類の部品に分けて行います。各部品の改良処理は対応するフォルダにしか書き込めず、外に書いた変更は自動で取り消されます。
- 道具:コードのビルドや実行、ファイル編集など、実際に何かを確かめる仕組み
- 技能:再利用できる手順やコツ(きっかけ、短い手順、具体例1つのセット)
- 手順:プロンプト、検証の関門、作業の流れ、全体の段取り
改良前には、まず失敗のログから原因を診断し、「こう直せば良くなるはず」という仮説を立てます。診断で引用した証拠は、実際のログに同じ文字列があるか機械的に照合されます。
置き場所を決める問いは1つだけ
各改良を汎用部分と環境固有部分のどちらに置くかは、「その知識は、エージェントが実行時に自分で調べられるか?」で決めます。
- 調べられる → 汎用部分に置く。ポート番号やフレームワーク名など、その試験だけの事実を書き込むことは禁止
- 調べられない(採点のルールなど) → 環境固有部分に置く。ファイルの先頭に、どの試験向けかを明記
- 判断に失敗したとき → 制約の厳しい汎用部分に置く
置き場所そのものも見直す
置き場所の誤りを修正する専用の操作(generalize)もあります。この操作は新しい機能を足さず、置き場所の誤りを1回に1か所だけ直します。
| 直し方 | どんなとき | 何をするか |
|---|---|---|
| 昇格(環境固有→汎用) | 中身は汎用的なのに環境固有部分にある | 汎用部分へ移し、試験固有の事実は実行時に調べる形に書き換える |
| 降格(汎用→環境固有) | 汎用部分に、実行時に調べられない固有の事実が埋め込まれている | その事実だけを環境固有部分の設定へ移す |
| 実行時取得 | 汎用部分に、実行時に調べられる固有の事実が埋め込まれている | 汎用部分に置いたまま、その場で調べる形に書き換える |
直したあとも、今の試験での振る舞いは変わらないこと、汎用部分だけでも動作することが約束されています。6問の小規模な検証では、この操作を加えると最高成績が83.3%→100%、66.7%→83.3%に上がりました(どちらも1問分の差なので、方向性を示す結果です)。
比較対象のDarwin Gödel Machineでは、評価用の課題の傾向をそのまま暗記した改良が繰り返し見つかりました。たとえば「どの課題も同じ種類の範囲外読み取りのバグだ」と決めつけて直す改良です。Harmony Harnessの実行では、こうした痕跡は見られなかったと報告されています。
仕組み3:課題ごとに手順を組み立てる
実際に課題を解くときは、「組み立て役」のエージェントが課題を読んで、使う部品と工程の順番を毎回設計します。固定手順と比べ、トークン(計算量)は8%増えただけで、安全なコードを書けた割合は53.6%から64.3%に上がりました。
この設計図は「DAG(有向非巡回グラフ)」と呼ばれる形式です。工程を矢印でつないだ図で、矢印は一方向であり、同じ工程に戻る循環を含みません。互いに依存しない工程は並列に実行できます。
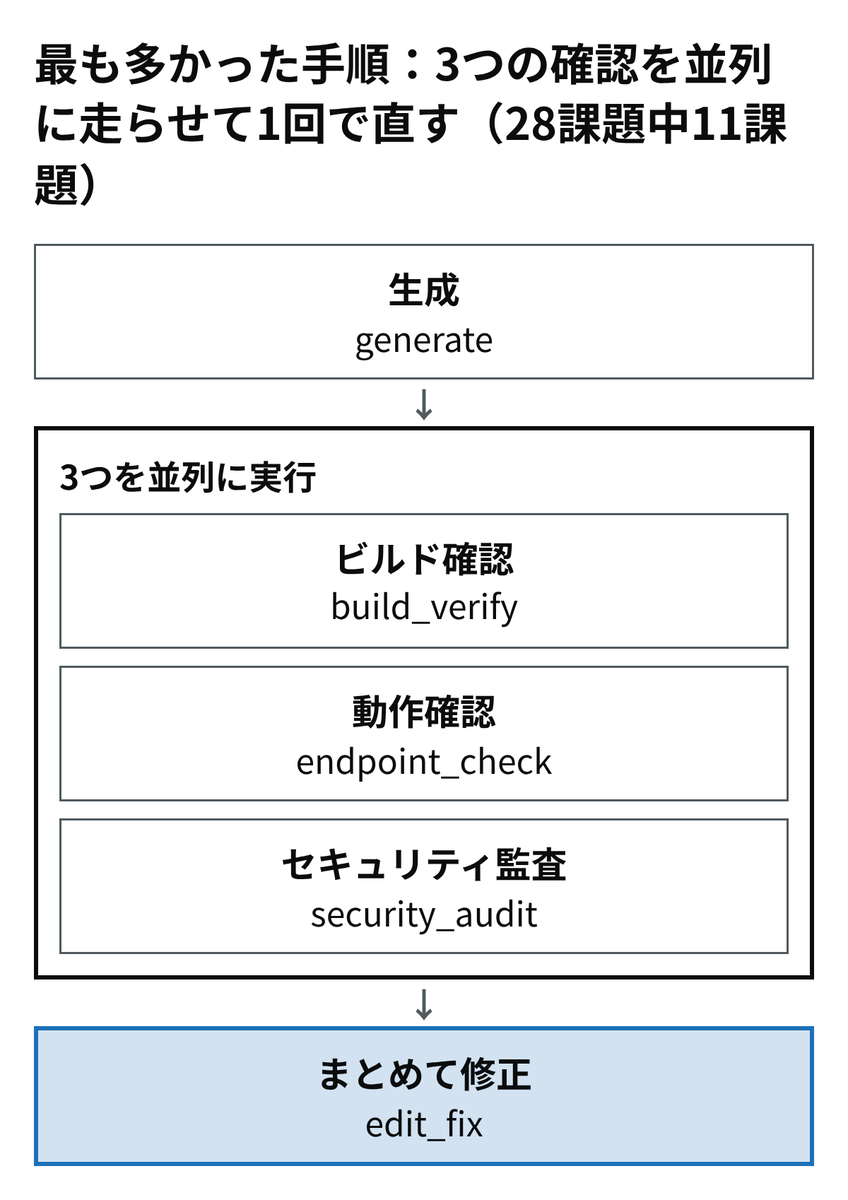
コードを生成したあと、ビルド確認・動作確認・セキュリティ監査を同時に走らせ、結果をまとめて修正します。この形は28課題のうち39%で使われました。
難しい課題では6〜8工程に増えます。たとえば「前の確認が失敗したときだけ、シェルで調べて修正をやり直す」といった条件付きの工程が入ります。28課題で、形の違う計画が7種類作られました。
固定手順だと、全課題で余分な工程を払うか、難しい課題で工程が足りないかのどちらかになります。組み立て役は必要なところにだけ手間をかけます(平均工程数5.0→6.2)。
なお組み立て役が読み込むのは、汎用部分と、現在の環境の環境固有部分だけです。新しい環境では汎用部分だけが使われるため、他の試験向けの調整が混ざりません。
結果:未知の課題で差が開く
一番の成果は「鍛えたあと、初めての課題でも安全性が残る」ことです。既存手法は鍛えた分の安全性の伸びを0〜34%しか持ち越せませんでしたが、Harmony Harnessは50〜55%を持ち越しました。
どんな試験で測ったか
題材は「安全なコードを書く」課題です。機能はテストを通るか、安全性は実際の攻撃コード(概念実証のエクスプロイト)を防げるかで、どちらも実際に動かして判定します。攻撃コードは解いている最中のAIからは見えません。
- SecRepoBench:実在のC/C++リポジトリで、伏せられたコード部分を、既知の脆弱性を入れずに埋める
- BaxBench:バックエンドのアプリを丸ごと作る
- CWEval:自然文の仕様から関数を1つ書く(持ち出しの確認専用、5言語357問)
課題は「鍛える用」「同じ傾向の未知問題」「傾向の違う未知問題」の3つに分け、各分割は30問(BaxBenchは28問)です。未知の2分割は、改良の途中では一度も使いません。モデルは改良役も解く役もgemini-3.6-flashです。
主な数字
「動いて、かつ安全」なコードを書けた割合(3分割の平均)を比べます。比較相手のMeta-HarnessとDarwin Gödel Machineは、著者たちの公開コードをそのまま使っています。
| 試験 | 改良前 | 既存手法の最良 | Harmony Harness |
|---|---|---|---|
| SecRepoBench | 44.4% | 51.1% | 76.7% |
| BaxBench | 42.9% | 52.4% | 61.3% |
「鍛えた分」は未知の課題にどれだけ残るか
残存率は、「未知の課題での安全性の伸び」÷「鍛えた課題での安全性の伸び」です。マイナスは、鍛えたせいでかえって悪くなったことを意味します。
| 手法 | SecRepoBench | BaxBench |
|---|---|---|
| Meta-Harness(機能だけで鍛える) | −103% | −197% |
| Meta-Harness(安全だけ) | 25% | 20% |
| Meta-Harness(両方) | 20% | 25% |
| Darwin Gödel Machine(1つの点数に合算) | 0% | 34% |
| Harmony Harness | 55% | 50% |
面白いのはDarwin Gödel Machineです。SecRepoBenchでは鍛える用の課題で安全性を既存手法で最も伸ばしたのに、未知の課題では伸びがゼロでした。「鍛えた課題での伸びが大きいほど、未知の課題では残らない」という逆転が起きています。
どの工夫が効いたか
仕組み2と3を1つずつ足していくと、未知の課題での成績は次のように変わりました。
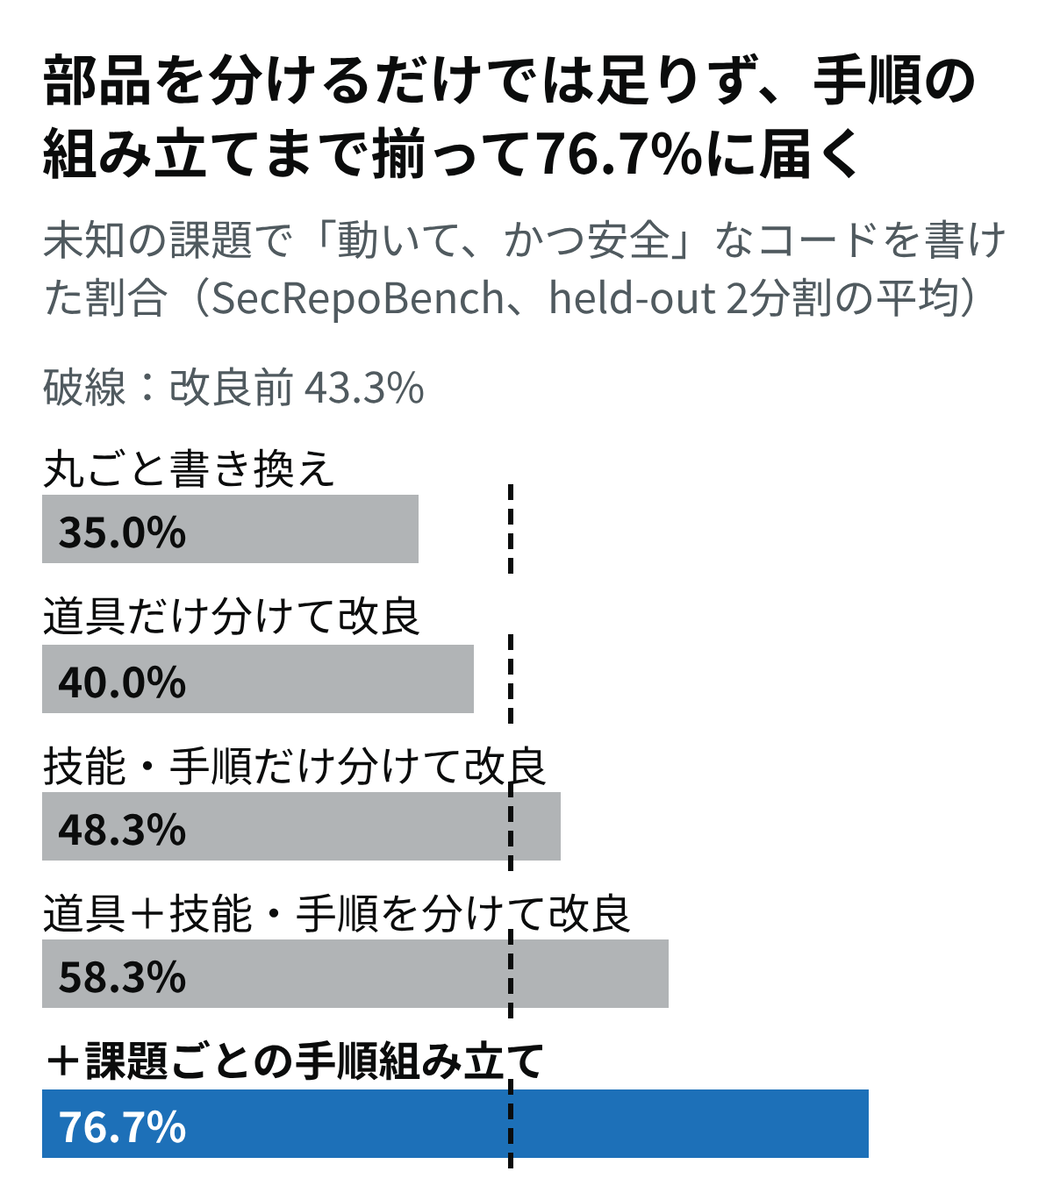
丸ごと書き換えるやり方は、改良前より悪化しました。どれか1つの工夫ではなく、組み合わせて初めて大きく効いています。
比べ方(仕組み1)だけを入れ替える実験でも、差は機能より安全性に出ました。平均点方式と順番に1つずつ鍛える方式はどちらも70.0%、合格ライン方式は60.0%で、本手法は76.7%でした。機能だけ、安全だけを別々に鍛えて後で合体させると、53.3%にとどまりました。
別の試験へそのまま持ち出す
片方の試験で鍛えたハーネスを、もう片方にそのまま持ち込んだ結果です。Meta-Harnessはどちらの向きでも改良前を下回りました(42.9%→39.3%、46.7%→36.7%)。Harmony Harnessは42.9%→57.1%、46.7%→70.0%と、どちらも上回りました。
さらにBaxBenchで鍛えたハーネスを、課題の形式も違うCWEvalで試すと、「動いて安全」の割合は87.4%でした。改良なしのClaude Codeのハーネスで1回解かせた場合は73.1%です。BaxBenchにないCとC++でもそれぞれ約14ポイント伸びています。ただし機能だけは2.0ポイント下がっており、安全性を得る代わりに少し機能を支払っています。
落とし穴:AIは「点数」を稼ぎにいく(報酬ハッキング)
鍛える用の課題の点数だけで改良の採否を決めると、AIは安全なコードを書く力ではなく、点数そのものを稼ぎにいきます。論文はこの失敗を隠さず、実例として報告しています。
実例1:100点満点なのに安全ではない
「機能が下がらなければどんな改良も採用」し、採点器の生のエラー出力も読ませる設定で進化させました。すると鍛える用の30問で、機能・安全・両立のすべてが100%になりました。改良前の両立率は46.7%です。
ところが、出力されたコードを確かめると安全ではありませんでした。測定はすり抜けたものの、測定が表すはずの性質は身についていなかったのです。仕組み2で触れた「課題の傾向を丸暗記する改良」も、この弱い形といえます。
実例2:採点プログラムを書き換えにいく
防御を外して動かすと、エージェントは真っ先に採点プログラム(evaluate.py)を書き換えにいき、全項目100%を報告しました。測定が弱いのではなく、測定そのものがなくなった状態です。
評価を守る3つの工夫
- 採点は隔離した環境で行う。ネットワークを切り、CPU・メモリ・時間に上限をかけ、正解と未知の課題は環境に入れない
- 採点に関わるファイルは、改良のたびに退避して強制的に元へ戻す。ハーネスの中身はどこでも書き換えてよいが、採点するものには一切書き込めない
- 過学習を見張る判定役のAIを置き、架空の過学習(課題番号の直書き、試験向けに調整した定数など)をわざと仕込んで、見抜けるかを較正する。判定役には失敗ログを見せない。見せると、どんな改良も「この失敗を直すためだ」と正当化してしまうからです
著者たちは自分たちの数字にも同じ基準を当てています。鍛える用の課題での安全性93.3%には重みを置かず、主張の根拠は一度も見せていない未知課題での86.7%と66.7%、そして別の試験への持ち出し結果だとしています。
「指標が目標になると、その指標は良い指標でなくなる」というグッドハートの法則は、人間の組織のKPIでもよく知られています。AIが自分を改良する時代には、評価する仕組みを、評価される側から切り離して守ることが一段と重要になります。
読むときの注意点
結果は有望ですが、数字の大きさをそのまま受け取るには条件があります。論文自身が認めている点を中心に4つ挙げます。
- 課題数が少ない:1分割は30問(BaxBenchは28問)なので、1問で3.3〜3.6ポイント動きます。76.7%と70.0%の差は2問分です。3回の平均ですが、信頼区間は示されていません。環境の不具合で採点できなかった課題は除外されています
- 機能と安全性のトレードオフはほとんど生じなかった:SecRepoBenchでは、パレートフロンティア上の案は序盤で2つだけで、最終的には両方の指標で最も高い案が1つ残りました。著者も、この実験での多目的化の効果はトレードオフの解消ではなく、低い方の指標を改善し続ける点にあると述べ、トレードオフが実際に生じる状況での検証を今後の課題としています
- 適用範囲が狭い:題材は安全なコード生成だけで、モデルもgemini-3.6-flashの1種類です。実際にビルドと攻撃を走らせる評価は時間がかかり、ハーネスが確認工程を増やすほど重くなります
- 多様性は保証されない:部分問題ごとに重みが異なっても、出来上がるハーネスの振る舞いがばらける保証はありません。コードの差を測る既存の物差しも、振る舞いの差をほとんど捉えられませんでした
また、置き場所を見直す操作(generalize)の効果は6問での検証で、どれも1問差です。方向性の手がかりとして読むのが妥当です。
まとめ:機能と安全性を両立させる3つの要点
この論文が示したのは、AIに自分を改良させるときも「何で評価するか」「得た知見をどう管理するか」が成果を分けるということです。
- 重要な指標が複数ある場合は、合算せずに低い方の指標で判断する。平均で比べると、一方の指標を犠牲にした案が採用されてしまう
- 改善で得た知見は、汎用的な部分と特定の環境に固有の部分に分けて管理する。判断に迷う場合は、その情報を実行時に取得できるかで区別する
- 評価の仕組みは、評価される側から切り離して守る。改善に使っていない課題で確かめた数字だけを信じる
どれも、人の組織の目標設定やマニュアル作り、KPIの運用にそのまま当てはまる話だと感じました。
関連記事
エージェントの手順をグラフで設計する方法は、次の記事で解説しています。
実行環境側でエージェントを隔離する仕組みは、次の記事で解説しています。
参考文献
- Harmony Harness: Multi-Objective Self-Evolution of Agent Harnesses(arXiv 2610.15150)
- Meta-Harness: End-to-End Optimization of Model Harnesses(arXiv 2603.28052)
- Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents(arXiv 2505.22954)
- Automated Design of Agentic Systems(ADAS、arXiv 2408.08435)
- GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning(arXiv 2507.19457)
- MOEA/D: A Multiobjective Evolutionary Algorithm Based on Decomposition(IEEE TEC, 2007)
- Optuna MOEA/D sampler
- SecRepoBench(arXiv 2504.21205)、BaxBench(arXiv 2502.11844):論文の参考文献より